
Playco: GPT-6 Astra ने गेम प्रोटोटाइप की मैन्युअल ट्यूनिंग को आधा करने में मदद की
एक ही ग्रे मॉकअप से तीन थीम्ड वर्शन बनाए गए, और उनमें से ज़्यादातर पहली बार में ही काम कर गए। पिछले मॉडल की तुलना में मैन्युअल सुधारों की संख्या 50% कम हो गई, साथ ही स्थानिक तर्क, Unity में UI की रिस्पॉन्सिवनेस और गेम का अनुभव भी बेहतर हुआ।
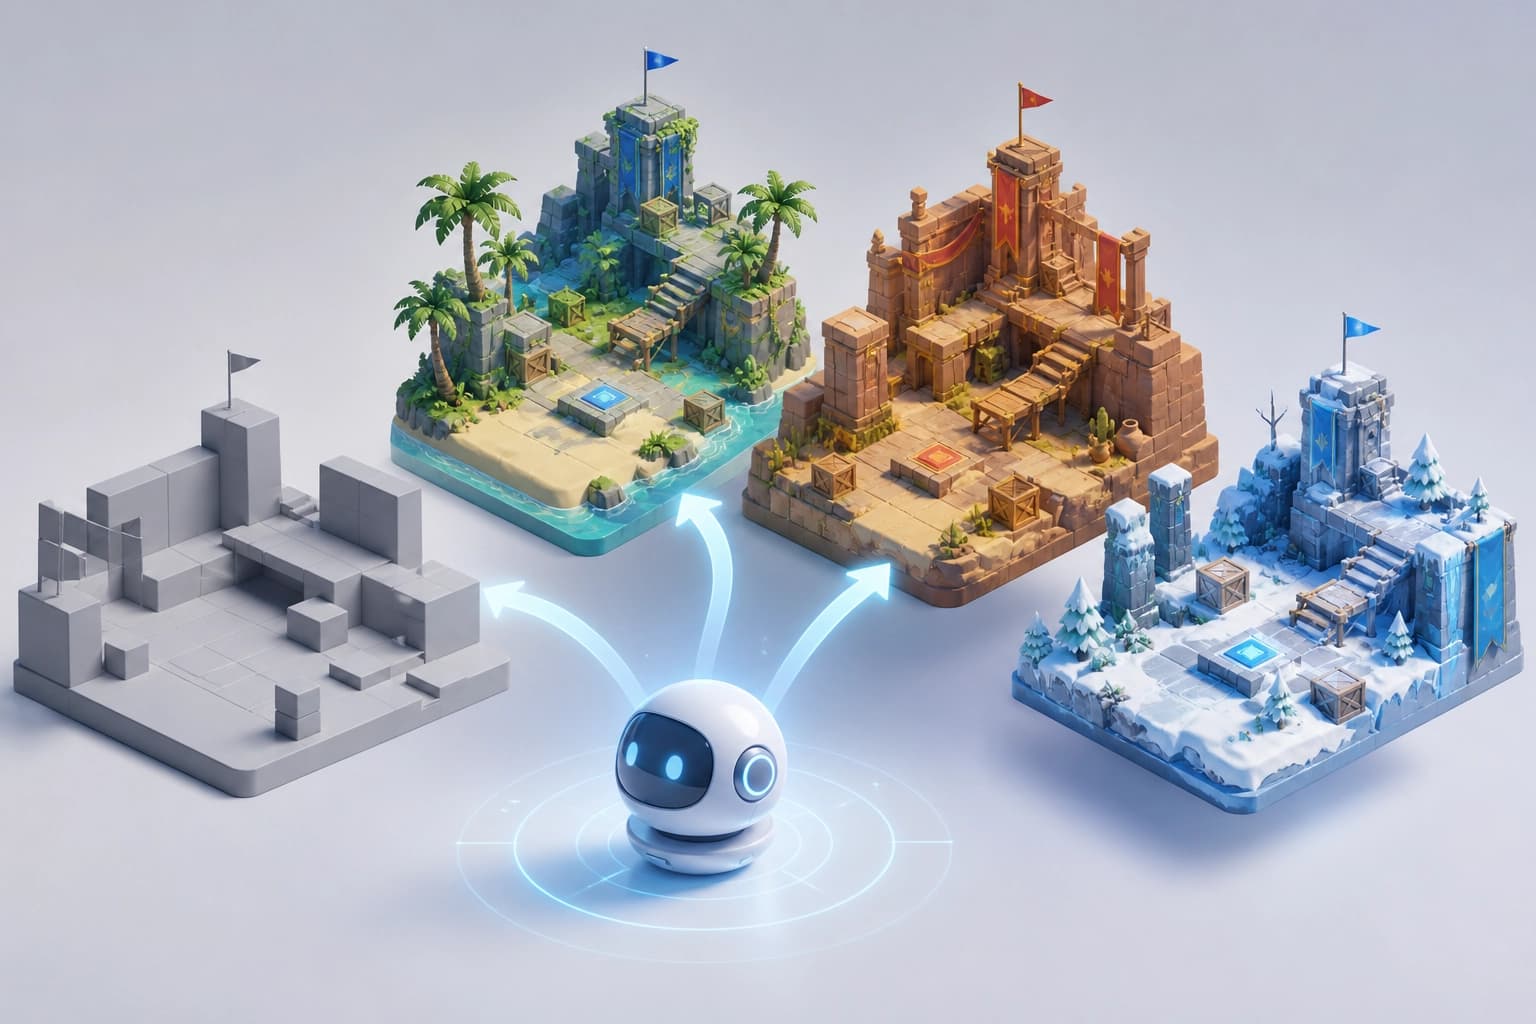
परिणाम: कम मैन्युअल संपादन, अधिक प्रोटोटाइप
Playco ने गेम प्रोटोटाइपिंग में मैन्युअल संपादन 50% तक कम किए। कंपनी ने GPT-6 Astra का उपयोग किया। पिछले मॉडल के साथ, टीम मैन्युअल सुधारों पर अधिक समय बिताती थी। नया परिणाम — एक ही ग्रे बॉक्स से तीन थीम्ड प्रोटोटाइप।
मुख्य आंकड़े:
- पिछले मॉडल की तुलना में 50% कम मैन्युअल सुधार।
- एक ही grey box से 3 थीम्ड गेम प्रोटोटाइप।
- अधिकांश प्रोटोटाइप पहले प्रयास में ही काम कर गए।
- एक साइबरपंक वेरिएंट में परफ़ॉर्मेंस सुधार की ज़रूरत पड़ी।
व्यावहारिक मानदंड: मैन्युअल संपादनों की हिस्सेदारी और साझा आधार से बनने वाले खेलने योग्य वेरिएंट की संख्या पर ध्यान दें। ये दो संकेतक सीधे बताते हैं कि मॉडल प्रोटोटाइपिंग को कितना तेज़ करता है।
एक grey box से तीन गेम दुनियाएँ
प्रक्रिया grey box से शुरू होती है — सरल प्रिमिटिव से बना बिना सजावट वाला प्रोटोटाइप। Playco टीम ने गेमप्ले और रचनात्मक विवरणों पर कई पुनरावृत्तियाँ कीं। फिर साझा आधार से तीन थीम्ड प्रोटोटाइप विकसित किए। GPT-6 Astra ने तीनों को एक ही पास में तैयार किया।
चरण:
- सरल प्रिमिटिव से grey box बनाएँ।
- गेमप्ले और विवरणों पर पुनरावृत्तियाँ करें।
- साझा आधार से तीन थीम्ड प्रोटोटाइप जनरेट करें।
- जाँचें कि अधिकांश पहले प्रयास में काम करते हैं।
- साइबरपंक संस्करण में परफ़ॉर्मेंस ठीक करें।
निष्कर्ष: एक आधार कई खेलने योग्य वेरिएंट देता है। टीम हर प्रोटोटाइप को शुरू से दोबारा बनाए बिना अधिक विचारों की तुलना कर सकती है। उपकरण चुनने का मानदंड — साझा आधार बनाए रखने और उससे अलग-अलग थीम उत्पन्न करने की क्षमता।
मॉडल के लिए केवल कोड लिखना क्यों पर्याप्त नहीं है
गेम डेवलपमेंट में मॉडल को स्थान, विज़ुअल संदर्भों, अनुकूली इंटरफ़ेस और game feel के बारे में सोचना होता है। यह समझना भी ज़रूरी है कि जब गेम खेला जाता है तो बदलाव काम करता है या नहीं। Playbot मॉडल को इंजन में बनाने, टेस्ट चलाने, बग खोजने और बनाई गई चीज़ को बेहतर करने की सुविधा देता है।
पिछले मॉडल और GPT-6 Astra की तुलना:
| मानदंड | पिछला मॉडल | GPT-6 Astra |
|---|---|---|
| मैन्युअल सुधार | इंजीनियर गेम को मैन्युअली ठीक करते थे | 50% कम |
| Grey box | कम परिष्कृत | पहला प्रोटोटाइप ही मज़बूत |
| स्थानिक सोच | — | बेहतर हुई |
| संदर्भों का पुनर्निर्माण | — | बेहतर हुआ |
| Unity में अनुकूली UI | — | बेहतर हुआ |
| Game feel | — | बेहतर हुआ |
| बग खोजना | — | आसान हुआ |
व्यावहारिक मानदंड: मॉडल को केवल कोड सुझाना ही नहीं, बल्कि इंजन में परिणाम जाँचना भी चाहिए। स्थानिक सोच, संदर्भों, UI और game feel में सुधार दिखाते हैं कि लाभ वास्तव में कहाँ बढ़ रहा है।
बदलावों की जाँच के लिए Playbot एक वातावरण के रूप में
Playco, Playbot के विकास में GPT-6 Astra का उपयोग करता है। यह पेशेवर गेम डेवलपर्स के लिए एक AI-powered IDE है। यह सीधे Unity और Godot जैसे इंजनों से जुड़ता है। AI मॉडल सीन संपादित कर सकते हैं, गेम खेल और टेस्ट कर सकते हैं, बदलाव जाँच सकते हैं और उन उपकरणों के भीतर समानांतर रूप से काम कर सकते हैं जो डेवलपर्स पहले से उपयोग करते हैं।
Playbot की क्षमताएँ:
- इंजन में सीन संपादित करना।
- गेम चलाना और टेस्ट करना।
- बदलावों की जाँच करना।
- मौजूदा उपकरणों के भीतर समानांतर काम करना।
Playbot मॉडल को गेम खेलने और अपने बदलावों को जाँचने की सुविधा देता है। इसलिए Astra को बग और खिलाड़ी के अनुभव को बेहतर करने के स्थान आसानी से मिले। चयन का मानदंड: उपकरण को मौजूदा इंजन में समाहित होना चाहिए और मॉडल को व्यवहार में परिणाम जाँचने का अवसर देना चाहिए।
विचारों के साथ काम करने का इसका क्या अर्थ है
Playco के लिए मुख्य प्रभाव — अधिक विचारों को उस चीज़ में बदलने की क्षमता जिसे डेवलपर्स खेल और तुलना कर सकें। कंपनी कहती है कि गेम के लिए दस विचार हों तो सभी दस बनाए जा सकते हैं। फिर उन्हें खेलकर देखा जा सकता है कि वे कैसे महसूस होते हैं, बजाय केवल कल्पना करने के।
व्यावहारिक मानदंड: उपकरण तब मूल्यवान है जब वह विचार से खेलने योग्य तुलना तक पहुँचने की प्रक्रिया को तेज़ करता है। यह केवल कोड जनरेट करने में ही नहीं, बल्कि यह जाँचने में भी मदद करता है कि बदलाव गेम में कैसा महसूस होता है। तब टीम हर प्रोटोटाइप पर कम मैन्युअल संपादन खर्च करती है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
RL सिम्युलेटरों की विफलताओं के निदान में कैनोनिकल बहुपद अपरिवर्तांक: वे वास्तव में कहाँ उपयोगी हैं
यह अध्ययन जाँचता है कि क्या सीखने योग्य गतिशीलता मॉडल में भौतिक नियमों को शामिल करना उचित है: प्रक्षेप पथों से निकाले गए और ग्रोबनर आधारों के माध्यम से विहित रूप में लाए गए अपरिवर्तक पूर्वानुमानों में मामूली सुधार देते हैं, लेकिन निदान में प्रभावी साबित होते हैं—वे उल्लंघित बाधा का स्थान निर्धारित करने और विशिष्ट गलत पैरामीटर की पहचान करने में सक्षम बनाते हैं।
10 नवम्बर 2026
AURA-Eval: कैसे जाँचें कि LLM एजेंट ने जोखिम को पहचाना और अगला कदम बदल दियाેણ
यह फ्रेमवर्क LLM एजेंटों के व्यवहार का आकलन अंतिम निर्णय के आधार पर नहीं, बल्कि अहम बिंदुओं पर जोखिम के प्रति उनकी प्रतिक्रिया के आधार पर करता है: टूल-कॉल की ट्रैजेक्टरी बीच में रोक दी जाती हैं, जिसके बाद मॉडल को अपना तर्क और कार्रवाई जारी रखनी होती है, जबकि LLM जजों का एक पैनल जोखिम की पहचान, कदम की प्रकृति और उसकी सुरक्षा का विश्लेषण करता है। R-Judge की 157 ट्रैजेक्टरी से संकलित 1249 कार्यों में, 20 मॉडलों में सुरक्षित रास्ता न होने पर असुरक्षित कार्रवाइयाँ बढ़ जाती हैं, और निष्पादन से पहले निगरानी हटाने पर शुरुआत में सुरक्षित रहे 52,3% मामले असुरक्षित हो जाते हैं।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026