
बैकडोर पाइपलाइन से आता है, उपयोगकर्ता से नहीं
मल्टीमॉडल मॉडल अनुप्रयोग-परिदृश्यों में और गहराई से समाहित हो रहे हैं: वे स्क्रीनशॉट पढ़ते हैं, उत्पादों की तस्वीरों का विश्लेषण करते हैं, दस्तावेज़ों के स्कैन पर प्रश्नों के उत्तर देते हैं। सुविधा के साथ-साथ उत्पाद में दूसरों की भेद्यता भी आ जाती है। मॉडल तैयार घटकों से बनाया जाता है — एक विज़ुअल एनकोडर, एक प्रोजेक्शन, एक भाषा-भाग — और संयोजन के हर चरण में वहाँ कोई छिपा ट्रिगर घुस सकता है। कभी वह किसी चित्र में छिपा होता है, कभी पाठ में, और कभी उसे दोनों संकेतों के संयोजन की आवश्यकता होती है।
इसके बाद अप्रिय हिस्सा शुरू होता है। जो उपकरण "ज़हरीले" क्लासिफायरों से काफ़ी अच्छी तरह निपटते थे, वे मल्टीमॉडल मॉडलों पर स्पष्ट रूप से कमज़ोर पड़ जाते हैं: बहुत अधिक परतें, बहुत भिन्न मोडलिटीज़, निरूपणों की बहुत जटिल आंतरिक ज्यामिति। और जो समाधान विशेष रूप से MLLM के लिए बनाए गए, वे अधिकतर इनपुट पर ही काम करते हैं — संदिग्ध अनुरोधों को नेटवर्क तक पहुँचने से पहले ही छान देते हैं। फ़िल्टर किसी विशिष्ट हमले को रोक सकता है, लेकिन संक्रमण स्वयं भारों में बना रहता है। फ़िल्टर को bypass करना हमलावर की रचनात्मकता का प्रश्न है।
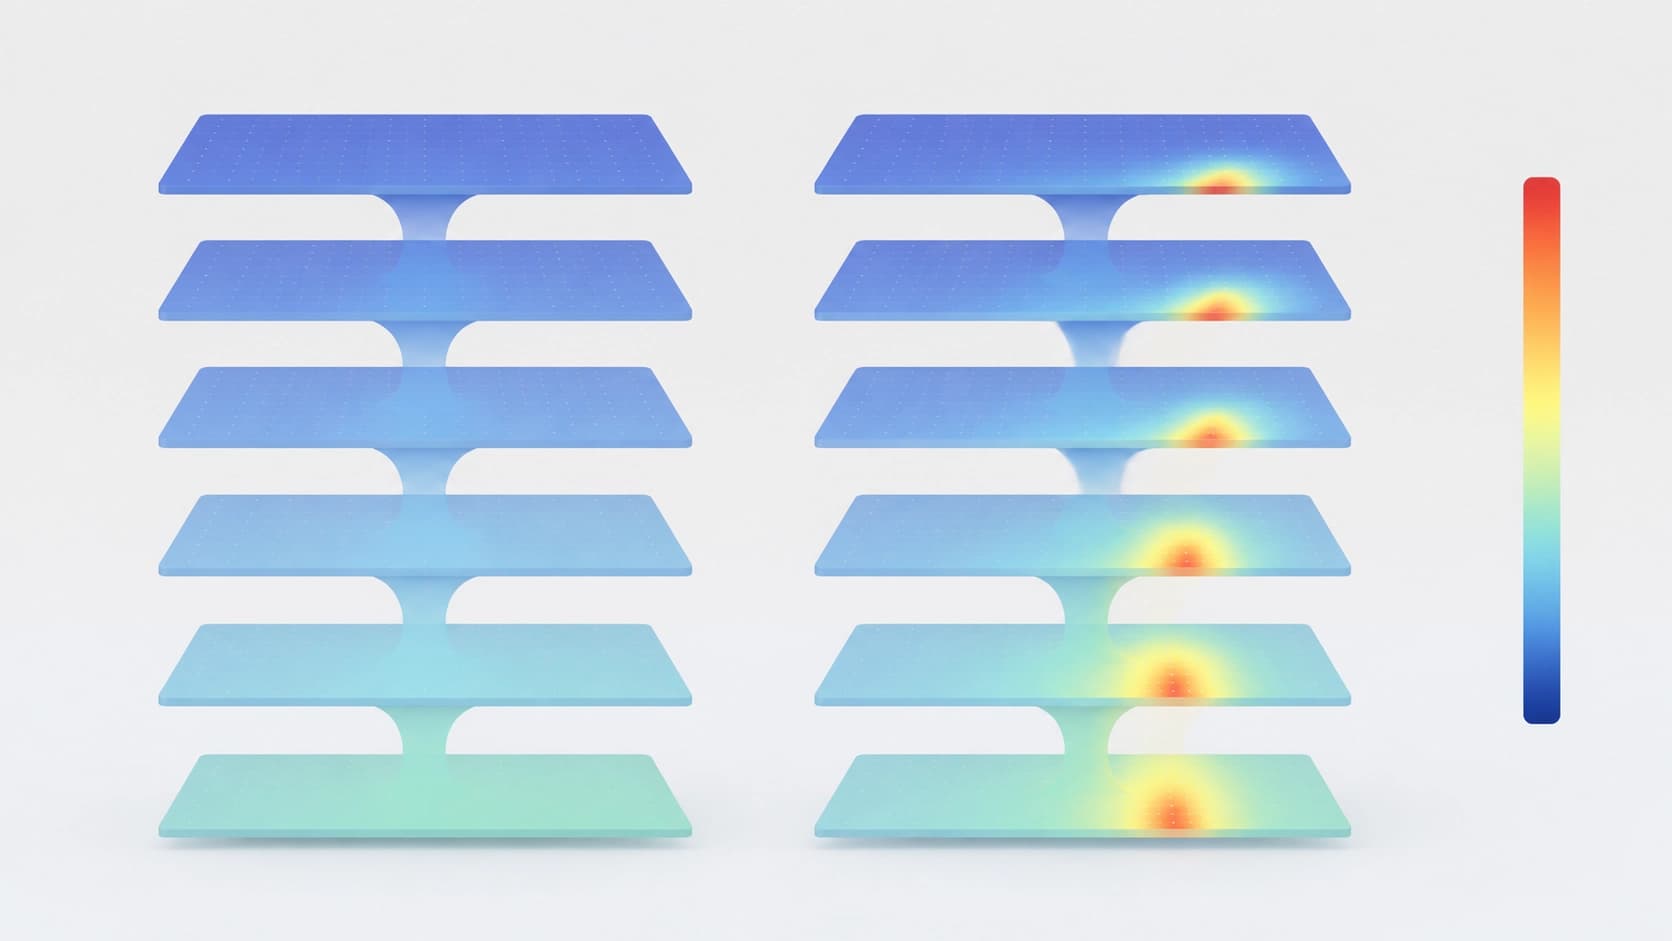
परत-वार असंगति हमले की छाप के रूप में
arXiv:2608.24354 (Jiali Wei और आठ अन्य सह-लेखक; श्रेणियाँ cs.CR, cs.AI, cs.CL, प्रस्तुति — अगस्त 2026) के लेखकों ने उस बात पर ध्यान दिया जिसे केवल इनपुट और आउटपुट देखते हुए आसानी से छोड़ा जा सकता है। बैकडोर किसी एक परत में नहीं, बल्कि एक प्रक्षेपपथ में निशान छोड़ता है: परत-दर-परत गुज़रते समय निरूपण असामान्य रूप से बदलते हैं। इसे परत-वार असंगति विसंगति कहा गया।
मुख्य बारीकी — विसंगति पूरे नेटवर्क में समान रूप से फैली हुई नहीं है। यह मोडलिटी से बँधी है और, इससे भी महत्वपूर्ण, टोकन के उस क्षेत्र में स्थानीयकृत है जहाँ ट्रिगर का लक्षण बैठा है। दूसरे शब्दों में, मॉडल निरूपण के एक संकीर्ण हिस्से पर "टिका" रहता है, और ठीक वहीं वह विचलन उत्पन्न होता है जो स्वच्छ डेटा पर कभी नहीं होता।
इससे व्यावहारिक निष्कर्ष निकलता है: यदि असंगति को पूरे निरूपण पर औसत किया जाए, तो संकेत उपयोगी लक्षणों के शोर में घुल जाता है। पहले उसे अलग करना ज़रूरी है जिसे मॉडल पहले ही मिला चुका है।
RACER कैसे बना है
मोडलिटीज़ के अनुसार विभाजन
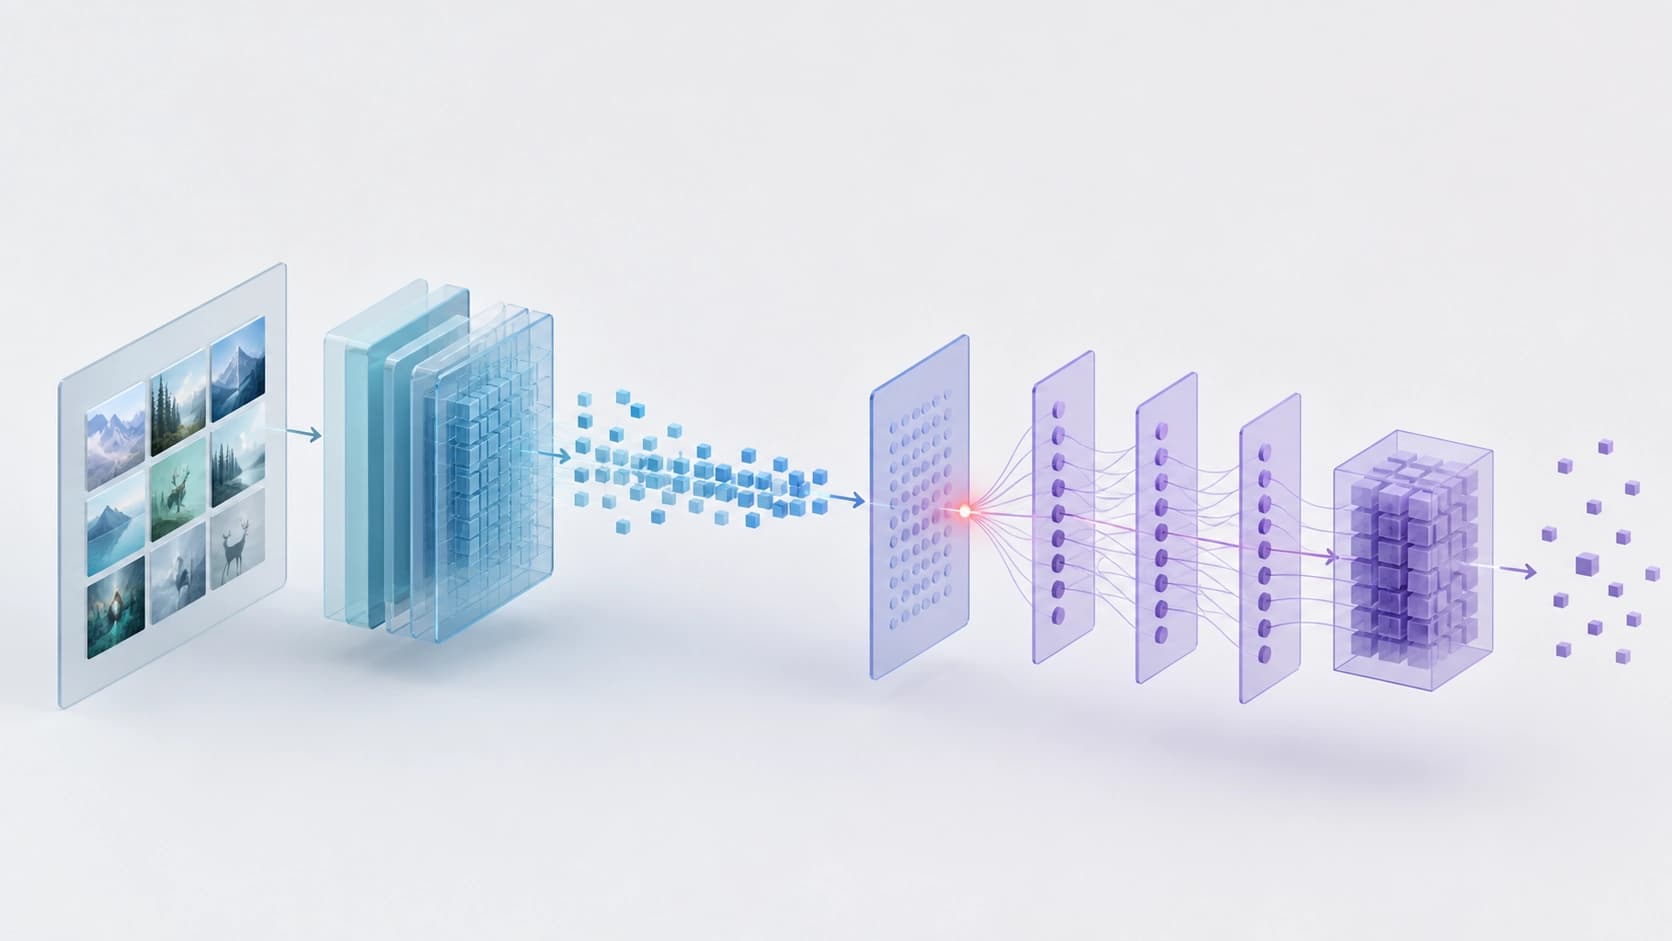
मॉडल-स्तर पर पुनर्स्थापन फ़्रेमवर्क — इन्फ़रेंस के ऊपर एक अधिसंरचना नहीं — का नाम RACER (Region-Aware Consistency Repair) रखा गया। तर्क यह है: संयुक्त निरूपण को वापस विज़ुअल और टेक्स्ट टोकन-क्षेत्रों में विभाजित किया जाता है, प्रत्येक के लिए अलग-अलग परत-वार असंगति की गणना की जाती है, और फिर उन्हें वापस जोड़ा जाता है, लेकिन अब ऐसे भारों के साथ जो मोडलिटी को ध्यान में रखते हैं। काम गहरी परतों की एक विंडो में होता है — वहाँ, जहाँ स्थिर, दिशात्मक विचलन बनते हैं।
परिणाम — क्षेत्र-सजग उद्देश्य फलन। यह पूरे वेक्टर के सामान्य मीट्रिक की तुलना में स्थानीय विसंगतियों के प्रति अधिक संवेदनशील है, और उपयोगी लक्षणों को बैकडोर के संकेत को दबाने नहीं देता।
साधारण फ़ाइन-ट्यूनिंग के बजाय min-max
इसके बाद प्रतिस्पर्धात्मक योजना सक्रिय होती है। min-max अनुकूलन के माध्यम से फ़्रेमवर्क पहले सबसे बुरा विक्षोभ खोजता है — वह जो पाई गई असंगति को अधिकतम रूप से बढ़ाता है — और फिर मॉडल को इस तरह फ़ाइन-ट्यून करता है कि यह विक्षोभ उसे तोड़ न सके। सरल शब्दों में: वे स्वयं पर हमला करते हैं ताकि निरूपण की उन दिशाओं को सख़्त कर सकें जिन पर हानिकारक व्यवहार टिका है।
व्यावहारिक पक्ष तकनीकी से कम महत्वपूर्ण नहीं है। विधि को केवल 100 स्वच्छ उदाहरण चाहिए। इसे न स्वयं ट्रिगर जानने की आवश्यकता है, न हमले का लक्ष्य लेबल, और न ही यह कि प्रस्तुत मॉडल संक्रमित है या नहीं। यह मूलभूत है: सुरक्षा "हमले का अनुमान लगाओ" वाले कार्य में नहीं बदलती।
मापनों ने क्या दिखाया
लेखकों ने विधि को तीन खुले मल्टीमॉडल मॉडलों पर बैकडोर की 36 कॉन्फ़िगरेशनों में चलाया — छवि में, पाठ में और एक साथ दोनों चैनलों में ट्रिगरों के साथ। औसत ASR (उन मामलों का अनुपात जब हमला फिर भी सफल हो जाता है) को 1.1% तक लाने में सफलता मिली, और 36 में से 32 कॉन्फ़िगरेशनों में यह संकेतक शून्य तक गिर गया।
दूसरा परिणाम कम महत्वपूर्ण नहीं है, हालाँकि इसकी चर्चा कम होती है: स्वच्छ कार्यों पर उपयोगिता बनी रहती है। और यह संक्रमित मॉडलों में भी, और शुरू से स्वच्छ मॉडलों में भी — यानी पुनर्स्थापन किसी कार्यशील मॉडल को सतर्क लेकिन बेकार में नहीं बदलता। यह आक्रामक सफ़ाई विधियों की सामान्य कीमत है, और यहाँ मापनों के अनुसार इसे टाला जा सका।
यह व्यवहार में क्या बदलता है
इनपुट फ़िल्टरिंग और भार-पुनर्स्थापन के बीच का अंतर अकादमिक नहीं है। फ़िल्टर मॉडल के आसपास की अधिसंरचना में रहता है: उसे बनाए रखना पड़ता है, नए प्रकार के हमलों के अनुसार अद्यतन करना पड़ता है, और फिर भी किसी अन्य चैनल से bypass किया जा सकता है। भार-स्तर पर सुधार लक्षण नहीं, कारण को हटाता है, और इन्फ़रेंस में विलंब नहीं जोड़ता।
एक व्यापक कथा भी है। हम मॉडल की सुरक्षा को परीक्षणों पर उसके उत्तरों से आँकने के आदी हैं, लेकिन RACER दिखाता है कि सूचनापूर्ण संकेत मध्यवर्ती निरूपणों में छिपा है — इसमें कि नेटवर्क कैसे सोचता है, न कि वह क्या कहता है। यदि यह दृष्टिकोण परीक्षित तीन आर्किटेक्चरों से आगे मापनीय होता है, तो MLLM आपूर्तिकर्ताओं के पास स्वच्छता का अपेक्षाकृत सस्ता कदम आ जाता है: सौ स्वच्छ उदाहरण और भार प्रकाशित करने से पहले थोड़ी गणना। सीमाएँ भी स्पष्ट हैं — यह कार्य हमलों के एक विशिष्ट वर्ग को देखता है और मॉडल के आंतरिक भागों तक पहुँच की माँग करता है, इसलिए बंद API-मॉडलों के लिए यह योजना सीधे लागू नहीं होती।


