
जनरेटिव इमेज मॉडल का फ़ाइन-ट्यूनिंग: प्राथमिकताओं और श्रेणियों पर संयुक्त विचार
यह लेख खुले डोमेन में text-to-image मॉडलों की पोस्ट-ट्रेनिंग की एक विधि का वर्णन करता है, जिसमें मानवीय प्राथमिकताओं के संकेत को प्रॉम्प्ट के अनुरूपता और वांछित गुणों की रूब्रिक-आधारित जाँचों से पूरक किया जाता है। परिणामों से पता चलता है कि पुरस्कारों का भारित औसत प्रस्तावित योजना से कमतर है, जबकि Arena के स्नैपशॉट में फ़ाइन-ट्यून किए गए Flux2dev और Ideogram-4 का Elo स्कोर उल्लेखनीय रूप से बढ़ा हुआ दिखता है।
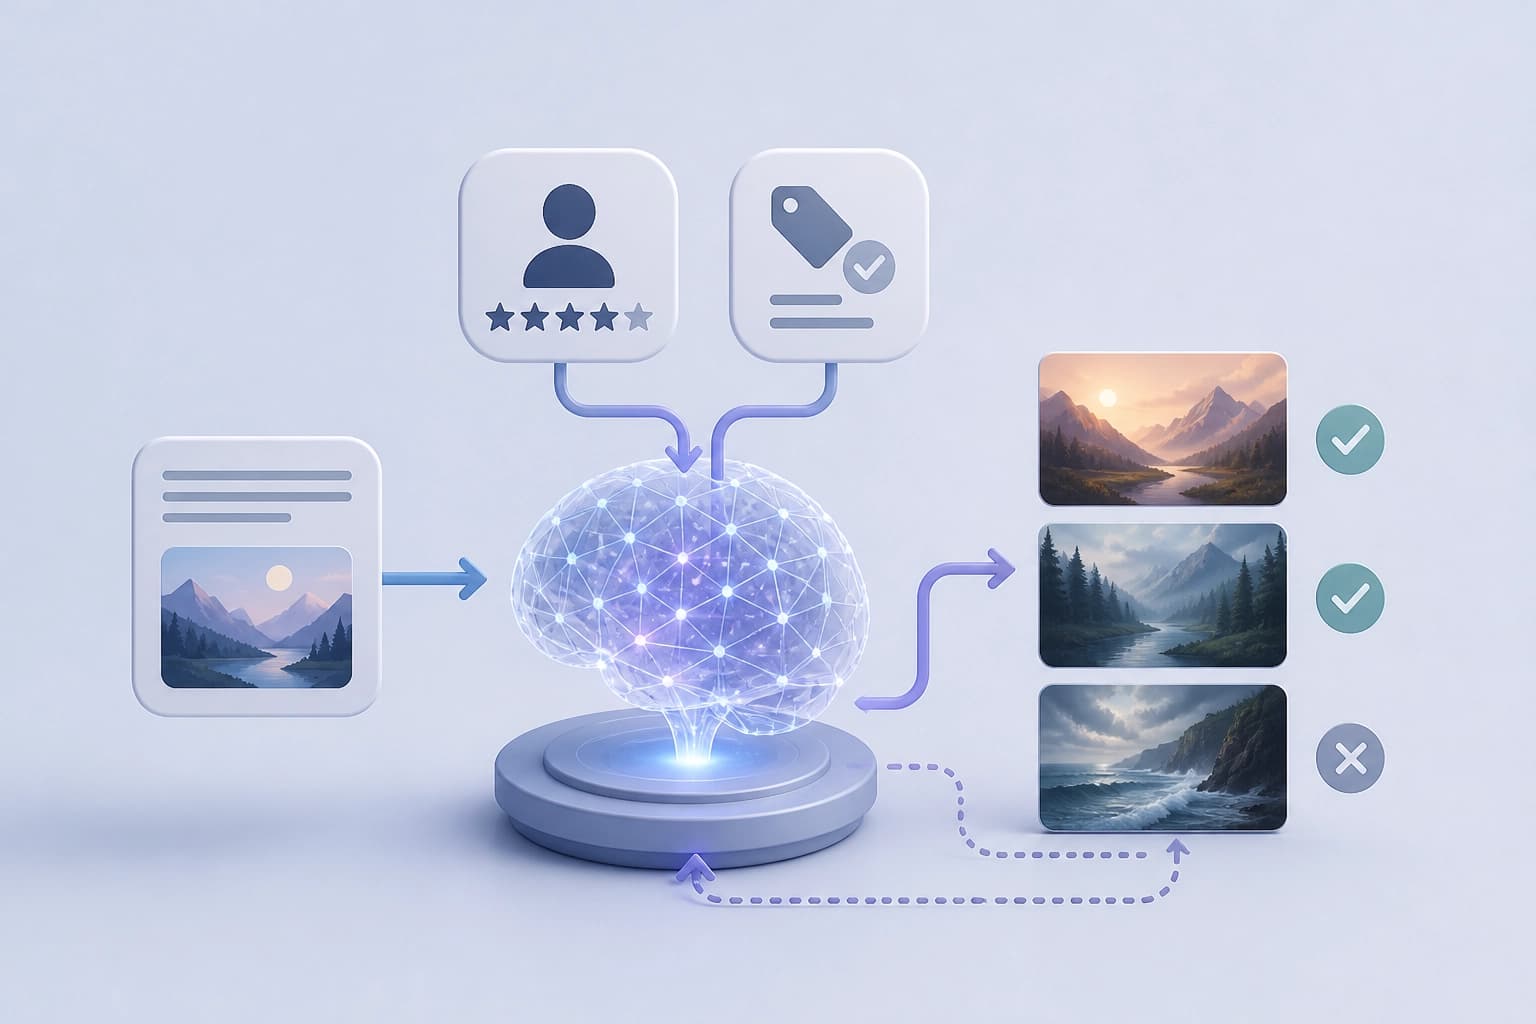
कार्य: ओपन डोमेन और दो संकेत
ओपन डोमेन में टेक्स्ट से इमेज जनरेट करने के लिए अलग-अलग आवश्यकताओं का ध्यान रखना पड़ता है। इनमें प्रॉम्प्ट के अनुरूपता और मानवीय प्राथमिकताएँ शामिल हैं। एक रिवॉर्ड सिग्नल दोनों तरह की आवश्यकताओं को पूरा नहीं कर सकता। «Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards» नामक शोध-पत्र पूरक संकेतों के संयोजन पर पोस्ट-ट्रेनिंग का प्रस्ताव देता है।
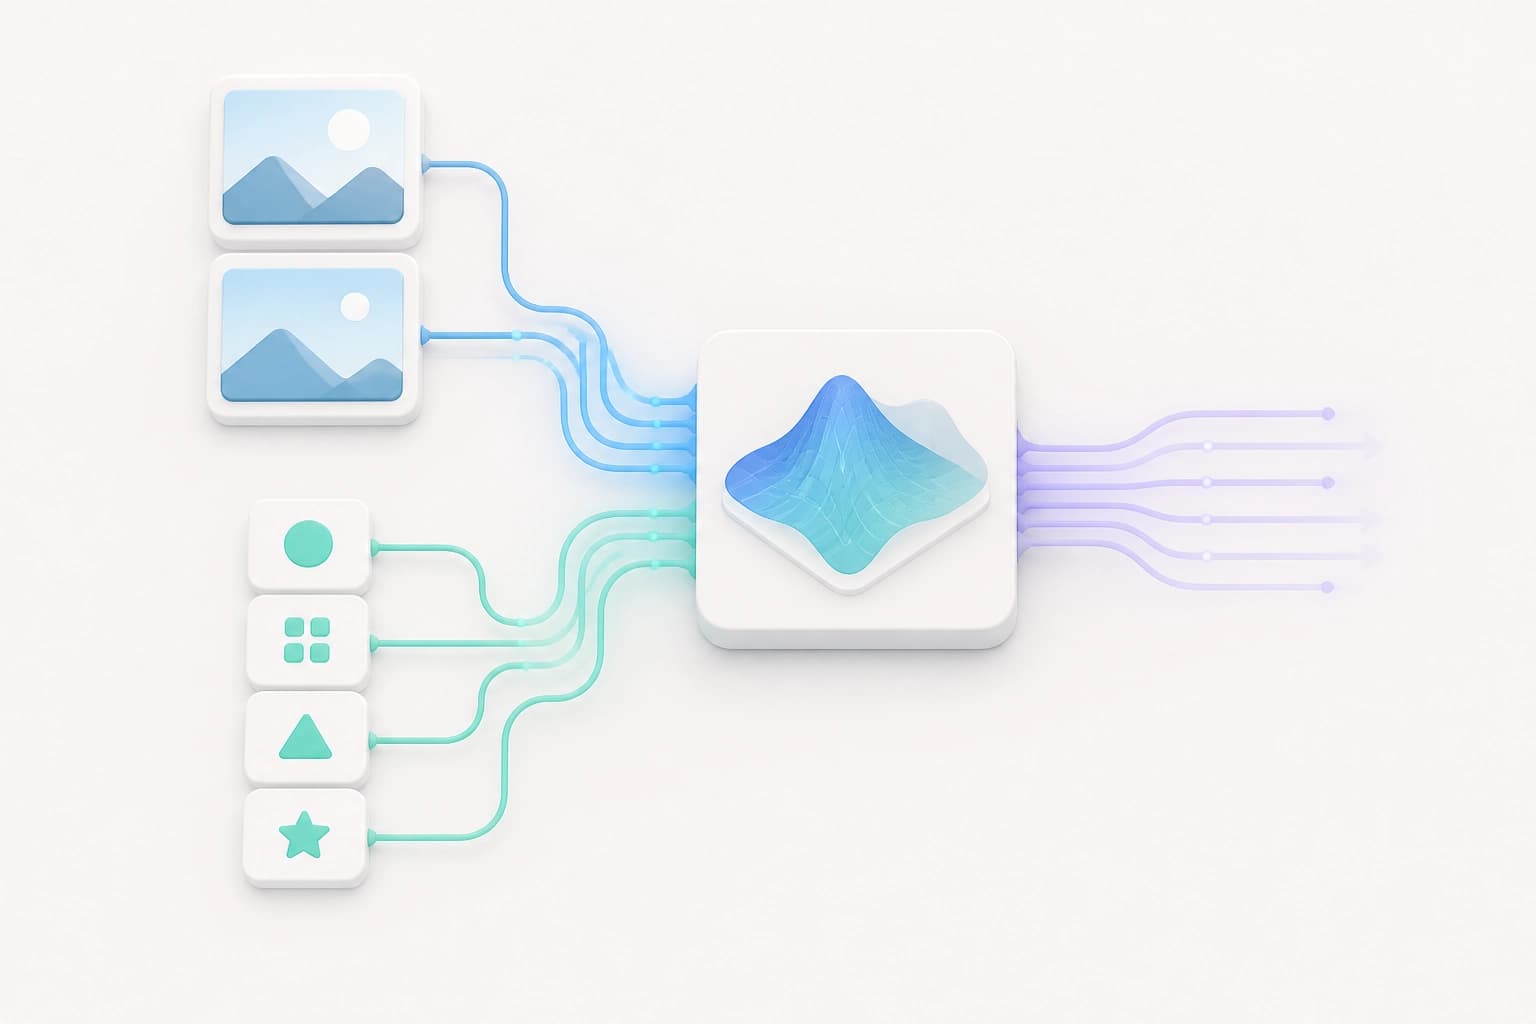
यह विधि प्राथमिकताओं के लिए रिवॉर्ड और रूब्रिक-आधारित रिवॉर्ड को जोड़ती है। पहला सिग्नल मानवीय प्राथमिकताओं को दर्शाता है। दूसरा प्रॉम्प्ट के अनुरूपता और अन्य वांछनीय गुणों की जाँच करता है। यह संयोजन अनुरोध के अलग-अलग पहलुओं को पूरा करता है। निष्कर्ष: ओपन डोमेन के लिए चयन का मानदंड एक संकेत नहीं, बल्कि एक-दूसरे के पूरक संकेतों की मौजूदगी है। उन्हें व्यक्तिपरक चयन और कार्य-पूर्ति, दोनों को कवर करना चाहिए।
रिवॉर्ड सिस्टम की संरचना
सिस्टम में दो मुख्य घटक हैं। प्राथमिकताओं के लिए रिवॉर्ड को बड़े पैमाने पर एकत्र किए गए मानवीय प्राथमिकताओं के डेटा पर प्रशिक्षित किया जाता है। प्रशिक्षण के लिए Bradley-Terry objective का उपयोग किया जाता है। यह सिग्नल लोगों की पसंद को दर्शाता है।
रूब्रिक प्रॉम्प्ट के अनुरूपता और अन्य वांछनीय गुणों का मूल्यांकन करते हैं। वे reward hacking से बचाव भी करते हैं। ये घटक अलग-अलग काम करते हैं और एक-दूसरे के पूरक हैं।
| घटक | किस पर आधारित है | क्या जाँचता है | भूमिका |
|---|---|---|---|
| प्राथमिकताओं के लिए रिवॉर्ड | बड़े पैमाने पर एकत्र किए गए मानवीय प्राथमिकताओं के डेटा, Bradley-Terry objective | परिणामों की तुलना करते समय लोगों की पसंद | प्राथमिकताओं का अनुकूलन |
| रूब्रिक-आधारित रिवॉर्ड | मानदंडों वाले रूब्रिक | प्रॉम्प्ट के अनुरूपता और अन्य वांछनीय गुण | reward hacking से बचाव |
लेखक प्रभावी रिवॉर्ड के लिए आवश्यकताएँ बताते हैं। उन्हें उपयोगकर्ताओं के इरादों को व्यापक रूप से कवर करना चाहिए। उन्हें अनुकूलन के दौरान दुरुपयोग के प्रति मज़बूत होना चाहिए।
निष्कर्ष: चयन का मानदंड यह है कि रूब्रिक प्राथमिकताओं के पूरक हों, उनका स्थान न लें। रूब्रिक के बिना सिस्टम reward hacking से बचाव खो देता है। प्राथमिकताओं के बिना सिस्टम मानवीय पसंद पर आधारित नहीं होता।
साधारण औसत के बजाय संयोजन
लेखक बताते हैं कि भोले भारित औसत में समस्या है। अनुकूलन के दौरान ऐसा औसत अवांछनीय व्यवहार पैदा करता है। यह शोध-पत्र रिवॉर्ड को संयोजित करने की एक रणनीति प्रस्तुत करता है। यह प्राथमिकताओं के अनुकूलन और रूब्रिक के अनुपालन के बीच अधिक प्रभावी ढंग से संतुलन बनाती है।
| दृष्टिकोण | अनुकूलन के दौरान क्या होता है |
|---|---|
| भोला भारित औसत | व्यवहार अवांछनीय हो जाता है |
| संयोजन रणनीति | प्राथमिकताओं का अनुकूलन और रूब्रिक का अनुपालन अधिक प्रभावी ढंग से संतुलित होता है |
संयोजन रणनीति विधि का एक अलग हिस्सा बन जाती है। निष्कर्ष: चयन का मानदंड संयोजन रणनीति की मौजूदगी है, सिर्फ़ रिवॉर्ड के समूह की नहीं। रणनीति के बिना संकेतों के भार वांछित व्यवहार की गारंटी नहीं देते।
Arena text-to-image रैंकिंग में नतीजे
Arena text-to-image रैंकिंग में Flux2dev मॉडल ने बेसलाइन से 69 अंक अधिक Elo प्राप्त किया। मॉडल को RL-प्रशिक्षण दिया गया। पोस्ट-ट्रेनिंग के बाद Ideogram-4 मॉडल ने सभी ओपन-सोर्स मॉडलों को पीछे छोड़ दिया। उसका Elo 1223.5 था।
ये आँकड़े रैंकिंग के संदर्भ में पोस्ट-ट्रेनिंग के प्रभाव को दिखाते हैं। ये अन्य उपयोग परिदृश्यों का वर्णन नहीं करते।
| मॉडल | नतीजा | किससे तुलना की गई |
|---|---|---|
| RL-प्रशिक्षित Flux2dev | Elo में 69 अंक अधिक | बेसलाइन मॉडल |
| पोस्ट-ट्रेंड Ideogram-4 | Elo 1223.5 | सभी ओपन-सोर्स मॉडल |
निष्कर्ष: मूल्यांकन का मानदंड बेसलाइन मॉडल और प्रशिक्षण की शर्तों को देखना है। Flux2dev के लिए लेखक बेसलाइन की तुलना में सुधार बताते हैं। Ideogram-4 के लिए वे ओपन मॉडलों के बीच उसकी स्थिति दर्ज करते हैं।
रैंकिंग और डेटा स्नैपशॉट की सीमाएँ
अग्रणी नतीजों के दावे 4 सितंबर 2026 के Arena स्नैपशॉट से संबंधित हैं। यह स्नैपशॉट उस तारीख की रैंकिंग की स्थिति दर्ज करता है। लेखकों ने Arena-T2I-Training जारी किया। यह 1K आकार का प्रशिक्षण डेटा सबसेट है।
इससे पूरे प्रशिक्षण के कुछ सुधारों को फिर से प्राप्त किया जा सकता है। कुछ सुधार इस सबसेट में शामिल नहीं हैं। विधि की जाँच के लिए पूरे नतीजे को पुनरुत्पादित किए जा सकने वाले हिस्से से अलग रखना ज़रूरी है।
निष्कर्ष: चयन का मानदंड स्नैपशॉट की तारीख और पुनरुत्पादित किए जा सकने वाले हिस्से की सीमाओं को ध्यान में रखना है। इन सीमाओं के बिना दावा अधूरा रहता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
Zero2Repo बेंचमार्क: खाली डायरेक्टरी से स्वायत्त रूप से प्रोजेक्ट बनाने की सीमाएँ
अध्ययन में कोडिंग एजेंटों का मूल्यांकन पूरे रिपॉज़िटरी को बिल्ड करके करने का प्रस्ताव है: इनपुट में विनिर्देश, इंटरफ़ेस कॉन्ट्रैक्ट और खाली वातावरण हो, जबकि जाँच LLM-जज के बिना छिपे हुए टेस्ट से की जाए। अग्रणी एजेंट भी शायद ही सभी जाँचों में सफल होते हैं, और ज़्यादातर विफलताएँ आवश्यकताओं के कुछ अलग-अलग बिंदुओं के छूट जाने के कारण होती हैं।
13 नवम्बर 2026
FedSocket: बहुमाध्यमीय विषमता में प्राप्तकर्ता-पक्ष पर अनिवार्य निष्पादन-क्षमता वाले विनिमेय मॉडल
FedSocket का प्रस्ताव है—एक ऐसा दृष्टिकोण जिसमें साझा किया जाने वाला मॉडल प्राप्तकर्ता की ओर से गणना योग्य होना चाहिए, और विषम निजी मॉडलों को पूर्वानुमानों के साझा इंटरफ़ेस Q से जोड़ा जाता है। लेख में सदस्यता को ध्यान में रखकर किए जाने वाले एग्रीगेशन, केवल Q के पैरामीटर और काउंटरों को अग्रेषित करने, तथा छह डेटासेट पर किए गए प्रयोगों का वर्णन है, जो अनुपलब्ध मॉडैलिटीज़ के बावजूद सटीकता में वृद्धि और स्वतंत्र एन्सेम्बल की तुलना में Joint-इन्फ़रेंस की श्रेष्ठता दर्शाते हैं।
13 नवम्बर 2026
CyberArena: AI एजेंटों के युग्मित मुकाबले स्थिर साइबर बेंचमार्क की सीमाएँ उजागर करते हैं
यह बेंचमार्क दो एजेंटों को लगातार बदलती सेवाओं वाले सैंडबॉक्स में रखता है और कई राउंड के बाद उनके कार्यों को आक्रामक और रक्षात्मक कौशल के बहुआयामी स्कोर में बदलता है। 12 आधुनिक मॉडलों के साथ 466 मैचों में इसने उन क्षमताओं के बीच अंतर पहचाना, जहाँ एकतरफ़ा परीक्षण अपनी सीमा पर पहुँच जाते हैं—जिनमें कई चालों की योजना बनाना और बैकडोर बनाना शामिल है।
13 नवम्बर 2026