
खरगोश बाघ का पीछा करता है: खुले मल्टीमॉडल मॉडल अपनी ही आँखों पर विश्वास क्यों नहीं करते
चीन के शोधकर्ताओं ने 400 सिंथेटिक दृश्यों से CAIT बेंचमार्क तैयार किया, जिनमें दिखाया गया दृश्य रोज़मर्रा की अपेक्षाओं के विपरीत है — जैसे शिकार का शिकारी का पीछा करना। पता चला कि इंसान और शीर्ष प्रोप्राइटरी मॉडल ऐसे फ़्रेमों को पहचान लेते हैं, जबकि सामान्य instruction-ट्यूनिंग वाले ओपन-सोर्स MLLM लगभग अनुमान से जवाब देते हैं और जो देखा है उसे परिचित टेक्स्ट टेम्पलेट्स से बदल देते हैं।
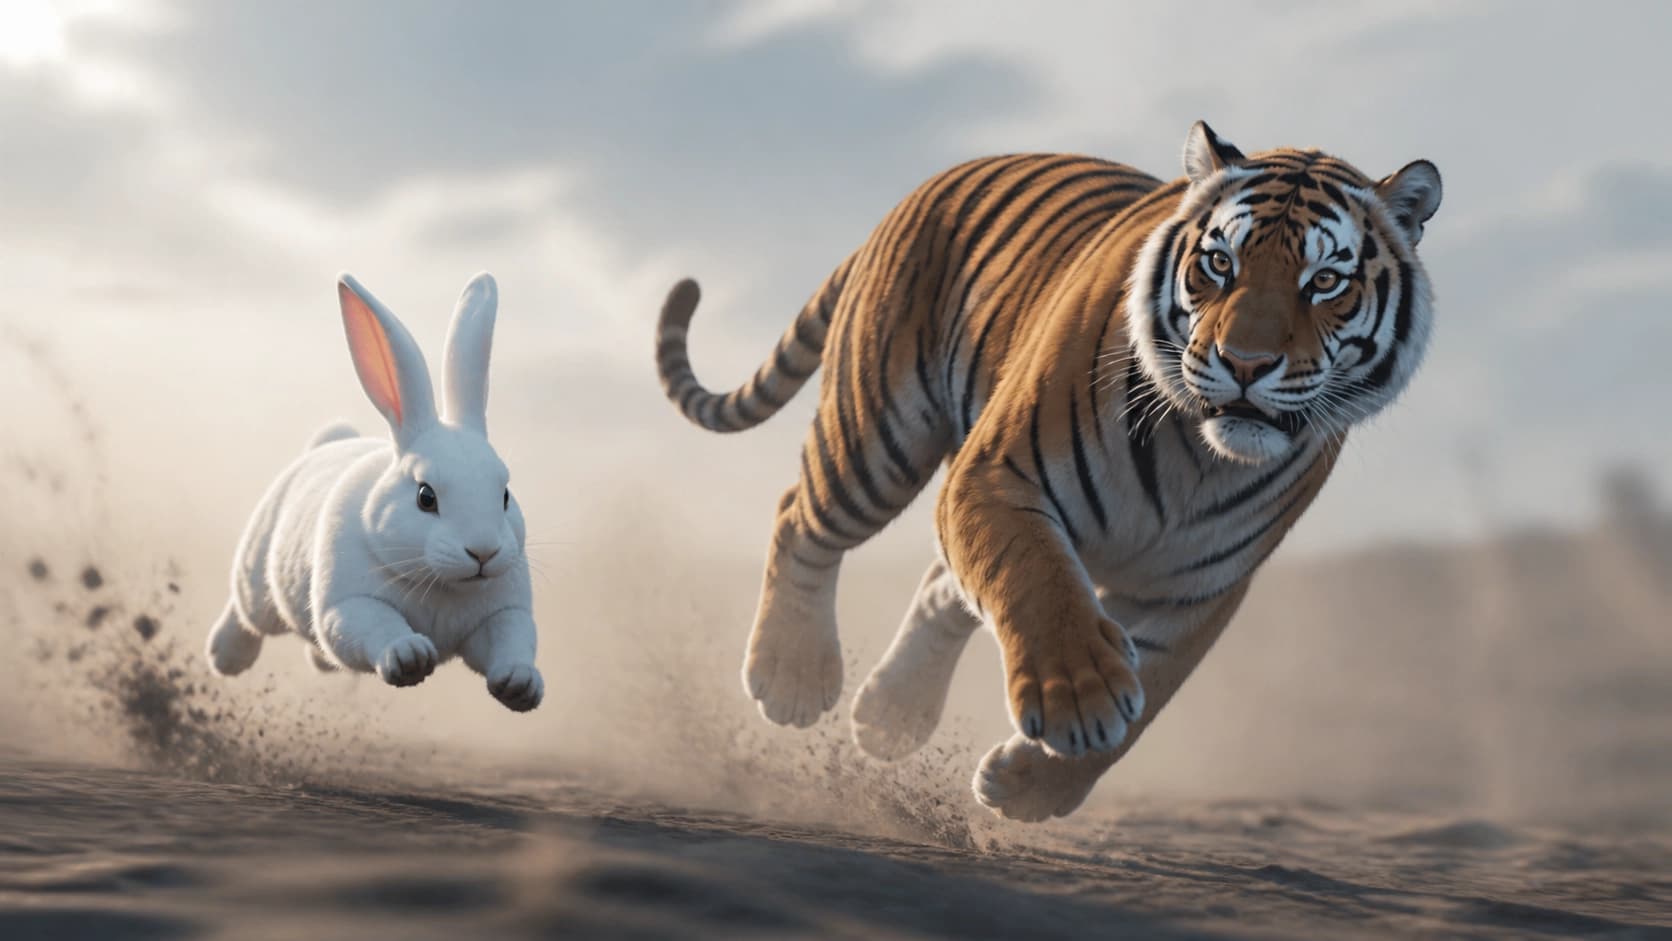
खरगोश बाघ का पीछा कर रहा है: वह परीक्षण जिसने अंधे धब्बे को उजागर किया
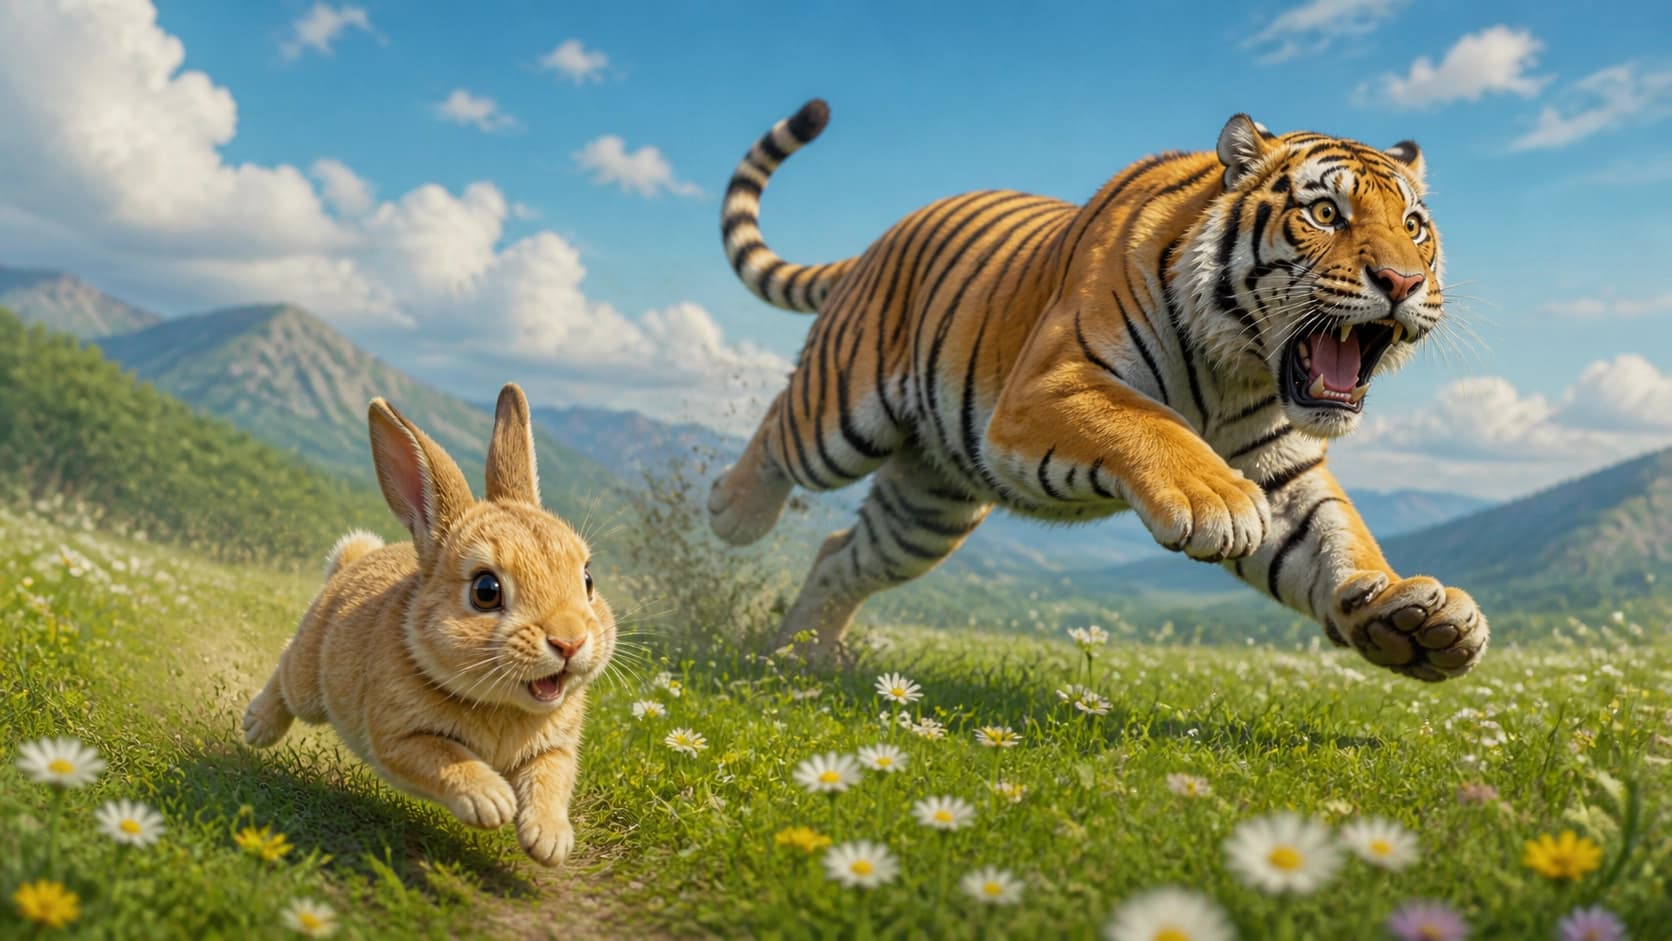
एक तस्वीर की कल्पना कीजिए: एक खरगोश घास के मैदान में दौड़ रहा है, और उसके आगे एक बाघ भाग रहा है। रचना सुव्यवस्थित है, विवरण स्पष्ट हैं, कोई अस्पष्टता नहीं — दृश्य रूप से सब कुछ स्पष्ट है। और फिर भी, कई ओपन मल्टीमॉडल मॉडल इस दृश्य का वर्णन उल्टा कर देते हैं। इसलिए नहीं कि वे ठीक से देख नहीं पाते, बल्कि इसलिए कि वे जो देखते हैं उस पर विश्वास नहीं करते।
यही विरोधाभास शोध पत्र «Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes» (arXiv:2601.07737, लेखक Chen Ling, Tongwei Zhang, Hanqian Li और Nai Ding) में विश्लेषित किया गया है। यह कार्य जनवरी 2026 में प्रकाशित हुआ और तब से दो बार अद्यतन किया गया है — अंतिम संशोधन अगस्त का है। औपचारिक रूप से यह कंप्यूटर विज़न पर एक लेख है, लेकिन इसके निष्कर्ष कहीं अधिक व्यापक हैं: वे आधुनिक मल्टीमॉडल सहायकों की बनावट के मूल तर्क पर प्रहार करते हैं।
वास्तव में क्या परखा गया
मल्टीमॉडल मॉडल लंबे समय से «मुख्यधारा» के कार्यों को आत्मविश्वास के साथ हल करते आ रहे हैं: किसी तस्वीर का वर्णन करना, पाठ्य क्वेरी से किसी वस्तु को खोजना, किसी आरेख पर आधारित प्रश्न का उत्तर देना। लेकिन ऐसे परीक्षण लगभग हमेशा ऐसे दृश्यों पर आधारित होते हैं जो रोज़मर्रा की अपेक्षाओं से मेल खाते हैं। खिड़की पर बैठी बिल्ली, बारिश में छाता लिए व्यक्ति, सड़क पर कार — ये सब मॉडल ने डेटासेट के कैप्शन में लाखों बार देखा है।
लेकिन क्या होगा यदि दृश्य जगत सामान्य बुद्धि के विरुद्ध चले? यह पता लगाने के लिए, टीम ने CAIT नामक बेंचमार्क संकलित किया — उच्च विवरण वाले 400 सिंथेटिक दृश्य। इनमें से प्रत्येक ऐसी क्रिया दर्शाता है जो परिचित विश्व-दृष्टि के विपरीत है: वही खरगोश जो बाघ का पीछा कर रहा है, इसका एक विशिष्ट उदाहरण है। चित्र सिंथेटिक हैं, और इसलिए नियंत्रित भी: यह निश्चित किया जा सकता है कि दृश्य संकेत वास्तव में मौजूद है और वह स्पष्ट है।
कार्यप्रणाली का मुख्य विचार यह है कि यहाँ सही उत्तर प्रश्न के पाठ से निकाला नहीं जा सकता। इसे केवल एक ही तरीके से प्राप्त किया जा सकता है — चित्र को देखकर और जो उसमें चित्रित है उसे स्वीकार करके।
मनुष्य, बंद और खुले मॉडल: आँकड़ों में अंतर
परिणाम तीन बहुत भिन्न स्तरों पर वितरित हुए।
- मनुष्य इस कार्य को लगभग त्रुटिहीन ढंग से हल करते हैं — सटीकता लगभग 0.95। हमारे लिए असामान्य दृश्य को देखना और उसे बस दर्ज कर लेना कोई कठिन काम नहीं है।
- प्रोप्राइटरी मॉडल — शोध में अग्रणी समाधान शामिल थे, जिनमें Claude और Gemini भी हैं — स्थिर समझ प्रदर्शित करते हैं: सटीकता 0.88 तक पहुँचती है। आदर्श नहीं, लेकिन सिस्टम स्पष्ट रूप से चित्र को देख रहा है, अनुमान नहीं लगा रहा।
- ओपन instruction-tuned मॉडल — 14 प्रतिनिधिक उदाहरण — यादृच्छिक अनुमान के स्तर तक गिर जाते हैं। दूसरे शब्दों में, उनके उत्तर वास्तव में जो चित्रित है उससे लगभग मेल नहीं खाते।
यही शीर्षकीय कथा है: बंद समाधानों के «बाघ» और खुले समाधानों के «खरगोश» के बीच का अंतर सौंदर्यपरक नहीं, बल्कि मूलभूत निकला। बात यह नहीं है कि खुले मॉडल कठिन कार्य में थोड़ा कमतर हैं — प्रति-सहज दृश्यों में वे किसी भी सार्थक अर्थ में मल्टीमॉडल होना बंद कर देते हैं।
मुख्य दोषी — भाषाई पूर्वाग्रह
त्रुटियों का विश्लेषण विफलता की कार्यप्रणाली दिखाता है। बात यह नहीं है कि मॉडल ने खरगोश को नहीं देखा। बात यह है कि उसने अपनी आँखों पर विश्वास न करना चुना।
जब दृश्य संकेत पाठ के सांख्यिकीय से टकराता है, तो एक शक्तिशाली भाषाई पूर्वाग्रह सक्रिय हो जाता है: मॉडल स्वचालित रूप से असामान्य अवलोकन को सबसे सामान्य पाठ्य विवरण से बदल देता है। बाघ खरगोश का पीछा कर रहा है — यह वाक्यांश कोषों में लगातार मिलता है। उल्टा क्रम — लगभग कभी नहीं। और «देखा» और «अपेक्षित» के बीच के द्वार पर सिस्टम दूसरे को चुनता है।
वस्तुतः, ऐसे मॉडल के लिए दृश्य इनपुट केवल इस बात का संकेत बन जाता है कि स्मृति से कौन-सा वाक्यांश निकालना है। यदि चित्र टेम्पलेट की पुष्टि करता है — सब ठीक है। यदि वह उससे टकराता है — टेम्पलेट जीत जाता है। यही कारण है कि सटीकता सिक्का उछालने के स्तर पर रहती है: मॉडल भाषा की जड़ता से उत्तर देता है, चित्र की सामग्री से नहीं।
तर्क का जाल: दृश्य को «पुनर्विचार» करना
एक तार्किक सुझाव है — मॉडल में तर्क-श्रृंखला (Chain-of-Thought) जोड़ना। वह चरणों को बोलकर कहे, स्वयं की जाँच करे, निष्कर्ष पर पहुँचे। कुछ हद तक यह काम करता है: सटीकता वास्तव में बढ़ती है।
लेकिन सुधार की एक कीमत है, और कीमत दोहरी है।
पहला, उत्तर काफ़ी धीमा हो जाता है — विस्तृत तर्क में समय और गणना लगती है। दूसरा — और यह अधिक रोचक है — विफलता का एक नया तरीका सामने आता है। मॉडल जो देखा उसे शाब्दिक रूप से पुनर्विचार करने लगता है। वह मानो दृश्य को दर्ज करता है, और फिर उसे अस्वीकार कर देता है: ऐसा नहीं होता, यह वास्तविक दुनिया के भौतिक नियमों का उल्लंघन करता है, तो मैंने शायद गलती की। परिणामस्वरूप, सिस्टम वास्तविक दृश्य सामग्री को स्वीकार करने से इनकार कर देता है — ठीक इसलिए क्योंकि वह असंभव है।
एक विशिष्ट विडंबना बनती है: निष्कर्ष को अधिक ठोस बनाने के लिए बनाया गया उपकरण कभी-कभी असुविधाजनक तथ्यों को दबाने की मशीन में बदल जाता है।
क्या मदद करता है: फाइनट्यूनिंग और संरचित प्रॉम्प्टिंग
अच्छी खबर यह है कि समस्या घातक नहीं है। लेखक दो दृष्टिकोणों का वर्णन करते हैं जो भाषाई पूर्वाग्रहों पर निर्भरता को काफ़ी कम कर देते हैं।
- लक्षित फाइनट्यूनिंग। उपयुक्त डेटा पर अतिरिक्त प्रशिक्षण अवलोकन को टेम्पलेट से बदलने की प्रवृत्ति को कम करता है और दृश्य चैनल का महत्व लौटाता है।
- संरचित प्रॉम्प्टिंग। यदि मॉडल के लिए उत्तर का एक ऐसा प्रारूप निर्धारित किया जाए जिसमें वह पहले देखी गई बात को दर्ज करने के लिए बाध्य हो और उसके बाद ही व्याख्या करे, तो सटीकता पुनःप्रशिक्षण के बिना बढ़ती है।
दोनों ही मामलों में, खुले मॉडल अपने निष्कर्ष को पाठ के सांख्यिकीय के बजाय वास्तविक दृश्य प्रमाणों पर आधारित करने लगते हैं। यानी बंद समाधानों के साथ का अंतर — वास्तुकला और प्रशिक्षण का प्रश्न है, मूलभूत असंभवता का नहीं।
व्यवहार में इससे क्या निकलता है
एक डेवलपर के लिए जो किसी खुले मल्टीमॉडल मॉडल पर उत्पाद बना रहा है, निष्कर्ष काफ़ी व्यावहारिक हैं।
यह याद रखना चाहिए कि आत्मविश्वासी उत्तर देखे गए के बराबर नहीं होता। जहाँ दृश्य अपेक्षाओं से मेल खाता है, वहाँ मॉडल विश्वसनीयता दिखाता है; जहाँ वह भिन्न होता है, वहाँ चुपचाप और अगोचर रूप से एक विश्वसनीय-सा मनगढ़ंत विवरण रख देता है। सबसे खतरनाक बात यह है कि त्रुटि त्रुटि जैसी दिखती ही नहीं: विवरण सहज, तार्किक और पूरी तरह गलत बनता है।
तर्क को एक ऐसे उपकरण के रूप में अलग से देखना चाहिए जिसके दुष्प्रभाव होते हैं। Chain-of-Thought हमेशा और सभी कार्यों में मदद नहीं करता — कभी-कभी यह मॉडल को एक ऐसा संशयवादी बना देता है जो अपने ही सही निष्कर्ष को अस्वीकार कर देता है।
और अंत में, सबसे महत्वपूर्ण बात। «खरगोश बाघ का पीछा कर रहा है» — यह कोई विचित्र संयोग नहीं, बल्कि इस बात की स्पष्ट परीक्षा है कि मॉडल वास्तव में किस पर भरोसा करता है। जब तक इस प्रश्न का उत्तर चित्र के पक्ष में नहीं होता, सिस्टम को मल्टीमॉडल कहना केवल सशर्त रूप से उचित है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
Toollery: बिना फ़ाइन-ट्यूनिंग के, दसियों हज़ार विकल्पों में से LLM एजेंटों के लिए टूल चुनना
Toollery कौशलों और टूल्स के विवरणों पर एक खोज इंडेक्स बनाता है और अनुरोध आने पर मॉडल को केवल सीमित उम्मीदवारों का सेट भेजता है। दसियों हज़ार फ़ंक्शनों तक के आकार वाली लाइब्रेरी पर किए गए प्रयोगों में, यह तरीका निश्चित top-K पर चयन की गुणवत्ता बनाए रखने में सक्षम है, हालांकि अंतिम प्रभाव लोड प्रोफ़ाइल और प्रदाता की कैशिंग पर निर्भर करता है।
11 नवम्बर 2026
डैशबोर्ड विश्लेषण में GUI एजेंटों का चरणबद्ध निदान: DashAct बेंचमार्क
DashAct प्रस्तुत है—348 मानव-सत्यापित ट्रैजेक्टरी वाला एक बेंचमार्क, जो इंटरैक्टिव डैशबोर्ड के साथ GUI एजेंटों के काम को तीन चरणों और चार दृश्य स्थितियों में विभाजित करता है। नतीजे बताते हैं कि एजेंटों को कार्रवाइयों का अनुमान लगाने और दृश्य लक्ष्यों से जुड़ने में लगातार समस्याएँ आती हैं, साथ ही उनकी प्रतिक्रियाएँ संदर्भ और स्थानिक समर्थन पर निर्भर करती हैं।
11 नवम्बर 2026
WILSON: पैथोमॉर्फोलॉजिकल विश्लेषण और निष्कर्ष तैयार करने के लिए रोगी के आवर्धनों और स्लाइडों का संयोजन
यह प्रीप्रिंट WILSON प्रस्तुत करता है—एक vision-language मॉडल, जो केवल एक अलग “सर्वश्रेष्ठ” स्लाइड के बजाय पूरे स्लाइडों और एक ही मरीज के अलग-अलग आवर्धन पर लिए गए नमूनों की छवियों को एन्कोड करता है। किसी विशिष्ट कार्य के लिए अतिरिक्त प्रशिक्षण के बिना, यह कई मेट्रिक्स पर विशेषीकृत और अधिक बड़े स्लाइड-मॉडलों से बेहतर प्रदर्शन करता है, वह भी काफ़ी कम कंप्यूटेशनल लागत पर; इसके नैदानिक विवरणों को पैथोलॉजिस्टों से अधिक ऊँची रेटिंग मिली।
11 नवम्बर 2026