
अंतिम उत्तर एकमात्र मीट्रिक के रूप में — और यह क्या छिपाती है
भाषा मॉडलों के लिए अधिकांश बेंचमार्क स्कूली परीक्षा की तरह बने होते हैं: एक प्रश्न है, एक मानक उत्तर है, और मिलान की जाँच है। ऐसी मीट्रिक की गणना करना सुविधाजनक है, और मॉडलों की तुलना करना भी। लेकिन इस योजना में एक अंतर्निहित दोष है: यह परिणाम का मूल्यांकन करती है, उस तक पहुँचने के रास्ते का नहीं।
एक ऐसे कार्य की कल्पना करें जिसमें चार तथ्यों को जोड़ना है। मॉडल दूसरे पर उलझ जाता है, चौथे पर संयोग से सही अनुमान लगा लेता है — और अंक पा लेता है। या इसके विपरीत: तीन कड़ियाँ बेदाग़ तरीके से जुड़ी हैं, लेकिन अंतिम उत्तर एक शब्दावली से अलग था — और अंक नहीं मिला। दोनों ही मामलों में अंतिम संख्या इस बारे में झूठ बोलती है कि अंदर वास्तव में क्या हुआ। यह बहु-चरणीय प्रश्नों के लिए विशेष रूप से कष्टकारी है: वहाँ एक कौशल नहीं, बल्कि उनका क्रम परखा जाता है — जानकारी ढूँढना, उसे थामे रखना, अगली जानकारी से जोड़ना, और रास्ते में कुछ न खोना।
"ठीक कहाँ टूटा" की निदान-प्रक्रिया कोई अकादमिक नुक्ताचीनी नहीं है। इसी पर निर्भर करता है कि क्या ठीक करना है: डेटा कॉर्पस, प्रशिक्षण रणनीति, या प्रॉम्प्ट की शब्दावली। अंतिम सटीकता परिभाषा से ही इस प्रश्न का उत्तर नहीं दे सकती।
Omanic क्या है
यही अंधा क्षेत्र "Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models" नामक कार्य द्वारा भरा जाता है (arXiv:2603.16654, cs.CL अनुभाग में आता है, cs.AI और cs.LG में भी वर्गीकृत, EMNLP 2026 Findings में स्वीकृत)। लेखकों का समूह विस्तृत और अंतर्राष्ट्रीय है: Xiaojie Gu, Sherry T. Tong, Aosong Feng, Sophia Simeng Han, Jinghui Lu, Yingjian Chen, Yusuke Iwasawa, Yutaka Matsuo, Chanjun Park, Rex Ying, Irene Li। पहला संस्करण 17 मार्च 2026 को प्रकाशित हुआ, फिर दो संशोधन आए — मई और अगस्त में।
Omanic चार तर्क-चरणों वाला एक open-domain बेंचमार्क है। यहाँ "open-domain" शब्द निर्णायक है: मॉडल तैयार सूची से विकल्प नहीं चुनता और न ही किसी एक पूर्व-तैयार दस्तावेज़ में खोजता है। जानकारी स्वयं ढूँढनी होती है और उसके बाद ही उससे एक श्रृंखला बनानी होती है। ऐसी रचना वास्तविक परिदृश्यों के अधिक निकट है, जहाँ उत्तर लगभग कभी एक ही अनुच्छेद में नहीं होता।
एक के बजाय दो कॉर्पस
Omanic के भीतर दो अलग-अलग डेटासेट हैं, और इन्हें मिलाना नहीं चाहिए।
पहला — OmanicSynth, 10,296 उदाहरण, जो मशीन द्वारा उत्पन्न किए गए हैं। यह प्रशिक्षण सामग्री है: इसे सुपरविज़न के रूप में उपयोग किया जा सकता है, और इसी पर लेखकों ने जाँचा कि चरण-दर-चरण तर्क करने की क्षमता हस्तांतरित होती है या नहीं।
दूसरा — OmanicBench, 967 उदाहरण, जो विशेषज्ञ समीक्षा से गुज़रे हैं और जिनमें मैन्युअल एनोटेशन है। यह मूल्यांकन भाग है, और यह काफ़ी छोटा है — जो तर्कसंगत है, क्योंकि चरण-स्तर पर मानवीय एनोटेशन महँगा पड़ता है।
यह विभाजन कोई औपचारिकता नहीं है। यह "मॉडल को प्रशिक्षित किया गया" और "मॉडल वास्तव में सक्षम है" को अलग करने देता है: प्रशिक्षण कॉर्पस बड़ा और मशीनी है, सत्यापन कॉर्पस संक्षिप्त और परिष्कृत है।
चरण-दर-चरण एनोटेशन कैसे बना है
परिचित QA-सेटों से Omanic का मुख्य अंतर यह है कि प्रत्येक प्रश्न को उसके घटकों में विभाजित किया गया है। एकल-चरणीय उपप्रश्न, मध्यवर्ती उत्तर, संरचित ग्राफ़ टोपोलॉजी — यानी इस बात की योजना कि तथ्य वास्तव में एक-दूसरे से कैसे जुड़े हैं।
यह मूल्यांकन को एक बिंदु से नियंत्रण बिंदुओं के एक समूह में बदल देता है। अब केवल यह नहीं देखा जा सकता कि "मॉडल ने सही उत्तर दिया या नहीं", बल्कि यह भी कि "वह ठीक किस संक्रमण पर फिसला"। ग्राफ़ संरचना यहाँ इसलिए भी महत्वपूर्ण है क्योंकि विभिन्न प्रकार के संबंध मॉडलों के लिए अलग-अलग कठिनाई के होते हैं: किसी वस्तु का गुण निकालना एक बात है, और चार क्रमिक निर्भरताओं की श्रृंखला का पीछा करना बिल्कुल दूसरी बात।
तीन निदान जो केवल चरणों पर दिखते हैं
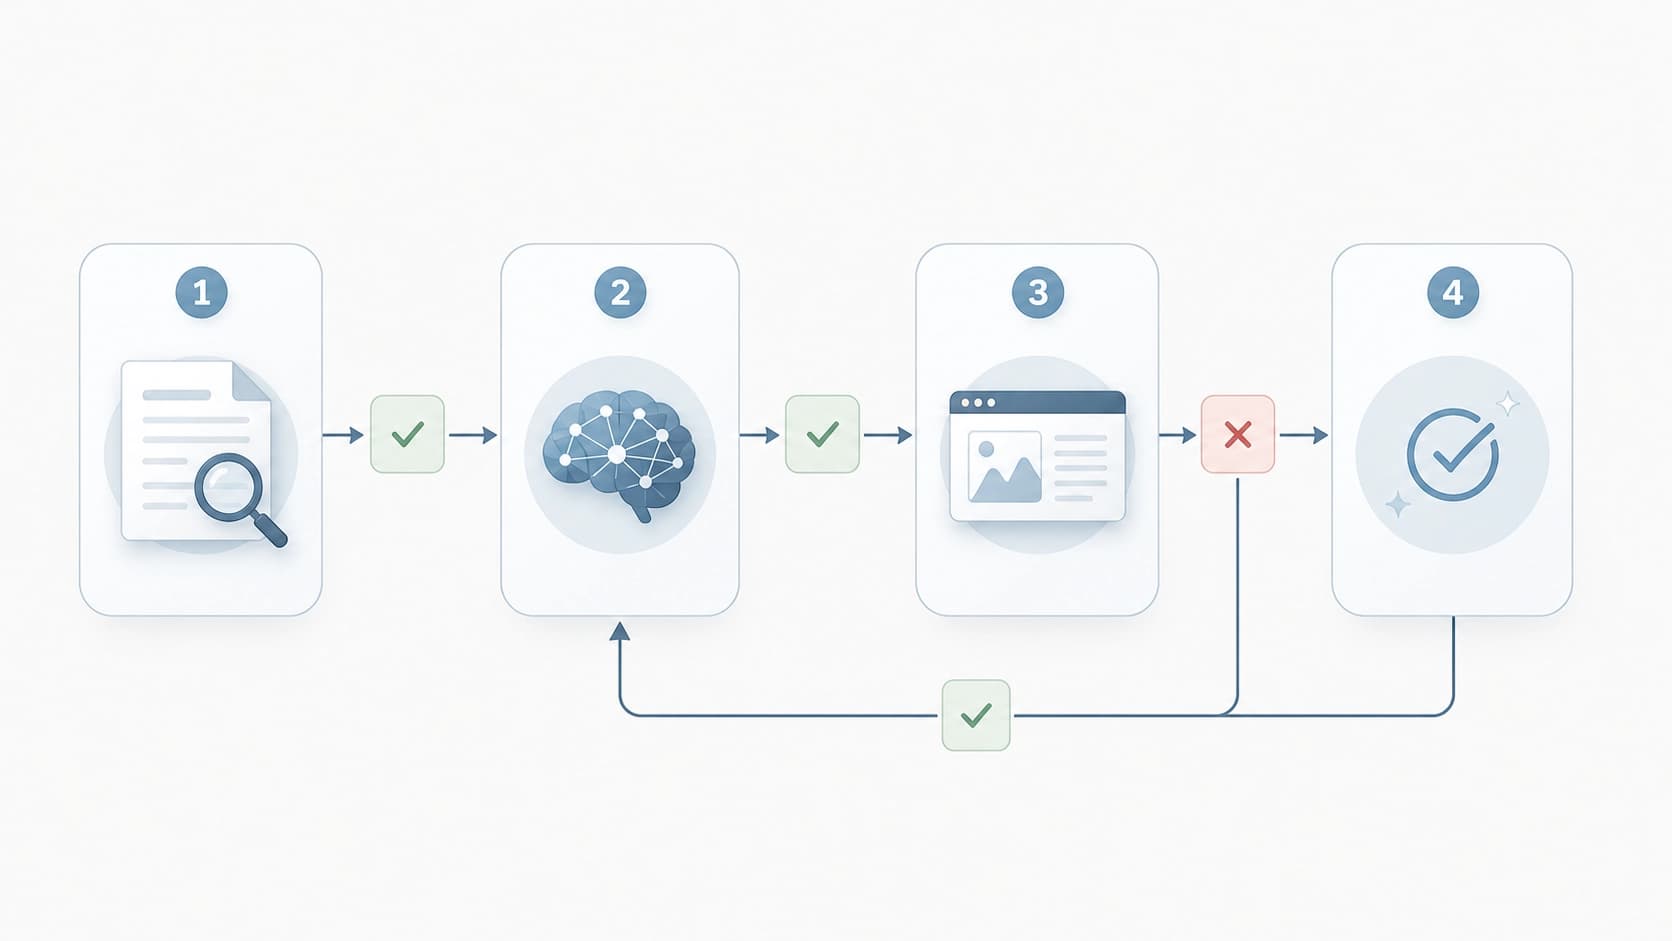
बंद और खुले मॉडलों के साथ प्रयोगों ने तीन अवलोकन दिए, जिन्हें अंतिम मीट्रिक दिखाने में बिल्कुल असमर्थ है।
देर के चरणों पर अवरोध
पहले निष्कर्ष को लेखक later-hop bottleneck कहते हैं। बात यह है कि मुख्य नुकसान शुरुआत में नहीं, बल्कि श्रृंखला के अंत के निकट जमा होते हैं। पहला-दूसरा संक्रमण मॉडल अपेक्षाकृत आत्मविश्वास से पार कर लेते हैं, लेकिन तीसरे और चौथे पर बिखरने लगते हैं।
स्पष्टीकरण स्वयं सामने आता है: श्रृंखला जितनी लंबी होती है, उतनी ही अधिक मध्यवर्ती इकाइयों को एक साथ कार्यशील अवस्था में रखना पड़ता है। देर के चरणों में मॉडल को मूल प्रश्न के बजाय अपने ही पिछले निष्कर्षों के परिणामों के साथ काम करना पड़ता है — और वहाँ कोई भी अशुद्धि कई गुना बढ़ जाती है। व्यावहारिक निष्कर्ष उन लोगों के लिए अप्रिय है जो लंबे बहु-चरणीय पाइपलाइन बनाना पसंद करते हैं: पाँचवें और छठे चरण को जोड़ना जितना लगता है उससे अधिक महँगा पड़ सकता है।
तथ्यात्मक ज्ञान की "फ़र्श"
दूसरी परिघटना — factual knowledge floor, तथ्यात्मक ज्ञान की "फ़र्श"। कुछ त्रुटियों का तर्क से कोई संबंध ही नहीं है: मॉडल के पास आवश्यक तथ्य ही नहीं है और ईमानदारी से रुकने के बजाय खाली जगह पर तर्क बनाता रहता है।
यह एक महत्वपूर्ण विभेदन है। जब मॉडल निष्कर्ष में गलती करता है — प्रश्न तर्क का है। जब उसे मूल तथ्य ही नहीं पता — प्रश्न डेटा का है और इसका कि वह अज्ञानता स्वीकार करना जानता है या नहीं। दूसरा इलाज मुश्किल से होता है: न चरण-दर-चरण तर्क मदद करेगा, न अधिक चतुर प्रॉम्प्ट, अगर पहली कड़ी के नीचे आधार ही न हो।
वह त्रुटि जो श्रृंखला पर सवार होकर चलती है
तीसरा निदान — श्रृंखला के साथ त्रुटियों का प्रसार। शुरुआती अशुद्धि स्थानीय नहीं रहती: उसे आगे के चरण उठा लेते हैं और वह एक आत्मविश्वासी, सहज ढंग से व्यक्त, लेकिन गलत अंतिम उत्तर में बदल जाती है।
यहाँ मूल्यांकन के लिए एक जाल छिपा है। जिस मॉडल ने एक बार गलती की और फिर क्रमबद्ध तर्क किया, और जिस मॉडल ने हर चरण पर बिखराव किया, वे अंतिम मीट्रिक में एक जैसे दिखते हैं — दोनों ने सही अनुमान नहीं लगाया। चरण-दर-चरण विश्लेषण उनमें अंतर करता है, और यह ठीक वही स्थिति है जहाँ निदान अंतिम अंक से अधिक मूल्यवान है।
प्रशिक्षण का स्थानांतरण: छह बेंचमार्कों पर 7.41 अंक
एक अलग प्रश्न — क्या इस एनोटेशन का उपयोग केवल मापन के लिए नहीं, बल्कि प्रशिक्षण के लिए भी किया जा सकता है। लेखकों ने जाँचा: OmanicSynth पर फ़ाइन-ट्यूनिंग ने तर्क और गणित को समर्पित छह बाहरी बेंचमार्कों पर सुधार दिया, औसतन 7.41 अंक की वृद्धि के साथ।
यह संख्या सही ढंग से पढ़ने योग्य है। यह "मॉडल हर चीज़ में अधिक स्मार्ट हो गया" नहीं है — यह "विघटित श्रृंखलाओं पर अभ्यास किया गया कौशल समान प्रकार के अन्य कार्यों पर स्थानांतरित होता है" है। जो अपने आप में बेंचमार्क की प्रकृति के बारे में बताता है: यह विशिष्ट प्रश्नों को रटने के बारे में नहीं, बल्कि प्रक्रिया के प्रशिक्षण के बारे में है — किसी कार्य को चरणों में कैसे बाँटें और उनके बीच संबंध कैसे बनाए रखें।
व्यवहार के लिए इसका क्या अर्थ है
वर्णित बातों से कुछ निष्कर्ष स्वयं सामने आते हैं।
परिणाम के बजाय चरणों के आधार पर मूल्यांकन करें। यदि आपका सिस्टम बहु-चरणीय उत्तर बनाता है, तो एक अंतिम मीट्रिक पर्याप्त नहीं है — वह अलग-अलग प्रकृति की विफलताओं को एक अस्पष्ट संख्या में समाहित कर देगी।
"नहीं जानता" और "गलत निष्कर्ष निकाला" को अलग करें। ये दो अलग दोष हैं जिनके इलाज के तरीके अलग हैं, लेकिन सामान्य रिपोर्टिंग में वे विलीन हो जाते हैं।
लंबी श्रृंखलाओं से सावधान रहें। देर के चरण सबसे कमज़ोर स्थान हैं। कभी-कभी किसी कार्य को कई स्वतंत्र उपकार्यों में बाँटना अधिक समझदारी है, बजाय एक लंबी श्रृंखला को अंत तक खींचने के।
विघटन एक प्रशिक्षण संकेत भी है। छह बाहरी सेटों पर स्थानांतरण का परिणाम दिखाता है कि चरण-दर-चरण एनोटेशन केवल एक पैमाने के रूप में नहीं, बल्कि प्रशिक्षण सामग्री के रूप में भी काम करता है।
Omanic क्या नहीं है
सीमाओं को स्पष्ट करना उपयोगी है। Omanic मॉडल की बुद्धि का सार्वभौमिक मूल्यांकन नहीं है और न ही एक साथ सब कुछ परखने वाला परीक्षण। यह एक विशिष्ट कार्य के लिए उपकरण है: यह दिखाना कि खुले डोमेन के बहु-चरणीय प्रश्नों में तर्क की किस कड़ी पर सफलता मिलती है।
मूल्यांकन भाग का आकार — 967 उदाहरण — भी ध्यान में रखने योग्य है: सेट परिष्कृत है, लेकिन विशाल नहीं। प्रशिक्षण भाग कई गुना बड़ा है और मशीन द्वारा बनाया गया है, जो पैमाना देता है, लेकिन मैन्युअल जाँच का विकल्प नहीं है।
और सबसे महत्वपूर्ण: निदान स्वयं कुछ भी ठीक नहीं करता। यह जानना कि मॉडल देर के चरणों में लड़खड़ाता है, एक प्रारंभिक बिंदु है, समाधान नहीं। आगे सामान्य काम शुरू होता है: कहाँ डेटा जोड़ना है, कहाँ श्रृंखला सरल करनी है, कहाँ मॉडल को रुकना और "मुझे यह नहीं पता" कहना सिखाना है।
डेटा और कोड लेखकों ने खुले रूप में उपलब्ध कराए हैं; कार्य DOI 10.48550/arXiv.2603.16654 पर उपलब्ध है।


