
NAQD-Env: भाषा एजेंटों में संचालन का चयनात्मक निलंबन
एक सिंथेटिक बेंचमार्क जारी किया गया है, जहाँ एक नियतात्मक संदर्भ डेटा, अनुमतियों और प्रतिबंधों के बीच निर्भरताएँ तय करता है, और मॉडलों को बाकी काम खोए बिना केवल प्रभावित चरणों को रोकना होता है। तीन ओपन मॉडल के परीक्षणों में रोकने की कम पूर्णता और सही ढंग से फिर से शुरू करने की क्षमता का अभाव सामने आया; फाइन-ट्यूनिंग निर्णयों की सटीकता बढ़ाती है, लेकिन इसके दुष्प्रभाव भी होते हैं।
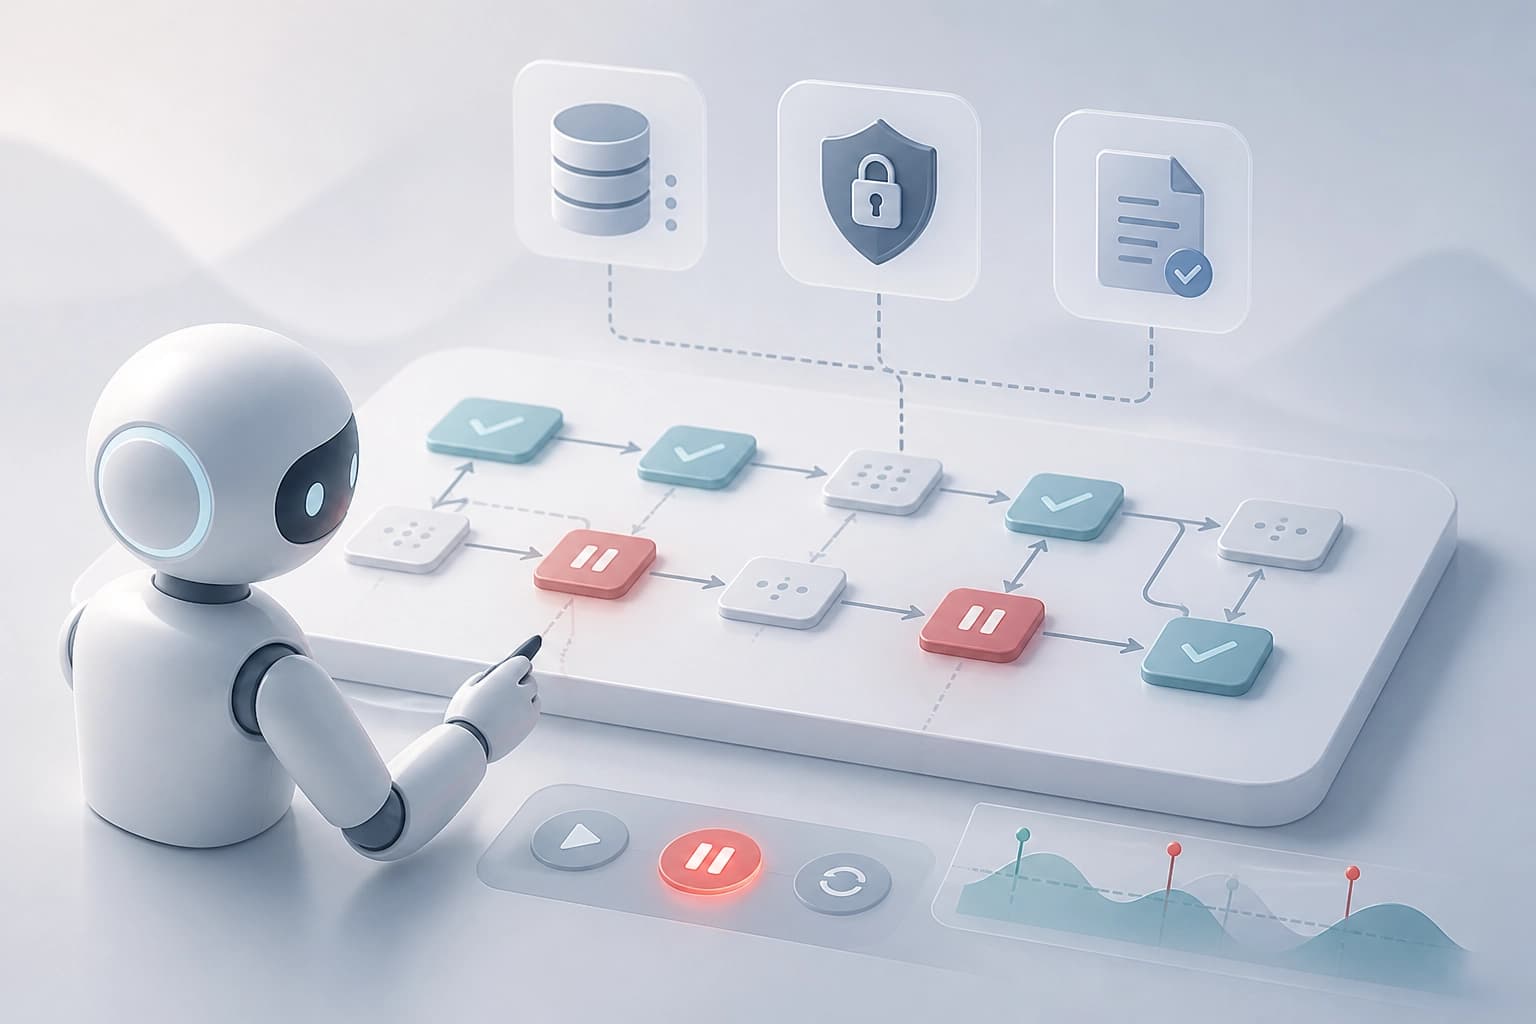
चयनात्मक निलंबन का सार
NAQD Env भाषाई एजेंटों के चुनिंदा कार्रवाई बंद करने के निर्णयों का मूल्यांकन करने के लिए एक सिंथेटिक परिवेश है। संदर्भ नीति नियतात्मक है। यह साक्ष्यों, अनुमतियों और प्रतिबंधों के स्पष्ट रूप से परिभाषित निर्भरता-संबंधों पर आधारित है। साक्ष्य बदलने, अनुमति रद्द होने या रुकने का निर्देश मिलने पर एजेंट को प्रभावित कार्रवाइयाँ निलंबित करनी चाहिए। एजेंट अप्रभावित काम जारी रखता है। पर्याप्त सुधार होने के बाद ही कार्रवाइयाँ फिर से शुरू करता है। कसौटी: परिवेश निलंबन की चयनात्मकता जाँचता है, पूरी तरह रुक जाने को नहीं।
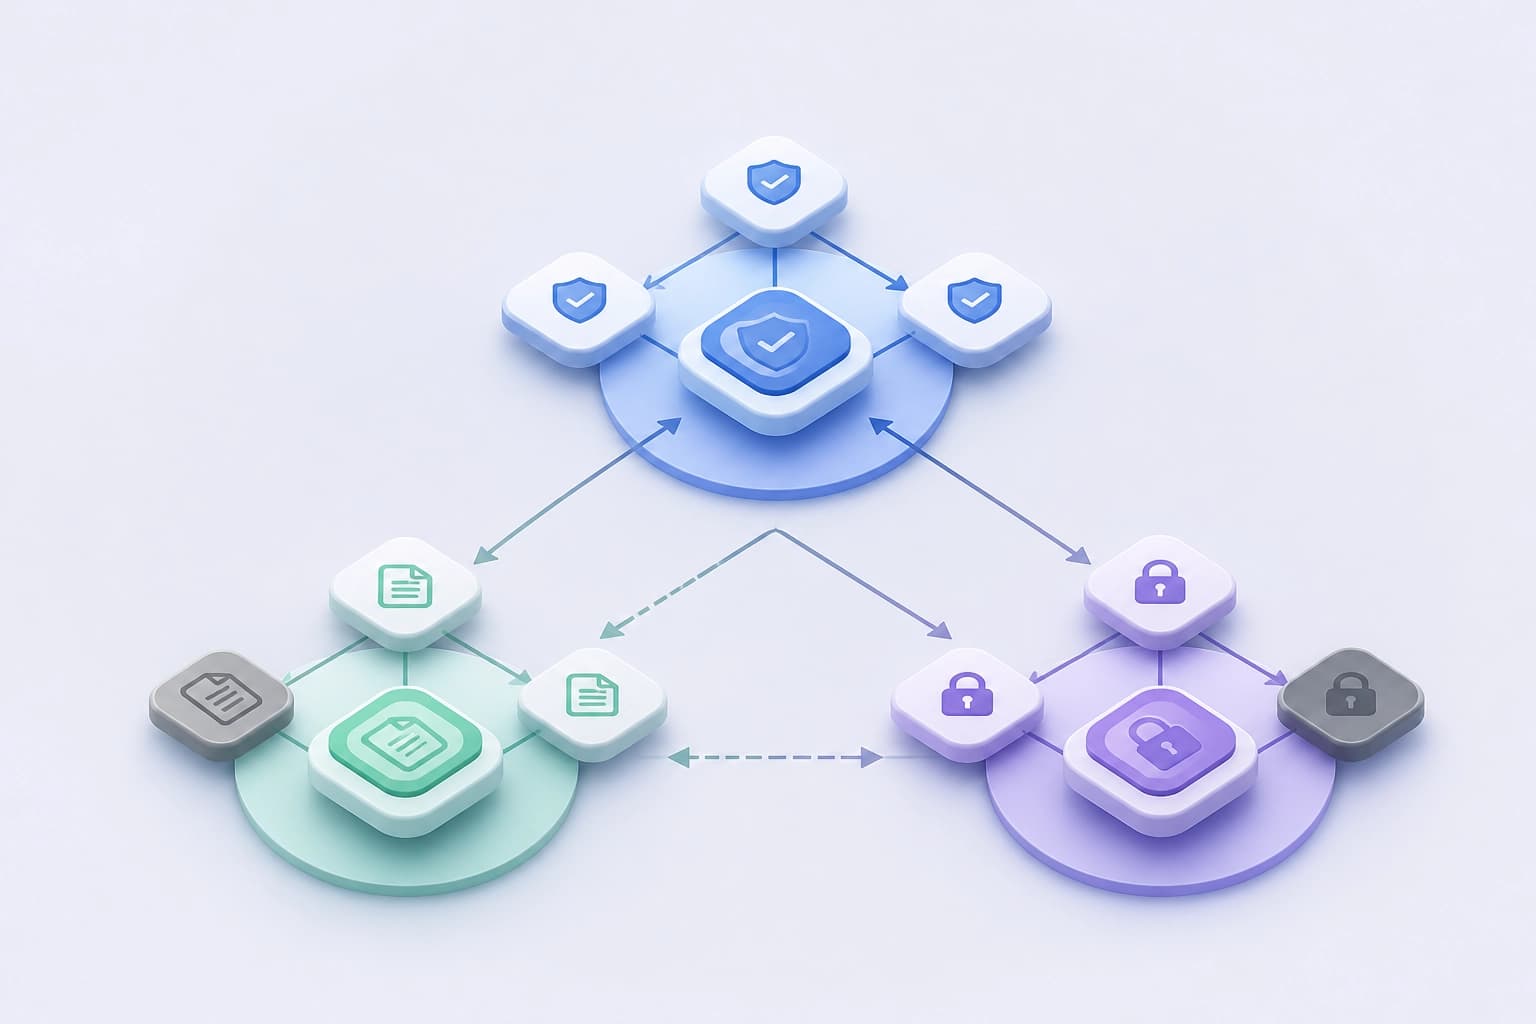
मूल्यांकन कैसे काम करता है
मूल्यांकन में निर्भरताओं के 11 परिवार इस्तेमाल किए जाते हैं। इस सेट में विकास के लिए संरचनाएँ, रोके गए परिवार और रोके गए संरचना-संयोजन शामिल हैं। मेट्रिक्स उल्लंघन के प्रयासों और सिम्युलेटेड निष्पादन तंत्र द्वारा किए गए उल्लंघनों को अलग-अलग दर्ज करते हैं। संयुक्त मेट्रिक्स नीति-अनुपालन, कार्य-मूल्य, कार्रवाई बंद करने, फिर से शुरू करने और घटनाओं की रिपोर्टिंग को दर्शाते हैं। यह सेट इरादे और वास्तविक उल्लंघन के बीच अंतर करता है। यह सुरक्षा को उपयोगिता और संचार से भी जोड़ता है। व्यावहारिक कसौटी: केवल रुकने के तथ्य को नहीं, बल्कि सभी मेट्रिक्स को साथ में देखें।
तीन मॉडलों के परिणाम
अध्ययन में खुले वज़न वाले तीन मॉडलों का मूल्यांकन किया गया। इन्हें निर्देशों का पालन करने के लिए तैयार किया गया है और ये दो परिवारों से संबंधित हैं। प्रॉम्प्ट की तीन स्थितियों और 350 निश्चित परिदृश्यों का उपयोग किया गया। निष्पादन तंत्र के ज़रिए दोबारा चलाने से पहले कुल 3 150 “मॉडल—प्रॉम्प्ट” एपिसोड प्राप्त हुए। जाँची गई स्थितियों में कार्रवाई बंद करने की पूर्णता 0,06 से अधिक नहीं थी। उपयुक्त अवसरों पर एक भी सही ढंग से फिर से शुरू करने का मामला नहीं देखा गया। केवल एक एपिसोड पूरी तरह संदर्भ नीति से मेल खाता था।
NAQD प्रॉम्प्ट के तहत मॉडलों की तुलना:
| मॉडल | अवलोकन |
|---|---|
| Qwen2.5-7B | Qwen2.5-3B और Llama-3.1-8B की तुलना में असुरक्षित प्रयासों वाले एपिसोड कम। लेकिन उपयोगी काम कम और अप्रभावित कार्रवाइयों को बनाए रखने में कम सटीक। |
| Qwen2.5-3B | नियंत्रित फाइन-ट्यूनिंग के परीक्षणों में निर्णयों की सटीकता 0.45–0.54 से बढ़कर 0.83–0.92 हो गई। |
| Llama-3.1-8B | असुरक्षित प्रयासों की तुलना में Qwen2.5-7B से पीछे। |
निष्कर्ष: विशेष प्रॉम्प्ट के बावजूद, मॉडल शायद ही कभी संदर्भ नीति का पूरी तरह पालन करते हैं। सुरक्षा में सुधार से उपयोगी काम कम हो सकता है। व्यावहारिक कसौटी: केवल उल्लंघन के प्रयासों को ही नहीं, बल्कि अप्रभावित कार्रवाइयों को बनाए रखने को भी जाँचें।
परिवेश और फाइन-ट्यूनिंग की सीमाएँ
यह परिवेश विश्वसनीय, संरचित इनपुट के साथ नीति लागू करने का मूल्यांकन करता है। यह वास्तविक दुनिया में रोकथाम या स्रोतों की जाँच करने की क्षमता की पुष्टि नहीं करता। नियंत्रित फाइन-ट्यूनिंग के शोध-परीक्षणों में Qwen2.5-3B के निर्णयों की सटीकता बढ़ी। अलग निदान में प्रशिक्षण पाठ्यक्रम में अंतराल के बाद अनुचित रूप से कार्रवाइयाँ बंद करने का पता चला। इसमें घटनाओं की रिपोर्टिंग की आवृत्ति में गिरावट भी दिखाई दी। Mohamed Abouzahra का शोध-कार्य 29 सितंबर 2026 को प्रस्तुत किया गया। व्यावहारिक कसौटी: फाइन-ट्यूनिंग के बाद अनुचित रूप से रुकने और घटनाओं की रिपोर्टिंग की गुणवत्ता की जाँच आवश्यक है।
चयन के लिए व्यावहारिक निष्कर्ष
NAQD Env नियंत्रित स्थितियों में चयनात्मक निलंबन को मापता है। यह परिवेश विश्वसनीय, संरचित इनपुट के साथ काम करता है। यह वास्तविक दुनिया में रोकथाम या स्रोतों की जाँच की गारंटी नहीं देता। एजेंट चुनते समय कार्रवाई बंद करने की पूर्णता, फिर से शुरू करने की शुद्धता, अप्रभावित काम को बनाए रखने और घटनाओं की रिपोर्टिंग पर ध्यान देना चाहिए। फाइन-ट्यूनिंग से निर्णयों की सटीकता बढ़ सकती है, लेकिन इससे अनुचित रूप से रुकने और संचार घटने का जोखिम भी है। कसौटी: इस परिवेश का उपयोग नीति के निदान के लिए करें, वास्तविक परिस्थितियों में विश्वसनीयता की पुष्टि के रूप में नहीं।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026