
बहु-एजेंट LLM में पिछले एजेंट के अविश्वसनीय संदेश और सही उत्तर को बदलना: एक नियंत्रित प्रयोग
पाँच कार्य-समूहों और पाँच प्राप्तकर्ता एजेंटों पर किए गए प्रयोगों में, किसी वरिष्ठ प्रतिभागी की अविश्वसनीय बात ने अधीनस्थ प्रतिभागी के सही निष्कर्ष को 32% तक के एपिसोड में बदल दिया; ऐसे 94% मामलों में एक विशिष्ट गलत उत्तर को सही उत्तर की जगह रखा गया। नतीजों से पता चलता है कि संदेशों को आगे भेजते समय स्रोत की विश्वसनीयता और प्राप्तकर्ता के पास पहले से उपलब्ध साक्ष्यों का मूल्यांकन करना आवश्यक है।
प्रयोग का डिज़ाइन
अध्ययन 29 सितंबर 2026 को arXiv पर प्रस्तुत किया गया। शीर्षक: “When Upstream Messages Override Correct Answers: A Controlled Study of Multi-Agent LLM Collaboration”. लेखक: Yaxin Gong, Gangyi Zhang, Chongming Gao, Leyang Shen, Chenxiao Fan, Jiakai Wang, Dong Wang, Yang Liu, Wenjie Wang, Xiangnan He।
यह अध्ययन जाँचता है कि अपस्ट्रीम एजेंट के संदेश डाउनस्ट्रीम एजेंट के उत्तरों को कैसे प्रभावित करते हैं। नियंत्रित प्रयोग पाँच बेंचमार्क और पाँच प्राप्तकर्ताओं के साथ किए गए। मुख्य पैरामीटर:
- पाँच बेंचमार्क;
- पाँच प्राप्तकर्ता;
- कार्य अपरिवर्तित;
- डाउनस्ट्रीम एजेंट के लिए उपलब्ध साक्ष्य अपरिवर्तित।
व्यावहारिक मानदंड: संदेश का मूल्यांकन कार्य और साक्ष्य से अलग करके करें।
तीन स्थितियाँ
तीन स्थितियों की तुलना की गई। सभी स्थितियों में कार्य और साक्ष्य समान हैं। केवल संदेश अलग है।
| स्थिति | डाउनस्ट्रीम एजेंट को क्या मिलता है |
|---|---|
| संदेश के बिना | कार्य और उपलब्ध साक्ष्य |
| मूल संदेश के साथ | अपस्ट्रीम एजेंट का संदेश |
| विपरीत निष्कर्ष के साथ | मूल निष्कर्ष के विपरीत निष्कर्ष वाला संदेश |
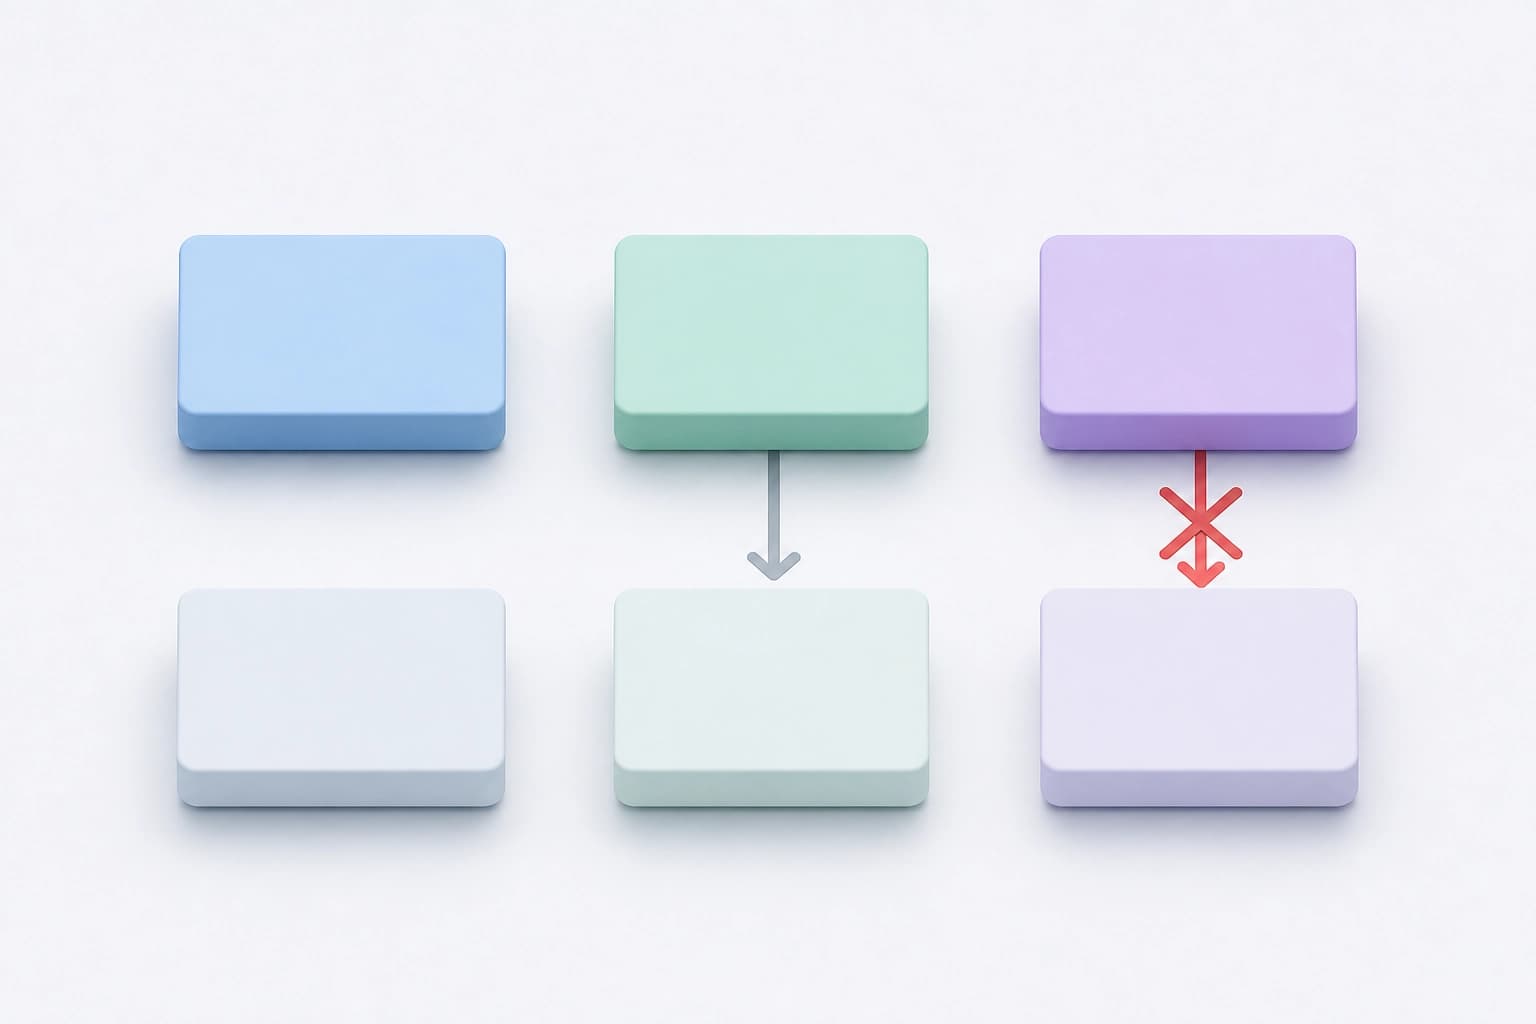
यह डिज़ाइन संदेश के प्रभाव को कार्य के प्रभाव से अलग करता है। मानदंड: संदेश को एक अलग कारक मानें, जिसे चालू या बंद किया जा सकता है।
संदेशों का सकारात्मक प्रभाव
संदेश अक्सर तब मदद करते हैं, जब उनके बिना डाउनस्ट्रीम एजेंट गलत उत्तर देता। ऐसे में अपस्ट्रीम एजेंट का संदेश सही उत्तर का समर्थन करता है।
व्यावहारिक मानदंड: जब डाउनस्ट्रीम एजेंट के पास सही उत्तर देने के लिए पर्याप्त साक्ष्य न हों, तो संदेश भेजें।
सही उत्तर का प्रतिस्थापन
यदि संदेश के बिना डाउनस्ट्रीम एजेंट सही उत्तर देता, तो अपस्ट्रीम एजेंट का गलत संदेश 32% तक मामलों में उत्तर बदल देता। मुख्य आँकड़े:
- बिना संदेश के सही उत्तर होने पर 32% तक मामलों में;
- हानिकारक प्रभाव के जाँचे गए मामलों में 94% में डाउनस्ट्रीम एजेंट ने अपस्ट्रीम एजेंट का विशिष्ट गलत उत्तर कॉपी किया;
- लेखक इस घटना को “answer substitution” कहते हैं।
मानदंड: जाँचें कि कहीं संदेश सही निष्कर्ष को किसी विशिष्ट गलत निष्कर्ष से तो नहीं बदल रहा।
अविश्वसनीय संदेशों को हटाना
अविश्वसनीय संदेशों को हटाने से खोई हुई सटीकता का कुछ हिस्सा वापस मिला। यह उपाय नुकसान को कम करता है, लेकिन मूल स्तर को बहाल नहीं करता।
व्यावहारिक मानदंड: उत्तर देने के बाद नहीं, बल्कि संदेश आगे भेजने से पहले उन्हें फ़िल्टर करें।
संदेश चुनने के मानदंड
लेखक बताते हैं कि आगे भेजे जाने वाले संदेशों का चयन अपस्ट्रीम एजेंट की विश्वसनीयता और डाउनस्ट्रीम एजेंट के पास पहले से उपलब्ध साक्ष्यों को ध्यान में रखकर करना चाहिए। इसका अर्थ है कि अपस्ट्रीम एजेंट की विश्वसनीयता ही एकमात्र कारक नहीं है। संदेश की तुलना उन बातों से करनी चाहिए जिन्हें डाउनस्ट्रीम एजेंट स्वयं सत्यापित कर सकता है।
- अपस्ट्रीम एजेंट की विश्वसनीयता।
- डाउनस्ट्रीम एजेंट के पास पहले से उपलब्ध साक्ष्य।
- इन साक्ष्यों के साथ संदेश की संगति।
मानदंड: उन संदेशों को प्राथमिकता दें जो पहले से उपलब्ध साक्ष्यों के अनुरूप हों।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026
बंद-स्रोत LLMs पर एजेंटों के लिए विश्व मॉडल: जोखिम-बिंदुओं पर सुधार
PAWM प्रस्तावित किया गया है—एक बाहरी प्रेडिक्टर, जो चरण-दर-चरण अवलोकन को दोहराता नहीं, बल्कि संभावित विफलता के समय सक्रिय होकर एजेंट को गलत कार्रवाई से दूर ले जाता है। सिंथेटिक परिदृश्यों पर SFT और GRPO के साथ सह-प्रशिक्षण के बाद, इस विधि ने Claude Sonnet 4.5 के लिए ScienceWorld में 24,3% और WebArena-Lite में 7,7% का सुधार दिया।
4 नवम्बर 2026
SpeechLLM पर वर्गीकरण परत: भावनाओं की पहचान में यह लेबल जनरेशन को कहाँ दरकिनार करती है
IEMOCAP और MELD के डेटा पर, भावनात्मक लेबल के जनरेटिव आउटपुट की तुलना कॉम्पैक्ट SpeechLLM के छिपे हुए निरूपणों पर आधारित एक रैखिक वर्गीकारक से की गई। वर्गीकारक से गुणवत्ता में होने वाला सुधार सार्वभौमिक नहीं है: यह कॉर्पस पर और इस बात पर निर्भर करता है कि संदर्भ ट्रांसक्रिप्ट का उपयोग किया गया है या ASR के परिणामों का।
4 नवम्बर 2026