
SpeechLLM पर वर्गीकरण परत: भावनाओं की पहचान में यह लेबल जनरेशन को कहाँ दरकिनार करती है
IEMOCAP और MELD के डेटा पर, भावनात्मक लेबल के जनरेटिव आउटपुट की तुलना कॉम्पैक्ट SpeechLLM के छिपे हुए निरूपणों पर आधारित एक रैखिक वर्गीकारक से की गई। वर्गीकारक से गुणवत्ता में होने वाला सुधार सार्वभौमिक नहीं है: यह कॉर्पस पर और इस बात पर निर्भर करता है कि संदर्भ ट्रांसक्रिप्ट का उपयोग किया गया है या ASR के परिणामों का।
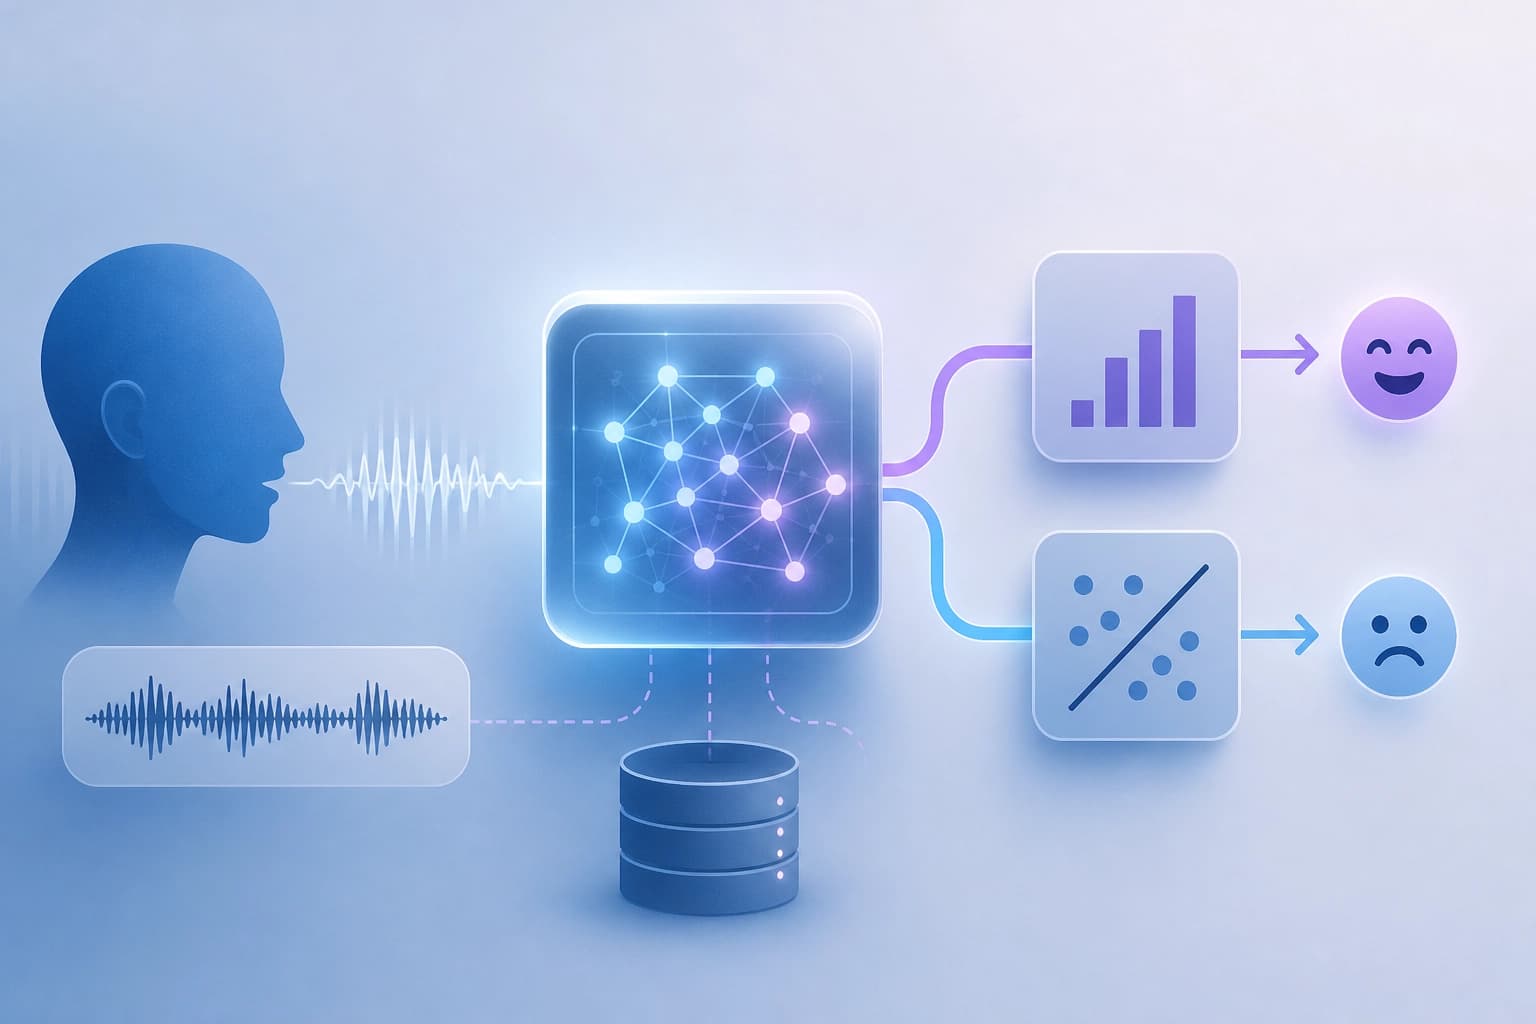
भावनाओं की पहचान के दो तरीके
इस लेख में LLM द्वारा लेबल-टोकन जनरेट करने और LLM की छिपी अवस्थाओं के ऊपर लीनियर हेड के साथ डिस्क्रिमिनेटिव वर्गीकरण की तुलना की गई है। जनरेटिव तरीका LLM के पहले से उपलब्ध आउटपुट प्रतिनिधित्वों पर निर्भर करता है। डिस्क्रिमिनेटिव तरीका मॉडल में एक अलग वर्गीकरण हेड जोड़ता है।
| मानदंड | लेबल-टोकन जनरेशन | डिस्क्रिमिनेटिव वर्गीकरण |
|---|---|---|
| LLM की भूमिका | लेबल के लिए आउटपुट प्रतिनिधित्व देता है | हेड के लिए छिपी अवस्थाएँ देता है |
| निर्णय लेने का तरीका | LLM लेबल-टोकन जनरेट करता है | लीनियर हेड छिपी अवस्था का वर्गीकरण करता है |
| क्या इस्तेमाल होता है | मॉडल का तैयार आउटपुट | LLM की छिपी अवस्थाएँ |
व्यावहारिक अंतर यह है कि जनरेशन मॉडल के तैयार आउटपुट का उपयोग करता है, जबकि हेड छिपी अवस्थाओं को पढ़ता है।
तुलना की शर्तें
तुलना IEMOCAP और MELD पर की गई। इसमें एक कॉम्पैक्ट SpeechLLM का इस्तेमाल किया गया: एक फ़्रीज़्ड Whisper-medium एन्कोडर और 3B LLM। प्रत्येक तुलना के लिए संदर्भ ट्रांसक्रिप्ट और ASR ट्रांसक्रिप्ट लिए गए। तुलना में टेक्स्ट के दो स्रोत शामिल हैं, इसलिए हेड के प्रभाव को हर स्रोत के लिए अलग-अलग जाँचा गया। मूल्यांकन का मानदंड: परिणामों की तुलना केवल एक ही डेटासेट और एक ही ट्रांसक्रिप्ट स्रोत के भीतर करें।
वर्गीकरण हेड लेबल जनरेशन से कहाँ बेहतर प्रदर्शन करता है
वर्गीकरण हेड ने 14 में से 10 कॉन्फ़िगरेशन में Macro F1 में सुधार किया। IEMOCAP पर इसने ASR ट्रांसक्रिप्ट वाले सभी कॉन्फ़िगरेशन में सुधार किया और 76.97% Macro F1 हासिल किया। इसी डेटासेट पर केवल-वाक् मोड ने भी उल्लेखनीय बढ़त दिखाई। MELD पर हेड ने केवल वाक् का उपयोग करने पर मदद की, लेकिन ASR ट्रांसक्रिप्ट के साथ नहीं। निष्कर्ष: लाभ डेटासेट और ट्रांसक्रिप्ट स्रोत पर निर्भर करता है। लेबल जनरेशन पर हर स्थिति में बढ़त नहीं मिलती।
संदर्भ ट्रांसक्रिप्ट से मिले निष्कर्षों को क्यों लागू नहीं किया जा सकता
MELD पर ASR ट्रांसक्रिप्ट का WER 32.38% है। टेक्स्ट वाले 6 में से 4 कॉन्फ़िगरेशन में, संदर्भ ट्रांसक्रिप्ट और ASR के बीच हेड का प्रभाव विपरीत हो जाता है। इसलिए संदर्भ ट्रांसक्रिप्ट से निकाले गए निष्कर्ष ASR के साथ ज़रूरी नहीं कि कायम रहें। व्यावहारिक मानदंड: हेड को उसी टेक्स्ट स्रोत पर जाँचें जिसका उपयोग किया जाएगा।
शब्दकोश के निकटतम टोकन क्या दिखाते हैं
IEMOCAP और MELD पर, सीखे गए क्लास वेक्टरों के निकटतम LLM शब्दकोश टोकन मुख्यतः भावना से जुड़े शब्द थे। वे भावनाओं के स्पष्ट नाम नहीं थे। इससे पता चलता है कि भावना का स्पष्ट नाम ज़रूरी नहीं कि निकटतम शब्दकोश टोकन से मेल खाए। जाँच का मानदंड: केवल लेबल के नाम को नहीं, बल्कि यह देखें कि क्लास वेक्टर के निकट कौन-से टोकन हैं।
चयन का मानदंड
तरीके का चयन दो बातों पर निर्भर करता है: डेटासेट और ट्रांसक्रिप्ट का स्रोत।
- ASR ट्रांसक्रिप्ट के लिए, हेड को ASR पर जाँचें, न कि संदर्भ टेक्स्ट पर।
- केवल-वाक् मोड के लिए, IEMOCAP और MELD पर मिले सुधार को ध्यान में रखें।
- संदर्भ ट्रांसक्रिप्ट के निष्कर्षों को ASR पर लागू न करें।
- क्लासों की व्याख्या के लिए, LLM शब्दकोश के निकटतम टोकन देखें।
अंतिम मानदंड: हेड वहाँ लेबल जनरेशन से बेहतर प्रदर्शन करता है जहाँ लक्षित डेटासेट और ट्रांसक्रिप्ट स्रोत पर जाँच से लाभ दिखाई देता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026
बंद-स्रोत LLMs पर एजेंटों के लिए विश्व मॉडल: जोखिम-बिंदुओं पर सुधार
PAWM प्रस्तावित किया गया है—एक बाहरी प्रेडिक्टर, जो चरण-दर-चरण अवलोकन को दोहराता नहीं, बल्कि संभावित विफलता के समय सक्रिय होकर एजेंट को गलत कार्रवाई से दूर ले जाता है। सिंथेटिक परिदृश्यों पर SFT और GRPO के साथ सह-प्रशिक्षण के बाद, इस विधि ने Claude Sonnet 4.5 के लिए ScienceWorld में 24,3% और WebArena-Lite में 7,7% का सुधार दिया।
4 नवम्बर 2026
व्यक्तिगत आकलनों से अनुमेय समुच्चयों तक: DDI प्रतिबंधों के अंतर्गत वैश्विक डिकोडिंग
यह लेख MIMIC-III पर FLAME के निश्चित स्कोर के साथ, mixed-integer linear programming के ज़रिए लागू किए गए संगत दवाओं के सेट के सटीक वैश्विक चयन की तुलना DDI टकरावों को स्थानीय स्तर पर दूर करने की कई योजनाओं से करता है। परीक्षण नमूने पर वैश्विक विकल्प Jaccard के आधार पर थोड़ा, लेकिन लगातार बेहतर प्रदर्शन करता है; प्रतिबंध कड़े होने पर यह बढ़त और अधिक हो जाती है और सबसे मज़बूत स्थानीय आधारभूत विधि की तुलना में +0.0064 तक पहुँच जाती है।
4 नवम्बर 2026