
MetaPersona: अनुभवजन्य सामाजिक-अनुसंधान डेटा पर आधारित कार्य-विशिष्ट सिंथेटिक आबादियाँ
LLM सिमुलेशन के लिए MetaPersona-DB प्रस्तुत किया गया है—11,000 से अधिक कार्यों का एक संग्रह, जिसमें मानव नमूने हैं और कार्यों के अनुरूप चरों, संबंधों तथा समेकित आँकड़ों के साथ एनोटेशन किया गया है। इसके आधार पर यह विधि निर्भरता ग्राफ़ पुनर्निर्मित करती है और वैज्ञानिक रूप से प्रमाणित वितरणों से आबादियाँ जनरेट करती है; हालांकि, परिणामों की गुणवत्ता कार्यों और मॉडलों के अनुसार अलग-अलग होती है।
शीत शुरुआत की समस्या
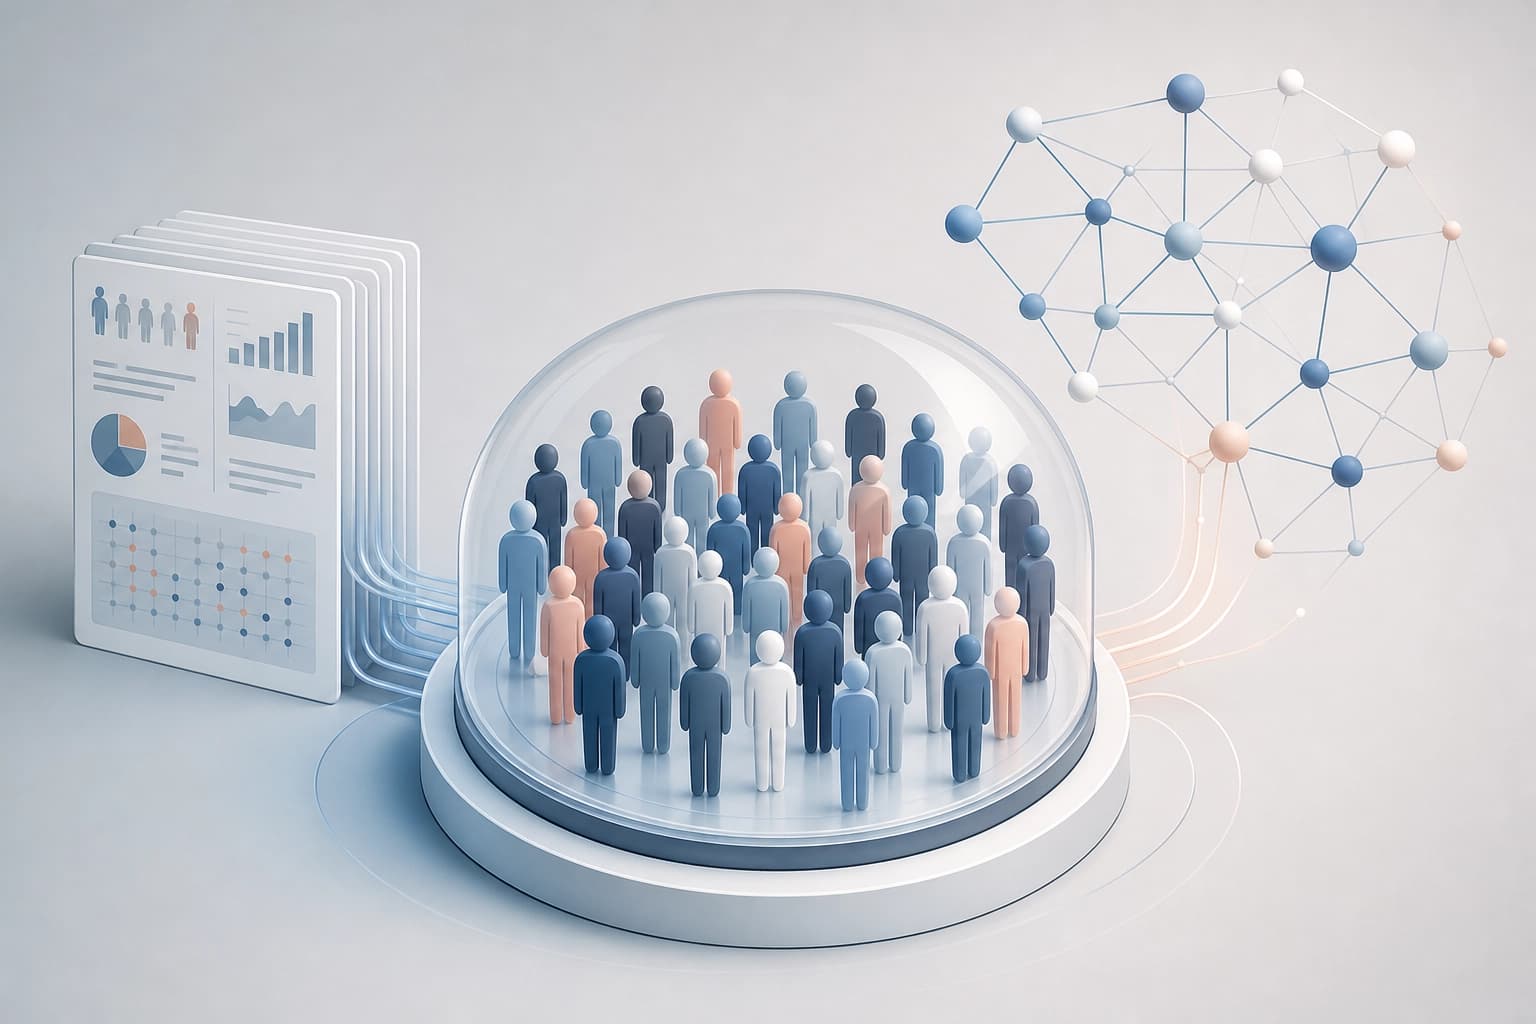
LLM के साथ सामाजिक सिमुलेशन के लिए सिंथेटिक आबादियाँ व्यक्तित्वों से बनाई जाती हैं। मौजूदा तरीकों में शामिल किए जाने वाले गुणों को चुनने और उन्हें मान देने का कोई सैद्धांतिक आधार नहीं है। arXiv:2609.38392 के लेख के लेखक इसे शीत शुरुआत की समस्या कहते हैं। इसके कारण सिंथेटिक आबादियाँ इन चीज़ों को विकृत कर सकती हैं:
- जनसांख्यिकीय संरचना;
- गुप्त गुण;
- निर्भरता की संरचना।
ये विकृतियाँ आबादी के बाद के व्यवहार को प्रभावित करती हैं। सैद्धांतिक आधार के बिना, गुणों का चयन मनमाना बना रहता है। किसी विधि के लिए मानदंड यह है कि गुणों का कार्य से जुड़ाव समझाया जा सके।
अनुभवजन्य अध्ययनों का डेटाबेस MetaPersona-DB
लेख का पूरा शीर्षक है «MetaPersona: Task-Grounded Synthetic Populations from Empirical Social Science». MetaPersona-DB में लोगों से जुड़े 11,000+ अनुभवजन्य अध्ययनों का डेटासेट है। हर अध्ययन में ये बातें एनोटेट की गई हैं:
- कार्य से संबंधित चर;
- वर्णित अंतर्संबंध;
- आबादी के समेकित आँकड़े।
MetaPersona विधि डेटाबेस से कार्य के लिए प्रासंगिक डेटा निकालती है। डेटाबेस अनुभवजन्य पूर्व वितरणों का स्रोत है, न कि तैयार व्यक्तित्वों का। मानदंड यह जाँचना है कि डेटाबेस में किसी विशिष्ट कार्य के चर और संबंध शामिल हैं या नहीं। इनके बिना विधि के पास जनरेशन को आधार देने के लिए कुछ नहीं होता।
आबादी कैसे बनाई जाती है
MetaPersona कई चरणों में आबादी बनाता है:
- कार्य के लिए प्रासंगिक डेटा निकालना।
- वैज्ञानिक साहित्य के आधार पर व्यक्तित्वों के निर्भरता ग्राफ़ बनाना।
- अनुभवजन्य पूर्व वितरणों के आधार पर सिंथेटिक आबादियाँ बनाना।
- जनसांख्यिकीय विशेषताओं, गुप्त गुणों और परिणामों को जोड़ना।
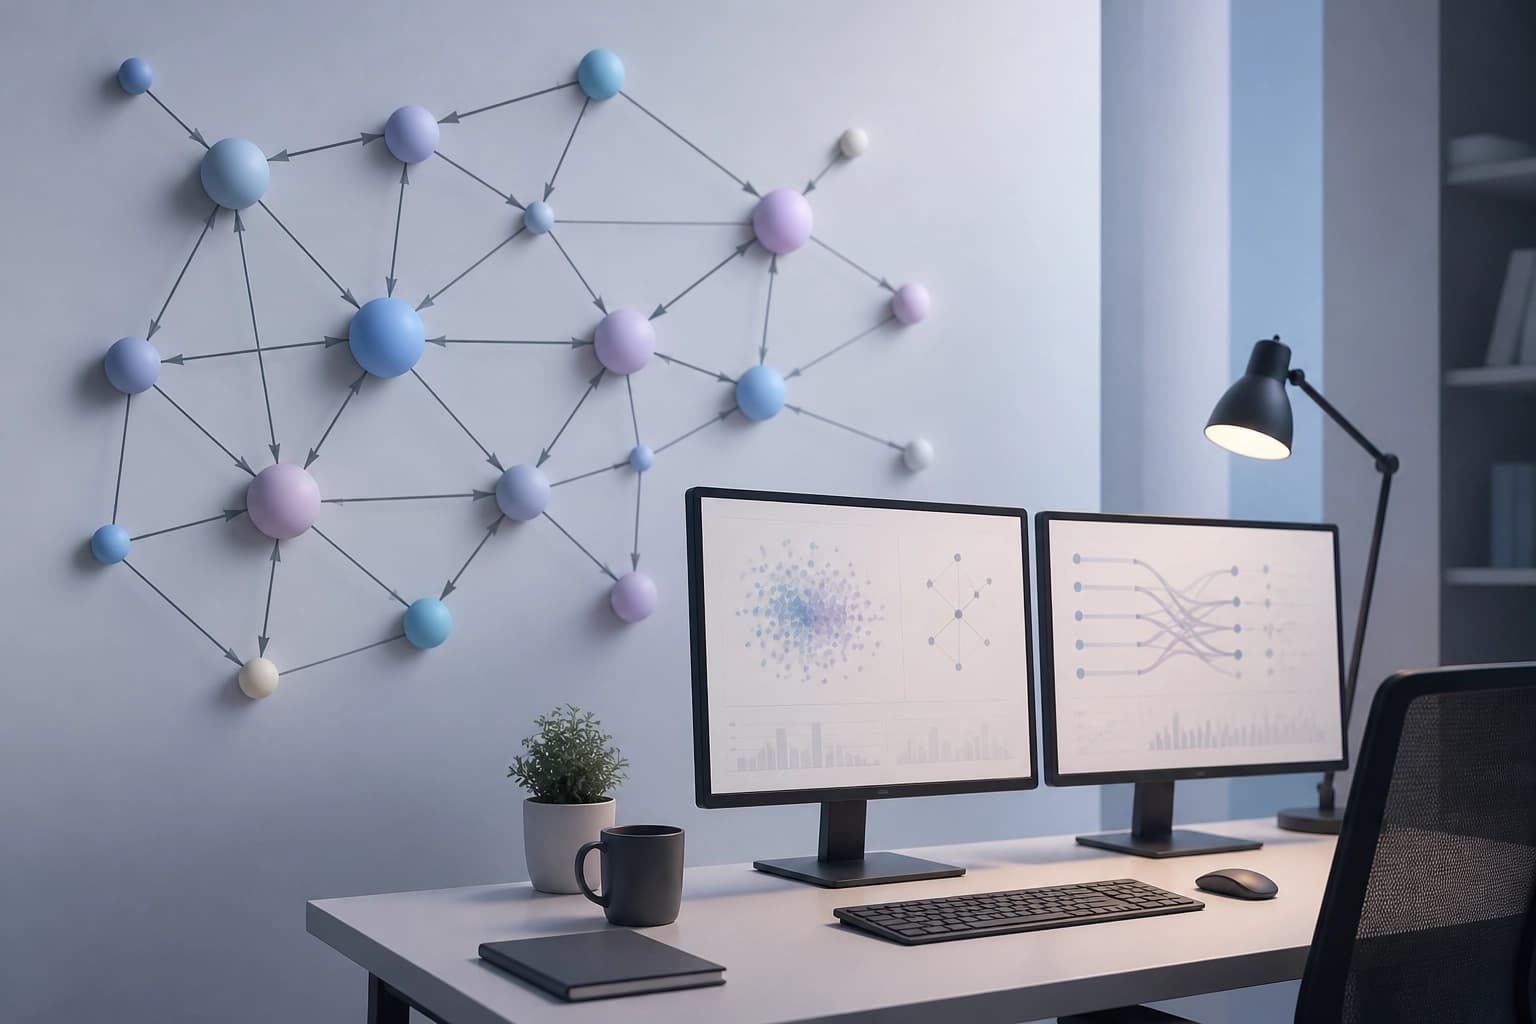
नतीजतन, किसी व्यक्तित्व को गुणों के मान हाथ से चुनकर नहीं, बल्कि अनुभवजन्य निर्भरताओं से मिलते हैं। ग्राफ़ विशेषताओं के बीच संबंधों को दर्ज करता है। यही इस दृष्टिकोण को साहित्य पर आधारित न होने वाले व्यक्तित्व जनरेशन से अलग करता है। मानदंड यह है कि कार्य से डेटा, ग्राफ़ और गुणों के मानों तक की पूरी कड़ी का पता लगाया जा सके।
मूल्यांकन के परिणाम
MetaPersona विधि का मूल्यांकन तीन अनुप्रयुक्त अध्ययनों, तीन आधारभूत विधियों और तीन अत्याधुनिक मॉडलों पर किया गया। नतीजे कार्य और मॉडल के अनुसार अलग-अलग थे।
| अनुप्रयुक्त अध्ययन | MetaPersona के परिणाम |
|---|---|
| गलत सूचना पर विश्वास | मजबूत परिणाम |
| AI टूल के प्रति भावना | मजबूत परिणाम |
| आय का पुनर्वितरण | मिले-जुले परिणाम |
यह विधि सभी कार्यों पर एक जैसा स्तर नहीं देती। व्यावहारिक मानदंड यह है कि विशिष्ट कार्य और विशिष्ट मॉडल पर मूल्यांकन किया जाए। किसी दूसरे संदर्भ का परिणाम अपने-आप लागू नहीं होता।
लागत और कार्यशील इंटरफ़ेस
मुख्य तत्व:
- GPT-5.2 का उपयोग करके व्यक्तित्व बनाने की लागत अपेक्षाकृत कम है।
- MetaPersona-Studio अनुभवजन्य डेटा पर आधारित व्यक्तित्व जनरेट करने के लिए एक इंटरैक्टिव इंटरफ़ेस का प्रोटोटाइप है।
कम लागत प्रयोगों की कुछ बाधाएँ दूर करती है। इंटरफ़ेस का प्रोटोटाइप होना बताता है कि इसे विधि से परिचित होने के एक तरीके के रूप में देखना चाहिए। मानदंड यह है कि जाँच किए बिना प्रोटोटाइप को कार्यशील बुनियादी ढाँचे का हिस्सा न बनाया जाए।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026