
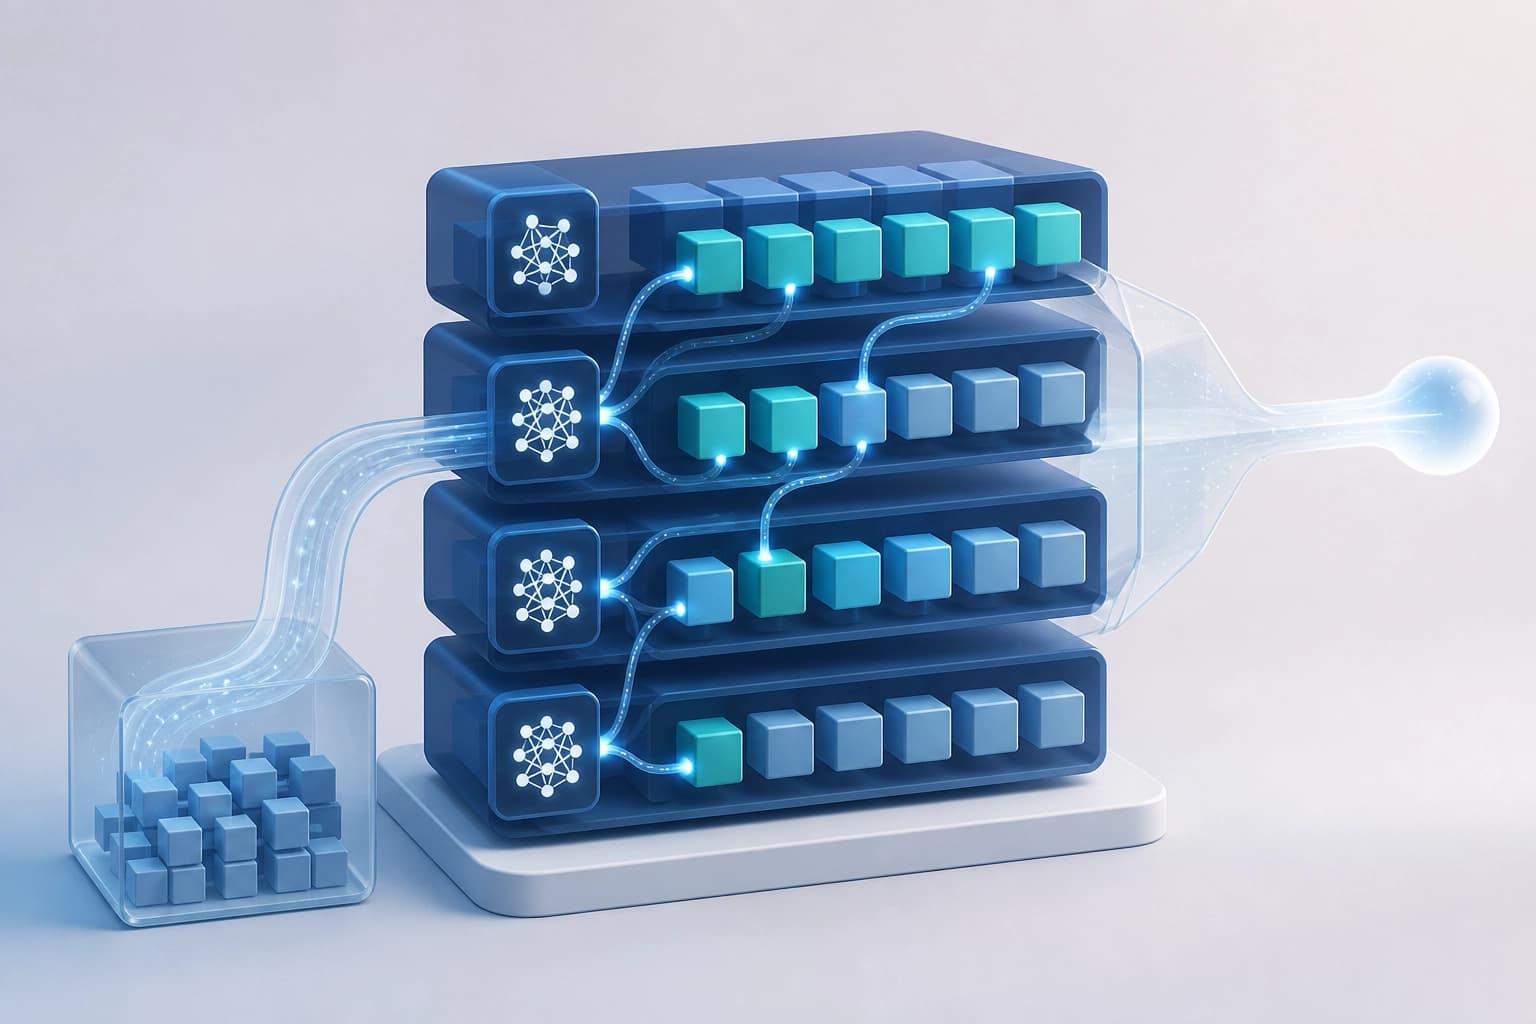
समान विशेषज्ञ बजट की समस्या
स्पार्सली-एक्टिवेटेड MoE ट्रांसफॉर्मर सभी परतों में समान संख्या में रूटेड विशेषज्ञों को निश्चित करते हैं। यह परतों के बीच अतिरेक की प्रलेखित विषमता को अनदेखा करता है।
MAPLE एक plug-and-play फ्रेमवर्क है। यह किसी भी पूर्व-प्रशिक्षित MoE LLM की परतों के बीच रूटेड विशेषज्ञों के बजट को पुनर्वितरित करता है। यह विधि वेट्स को नहीं बदलती और पुनःप्रशिक्षण की आवश्यकता नहीं रखती।
मुख्य विशेषताएँ:
- परतों में विषम बजट वितरण।
- मॉडल वेट्स में कोई संशोधन नहीं।
- कोई पुनःप्रशिक्षण नहीं।
- पूर्व-प्रशिक्षित MoE LLM पर लागू।
व्यावहारिक मानदंड: यह दृष्टिकोण तब आवश्यक है जब वेट्स में संशोधन और पुनःप्रशिक्षण के बिना विशेषज्ञों के वितरण को बदलना हो।
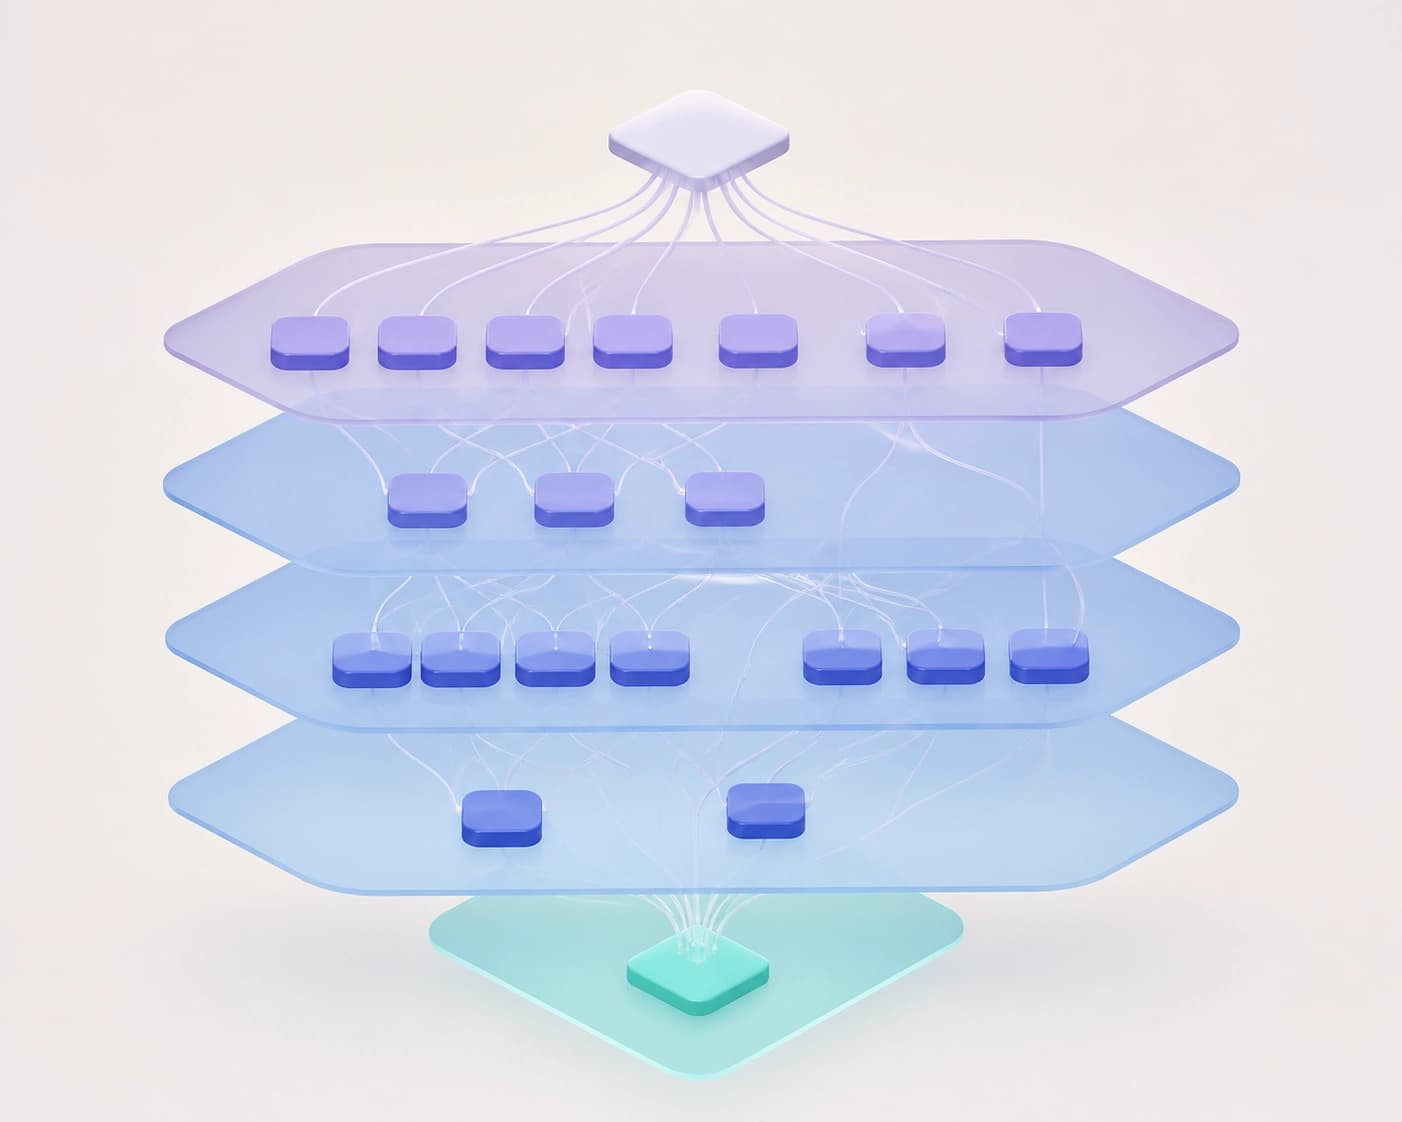
परत संवेदनशीलता और बंद सूत्र
MAPLE प्रत्येक परत की जाँच करता है। यह विधि विशेषज्ञों की संख्या में परिवर्तन पर परत की प्रतिक्रिया की जाँच करती है। संवेदनशीलता को तीन मापों से मात्रात्मक रूप से आँका जाता है।
बजट स्थानांतरण के चरण:
- प्रत्येक परत की जाँच।
- विशेषज्ञों की संख्या में परिवर्तन पर प्रतिक्रिया का मूल्यांकन।
- तीन मापों से संवेदनशीलता का मात्रात्मक मूल्यांकन।
- विश्लेषणात्मक रूप से इष्टतम बजट वितरण की व्युत्पत्ति।
- संवेदनशीलता-सीमित आनुवंशिक खोज द्वारा परिष्करण।
विश्लेषणात्मक वितरण क्षमता को संवेदनशील परतों की ओर निर्देशित करता है। अतिरेक वाली परतों में बजट में कमी अवशोषित हो जाती है। आनुवंशिक खोज परत-वार संवेदनशीलता को प्रायर के रूप में उपयोग करती है। यह तेज़ अभिसरण और बेहतर वितरण गुणवत्ता देती है।
निष्कर्ष: बजट स्थानांतरण समान नियम पर नहीं, बल्कि मापी जा सकने वाली संवेदनशीलता पर आधारित है।
समान और pruning-आधारित दृष्टिकोणों से तुलना
MAPLE विभिन्न पैमाने और आर्किटेक्चर के चार MoE मॉडलों पर समान और pruning-based baselines से बेहतर प्रदर्शन करता है। तुलना 75% रूटेड विशेषज्ञ बजट पर की जाती है।
| विकल्प | रूटेड विशेषज्ञ बजट | परिणाम |
|---|---|---|
| समान baseline | 75% | MAPLE से कमतर |
| Pruning-based baseline | 75% | MAPLE से कमतर |
| MAPLE | 75% | दोनों baseline से बेहतर |
| समान baseline | 100% | ARC-E, ARC-C और BoolQ पर DeepSeek-MoE-16B में 75% वाले MAPLE से कमतर |
DeepSeek-MoE-16B पर MAPLE केवल 75% विशेषज्ञों का उपयोग करता है। फिर भी यह ARC-E, ARC-C और BoolQ पर मूल 100%-समान baseline से आगे निकल जाता है।
सटीकता में वृद्धि:
- ARC-E: 65,09 से 71,40 तक।
- ARC-C: 48,49 से 51,50 तक।
- BoolQ: 80,03 से 82,38 तक।
निष्कर्ष: विषम वितरण अधिक संख्या में विशेषज्ञों को शामिल करने की तुलना में अधिक प्रभावी हो सकता है।
SGLang में सर्विंग के दौरान दक्षता
SGLang में MAPLE का कार्यान्वयन एक GPU पर end-to-end सर्विंग विलंबता को 32,2% कम करता है। थ्रूपुट 47,4% बढ़ता है।
यह विधि वेट्स को नहीं बदलती। इसलिए इसे मौजूदा MoE सर्विंग स्टैक में एकीकृत किया जा सकता है। यह बजट स्थानांतरण को इन्फरेंस के लिए एक व्यावहारिक लीवर बनाता है।
व्यावहारिक मानदंड: SGLang के माध्यम से single-GPU सर्विंग के लिए यह विधि विलंबता में कमी और थ्रूपुट में वृद्धि देती है।
चयन मानदंड
MAPLE पर कई मामलों में विचार किया जाना चाहिए:
- पुनःप्रशिक्षण के बिना रूटेड विशेषज्ञों का बजट कम करना हो।
- मॉडल एक पूर्व-प्रशिक्षित MoE LLM हो।
- समान नियम के बजाय परत-वार विषमता को ध्यान में रखना हो।
- MoE इन्फरेंस की दक्षता बढ़ानी हो।
निष्कर्ष: विशेषज्ञों का विषम वितरण MoE दक्षता बढ़ाने की एक मूलभूत और व्यावहारिक धुरी बन जाता है।


