
संक्षेप में: बात असल में किस बारे में है
अगस्त 2026 में arXiv पर एक पेपर आया, जिसका नाम लगभग रोज़मर्रा का-सा था — «Software Defined Dataflow System for Large-scale AI Acceleration»। इसके पीछे Maia 200 नाम के एक्सेलेरेटर का विवरण है, और यह «वाट पर और भी ज़्यादा फ्लॉप्स» वाली कोई अगली कड़ी नहीं है। यहाँ मुख्य विचार आर्किटेक्चरल है: लेखक सुझाव देते हैं कि AI चिप की बुनियादी बनावट में ही ज़ोर कहाँ दिया जाए, यह बदल देना चाहिए।
यह सामग्री 25 अगस्त 2026 को cs.AR सेक्शन में भेजी गई थी, भेजने वाले हैं टोर्स्टन ह्योफ़लर, और लेखकों की सूची में कुल 17 लोग हैं (शेरी स्यू और सोलह अन्य शोधकर्ता)। यह पेपर एक साथ कई श्रेणियों में वर्गीकृत है: हार्डवेयर आर्किटेक्चर, आर्टिफ़िशियल इंटेलिजेंस, वितरित और समानांतर कंप्यूटिंग, नई तकनीकें और मशीन लर्निंग। यानी यह दावा किसी «हार्डवेयर» नोट के तौर पर नहीं, बल्कि एक ऐसी अवधारणा के तौर पर किया गया है जो पूरे स्टैक से जुड़ती है।
कमांड की जगह डेटा: इस बदलाव का सार
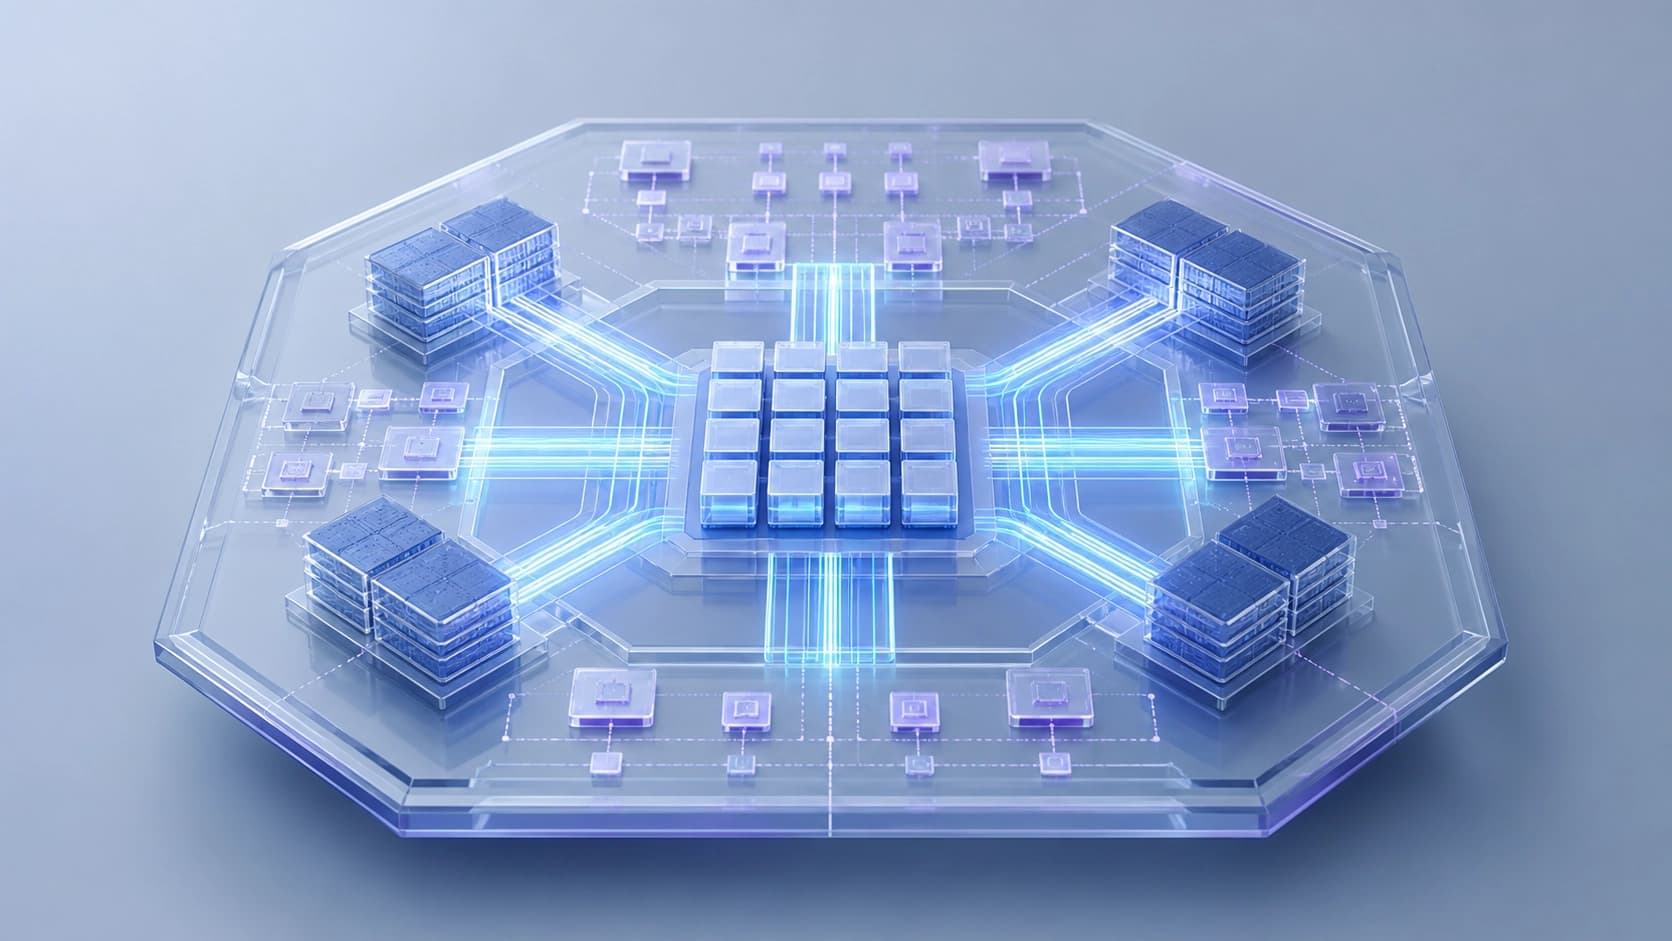
पारंपरिक एक्सेलेरेटर कमांड के प्रवाह के इर्द-गिर्द बना होता है। कोर हैं, शेड्यूलर है, कैश का पदानुक्रम है — और यह पूरी बनावट निर्देशों के निष्पादन की सेवा करती है। ऐसे मॉडल में मेमोरी की भूमिका सेवा-कर्मी जैसी होती है: डेटा समय पर पहुँचा दो, बाकी हम संभाल लेंगे।
Maia 200 में यह तर्क उलट जाता है। लेखक इस चिप को एक नए वर्ग में रखते हैं — Software Defined Locally Accessed Dataflow Architectures, संक्षेप में SDLA। यहाँ मुख्य शब्द है «software defined»: dataflow इंजन सिर्फ़ सिलिकॉन में मौजूद नहीं होते, उन्हें स्पष्ट रूप से प्रोग्राम किया जाता है। प्रोग्रामर बताता है कि विशेषीकृत मेमोरी ब्लॉकों और डेटा-स्थानांतरण इंजनों को ठीक किस तरह ऑर्केस्ट्रेट किया जाना चाहिए। नियंत्रण स्पष्ट हो जाता है, पाइपलाइन का गौण प्रभाव नहीं रहता।
यहीं से ज़ोर का केंद्र भी बदल जाता है: thread-centric नहीं, बल्कि data-movement-centric। «प्रति चक्र कितने निर्देश» वाला सवाल पीछे छूट जाता है और आगे आता है सवाल «डेटा कितनी तेज़ी से और बिना नुकसान उस जगह पहुँचता है जहाँ उसकी गणना होनी है»। आधुनिक वर्कलोड के लिए ये मूल रूप से अलग-अलग समस्याएँ हैं।
आँकड़े
सारांश से निकले ठोस आँकड़े इस तरह हैं:
- 10 145 Tflop/s FP4 फ़ॉर्मैट में;
- 5072 Tflop/s FP8 में;
- मेमोरी बैंडविड्थ HBM — 7 TB/s;
- थर्मल पैकेज — 750 W।
ये आँकड़े क्या बताते हैं — और क्या नहीं
FP4 में 10 145 Tflop/s की तुलना तुरंत किसी जानी-पहचानी चीज़ से करने का लालच बड़ा होता है, लेकिन ठीक-ठीक तुलना करने के लिए कुछ है ही नहीं: लेखक किसी विशिष्ट मॉडल पर मापन प्रकाशित नहीं करते, और अलग-अलग परिशुद्धता फ़ॉर्मैट तथा अलग-अलग मापन-विधियाँ ऐसे आँकड़े देती हैं जिनकी आपस में तुलना नहीं हो सकती। अलग से यह भी ध्यान में रखना चाहिए कि बहुत कम परिशुद्धता (FP4) हमेशा गुणवत्ता से समझौता होती है, और आँकड़ों में बढ़त का मतलब उपयोगी काम में बढ़त नहीं होता।
यहाँ 7 TB/s कहीं ज़्यादा दिलचस्प है। यही विशेषता लेख के मुख्य विचार से ताल मिलाती है: अगर आर्किटेक्चर डेटा के स्थानांतरण के इर्द-गिर्द बना है, तो मेमोरी बैंडविड्थ कोई गौण पैरामीटर नहीं, बल्कि भार वहन करने वाली संरचना है। और 750 W यह याद दिलाता है कि बात रैक की हो रही है, डेस्कटॉप कार्ड की नहीं।
SDLA और नई वर्गीकरण-पद्धति
यह समझाने के लिए कि ऐसी चिप आम चिपों से कैसे अलग है, लेखक डेटा-प्रबंधन की एक वर्गीकरण-पद्धति बनाते हैं। इसका आधार है पुरानी फ़्लिन वर्गीकरण-पद्धति, जो मशीनों को कमांड और डेटा के प्रवाहों की संख्या के आधार पर बाँटती थी। वह उस युग के लिए सुविधाजनक भाषा थी जब अड़चन निष्पादन में थी।
अब, लेखकों के विचार से, एक और भाषा चाहिए — इस बारे में कि सिस्टम डेटा का प्रबंधन कैसे करता है। यह वर्गीकरण «कितना» के बारे में नहीं, बल्कि «कैसे संगठित है» के बारे में होता है। और इस ढाँचे में SDLA एक अलग खाना भरता है: ऐसा आर्किटेक्चर जहाँ मेमोरी और डेटा का स्थानांतरण प्रथम श्रेणी के नागरिक हैं, पृष्ठभूमि नहीं।
ऐसी वर्गीकरण-पद्धति का व्यावहारिक अर्थ आरेखों से लगाव नहीं है। यह इंजीनियरों को एक शब्दावली देती है: यह समझदारी से बहस की जा सकती है कि कोई ठोस हार्डवेयर किस वर्ग में आता है और उसके लिए कौन-से काम उपयुक्त हैं, बजाय इसके कि हर चीज़ एक ही संख्या से नापी जाए।
इन्फ़रेंस के लिए यह क्यों ज़रूरी है
इन्फ़रेंस काफ़ी हद तक इस बारे में है कि चिप के ज़रिए वज़न और एक्टिवेशन की विशाल मात्रा कम-से-कम विलंबता के साथ निकाली जाए। मॉडल जितना बड़ा होता है, सब कुछ उतना ही ज़्यादा अंकगणित पर नहीं, बल्कि मेमोरी और ब्लॉकों के बीच संबंधों पर अटकता है। यहाँ दक्षता इस बात से तय होती है कि सिस्टम डेटा को कितनी अच्छी तरह हिला पाता है।
लेखकों का दावा है कि Maia 200 लागत और ऊर्जा में उल्लेखनीय बचत देता है, और बड़े पैमाने का समानांतरवाद ठीक इन्फ़रेंस वर्कलोड पर बनाए रखता है। अगर यह असली कामों पर सही साबित होता है, सिर्फ़ सिंथेटिक बेंचमार्क पर नहीं, तो बात एक अलग संतुलन की होगी: «सबसे तेज़ चिप» नहीं, बल्कि «वह चिप जिसे उतनी ही संख्या में अनुरोधों पर सस्ते में चलाया जा सकता है»। डेटा-सेंटरों के लिए, जहाँ हिसाब मेगावाट में होता है, यही वह तर्क है जो भारी पड़ता है।
क्या बात पर्दे के पीछे रह गई
सावधानी कुछ चेतावनियाँ माँगती है। यह काम एक प्रीप्रिंट है: arXiv:2608.24664, DOI 10.48550/arXiv.2608.24664, PDF, प्रायोगिक HTML संस्करण और TeX स्रोत उपलब्ध हैं। समीक्षण, स्वतंत्र मापन और परिणामों का पुनरुत्पादन — सब आगे है। ऊर्जा और पैसे की बचत के वादों को लेखकों का कथन पढ़ना चाहिए, किसी तीसरे पक्ष का मापा हुआ तथ्य नहीं।
दूसरा सवाल है बदलाव की कीमत। प्रोग्रामेबल dataflow अलग सोच माँगता है: डेवलपर को डेटा के मार्ग स्पष्ट रूप से बताने होंगे, और कंपाइलरों तथा फ़्रेमवर्कों को यह इस्तेमाल करना सीखना होगा। जब तक इकोसिस्टम साथ नहीं आता, हार्डवेयर के फ़ायदे सबको और तुरंत नहीं दिखेंगे। किसी भी आर्किटेक्चरल मोड़ के साथ ऐसा ही हुआ है: पहले अवधारणा, फिर औज़ार, फिर व्यापक स्वीकृति।
और फिर भी इस कहानी में मुख्य बात कोई ठोस टेराफ़्लॉप्स नहीं है। ज़्यादा ज़रूरी है खुद वह सूत्रीकरण: AI गणनाओं की अड़चन वहाँ खिसक गई है जहाँ डेटा यात्रा करता है, वहाँ नहीं जहाँ कमांड निष्पादित होते हैं। अगर यह विचार सही है, तो अगली पीढ़ियों की चिपें अलग तरह से डिज़ाइन की जाएँगी — और हो सकता है कि गिनती ठीक इसी काम से शुरू हो।


