पेजों के लिए साझा स्केच क्यों काम नहीं करता
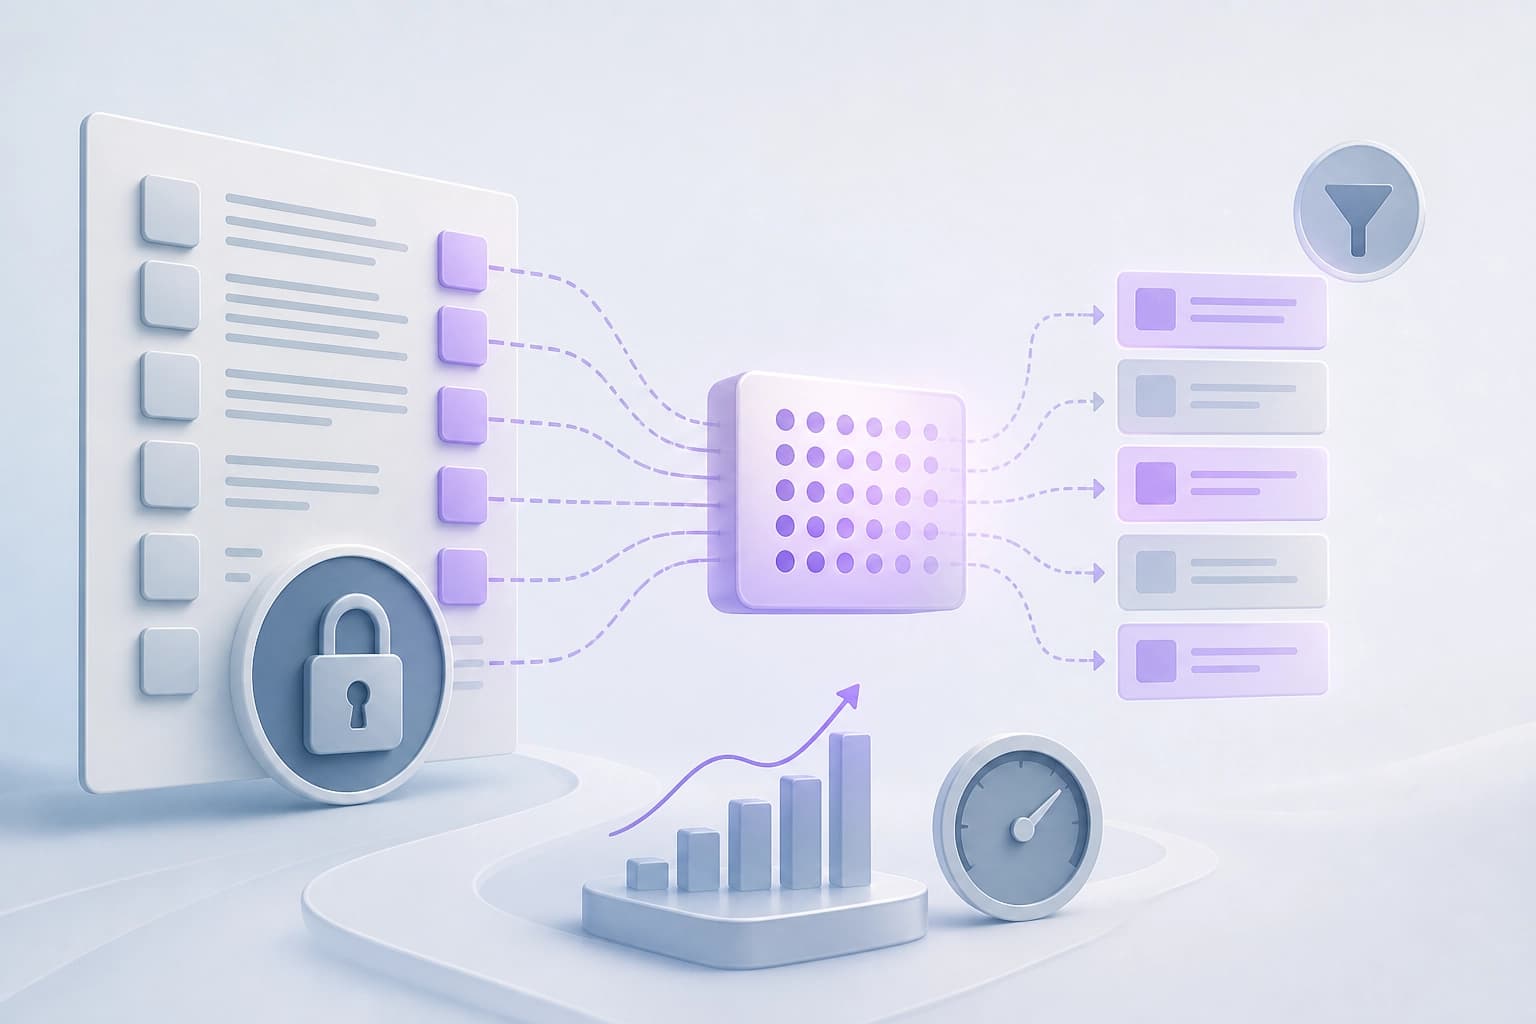
लंबे संदर्भ पर बड़े भाषा मॉडल चलाना key-value (KV) cache पर टिकता है। कैश हर डिकोडिंग चरण में पूरा पढ़ा जाता है। Attention keys locally low-rank होती हैं, हालाँकि globally high-rank। पेजों के लिए साझा एक निश्चित low-rank sketch, पेज दिशाओं के प्रति सिद्ध रूप से अंधा है।
उसी summary आकार पर, पेज का अपना आधार पेजों को बेहतर रैंक करता है और वाहकों को कहीं बेहतर सुरक्षित रखता है। साझा स्केच उन दिशाओं को नहीं देखता। प्रति-की spectral summary समस्या हल करता है।
प्रति पेज spectral सारांश
LOCKS हर पेज को अपना rank-r spectral summary देता है। सारांश रेसिडेंट है: r=8 पर कैश का दसवाँ हिस्सा और r=2 पर पच्चीसवाँ हिस्सा। यह विधि पेज-आंतरिक लॉजिट्स का पुनर्निर्माण करती है। यह log-sum-exp के ज़रिए हर पेज के attention द्रव्यमान का अनुमान लगाती है। फिर केवल शीर्ष पेजों को संसाधित करती है।
मुख्य तत्व:
- नाम: Page-Local Compact Key Summaries for Efficient Long-Context Decoding.
- सारांश: हर पेज के लिए rank-r spectral summary।
- रेसिडेंसी: r=8 पर कैश का दसवाँ हिस्सा, r=2 पर पच्चीसवाँ हिस्सा।
- पुनर्निर्माण: पेज-आंतरिक लॉजिट्स।
- अनुमान: log-sum-exp के ज़रिए पेज का attention द्रव्यमान।
- चयन: केवल शीर्ष पेज।
निष्कर्ष: सारांश कैश का एक हिस्सा लेता है, लेकिन पेज विशेषताएँ सुरक्षित रखता है। पेजों का चयन spectral डेटा के आधार पर होता है।
कीज़ पढ़े बिना ब्लॉक चयन
चयन स्वयं उम्मीदवारों की कीज़ या वैल्यूज़ नहीं पढ़ता। चुनाव केवल spectral सारांश के आधार पर होता है। सारांश हर चरण में पूरा स्कैन किया जाता है। प्रति चरण KV पढ़ना बताए गए रैंक रेंज में 10–25 गुना गिर जाता है।
प्रति टोकन डिकोडिंग विलंबता आधी हो जाती है। एक H200 NVL पर 1M टोकन पर, r=8 पर गति 2.0× होती है। यह dense attention से तुलना है। चयन उम्मीदवार कीज़ पढ़ने पर निर्भर नहीं है।
लंबे कार्यों पर गुणवत्ता
LOCKS कई प्रकार के कार्यों पर गुणवत्ता बनाए रखता है। long-document QA (LongBench-v1; Llama-3.1-8B) पर परिणाम पूर्ण कैश से एक अंक के भीतर रहता है। retrieval-dense RULER पर यह विधि सटीक LSE-ओरेकल का अनुसरण करती है, जो सबसे छोटे बजट तक हर की पढ़ता है। long-form reasoning (AIME26, MATH-500; Qwen3-4B) पर गुणवत्ता छोटे बजट मोड में सबसे दूर तक टिकती है। वहाँ eviction-आधारित reasoning सेलेक्टर और कंप्रेसर पीछे हट जाते हैं।
2048 टोकन के बजट पर LOCKS, 100K+ संदर्भ (GLM-4-9B-Chat-1M) पर FullKV की समग्र गुणवत्ता से मेल खाता है। साथ ही यह विधि 2% टोकन संसाधित करती है।
| शर्त | परिणाम |
|---|---|
| Long-document QA (LongBench-v1; Llama-3.1-8B) | पूर्ण कैश से एक अंक के भीतर |
| Retrieval-dense RULER | छोटे बजट तक सटीक LSE-ओरेकल का अनुसरण |
| Long-form reasoning (AIME26, MATH-500; Qwen3-4B) | छोटे बजट में गुणवत्ता सबसे दूर तक टिकाता है |
| 2048-टोकन बजट, 100K+ संदर्भ (GLM-4-9B-Chat-1M) | FullKV से मेल खाता है, 2% टोकन संसाधित करता है |
निष्कर्ष: सूचीबद्ध कार्यों पर यह दृष्टिकोण सेलेक्टर और eviction-based कंप्रेसर की तुलना में गुणवत्ता अधिक देर तक बनाए रखता है।
तैनाती और चयन मानदंड
यह दृष्टिकोण बिना संशोधित vLLM के लिए drop-in प्लगइन के रूप में आता है। बैच डिकोडिंग पूर्ण CUDA ग्राफ़ में काम करती है। vLLM में संशोधन की आवश्यकता नहीं है।
चयन मानदंड: लंबा संदर्भ, सीमित टोकन बजट, KV पढ़ना और डिकोडिंग विलंबता घटाने की आवश्यकता। यदि कार्य में उम्मीदवार कीज़ पढ़े बिना ब्लॉक चयन चाहिए, तो यह दृष्टिकोण उपयुक्त है।