
इनपुट में विविधता, तर्क-विचार में नहीं: LLM के लिए टेस्ट-टाइम ऑगमेंटेशन विधियों की तुलना
यह अध्ययन समान संख्या में कॉल के साथ LLM इन्फ़रेंस में विविधता के स्रोतों—प्रॉम्प्ट का पुनर्लेखन, वर्तनी में बदलाव और छवियों में रूपांतरण—की तुलना करता है। छह बेंचमार्क पर, अर्थ को बनाए रखने से सटीकता में सबसे अधिक सुधार हुआ, जबकि अक्षर-दर-अक्षर शोर और दो मोडैलिटी में एक साथ किए गए बदलाव कम उपयोगी साबित हुए।
विविधता के दो स्रोत: इनपुट और तर्क
Test-Time Augmentation (TTA) इनपुट डेटा के रूपांतरित संस्करणों पर की गई भविष्यवाणियों को मिलाता है। विविधता सवाल को नए शब्दों में रखने, उसकी वर्तनी बदलने या साथ दी गई छवियों को रूपांतरित करने से पैदा होती है। Self-consistency अलग तरीके से काम करता है: यह सिर्फ़ तर्क के रास्ते को बदलता है और एक निश्चित इनपुट का फिर से उपयोग करता है।
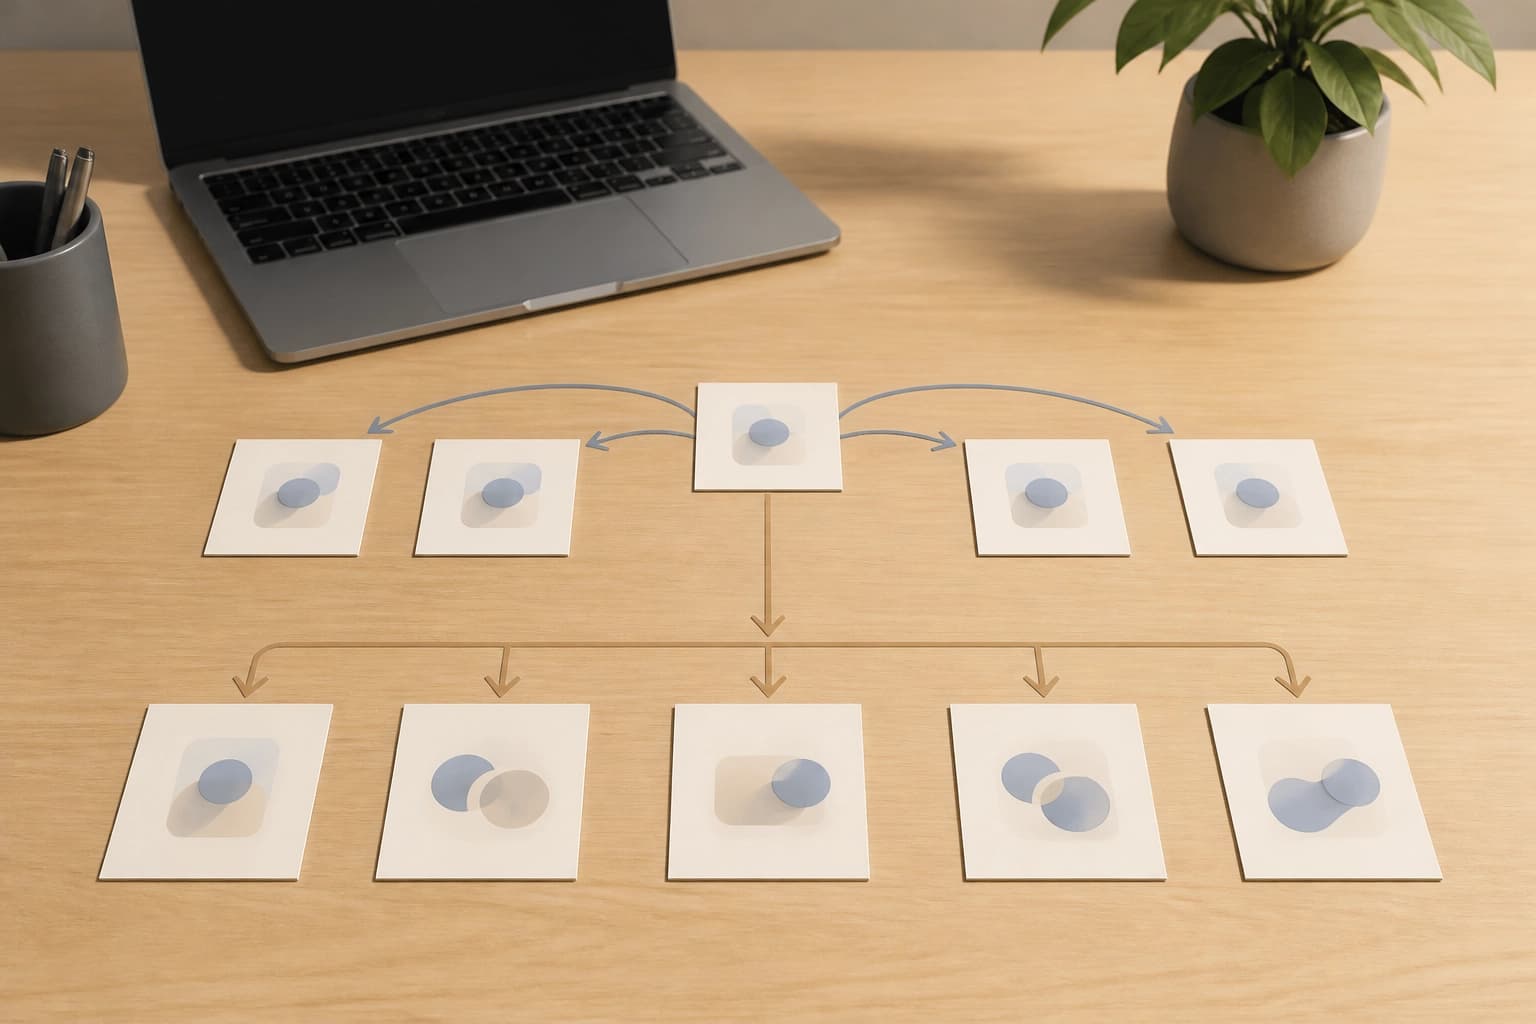
| विधि | विविधता का स्रोत |
|---|---|
| TTA | इनपुट डेटा के रूपांतरित संस्करण |
| Self-consistency | निश्चित इनपुट पर तर्क का रास्ता |
TTA इनपुट में बदलावों के प्रति स्थिरता जाँचता है। Self-consistency एक ही इनपुट पर तर्क की स्थिरता जाँचता है। चुनाव इस बात पर निर्भर करता है कि कार्य के लिए विविधता का कौन-सा स्रोत चाहिए।
इन्फ़रेंस कॉल की समान संख्या से निष्कर्ष क्यों बदलता है
लेखकों ने छह बेंचमार्क पर विकल्पों की तुलना की। इन्फ़रेंस कॉल की संख्या समान थी। यह शर्त विविधता के स्रोत के प्रभाव को अतिरिक्त गणना के प्रभाव से अलग करती है।
- छह बेंचमार्क;
- कॉल की समान संख्या;
- स्रोतों की तुलना, मात्रा की नहीं।
लेखकों के अनुसार, विविधता का स्रोत उसकी मात्रा से ज़्यादा महत्वपूर्ण है। चुनाव के लिए निष्कर्ष: तरीकों की तुलना समान संख्या में कॉल के साथ करनी चाहिए। अन्यथा, सटीकता में हुई बढ़ोतरी का श्रेय स्रोत को दिया जा सकता है, न कि अतिरिक्त कॉल को।
नए शब्दों में लिखना: बढ़त और शुरुआती शिखर
अर्थ को बरकरार रखते हुए इनपुट को नए शब्दों में लिखने से सटीकता में सबसे ज़्यादा बढ़त मिली। एक कॉल की तुलना में यह बढ़त +1.80 प्रतिशत अंक थी। सबसे कम नमूनों के साथ ही सटीकता शिखर पर पहुँच गई।
Claude Haiku जैसी मध्यम स्तर की मॉडलों के लिए, सवाल की शब्दावली बदलना इन्फ़रेंस कॉल का, तर्क के रास्ते को बदलने से अधिक प्रभावी उपयोग साबित हुआ।
व्यावहारिक निष्कर्ष: अगर रूपांतरण अर्थ को बरकरार रखता है, तो नए शब्दों में लिखना TTA के लिए पहला विकल्प है। इससे बढ़त भी मिलती है और सटीकता जल्दी शिखर पर पहुँचती है।
अक्षर-दर-अक्षर शोर: बहुत अधिक मतभेद, कम फ़ायदा
अक्षर-दर-अक्षर शोर से जवाबों के बीच अधिक मतभेद हुए: 37.8% बनाम 27.4%। सटीकता में बढ़त कम रही। जवाबों में अधिक विविधता का मतलब यह नहीं कि उन्हें एकत्रित करने से फ़ायदा होगा।
अर्थ बिगाड़ने के बाद पैदा होने वाले मतभेद गलत होते हैं। ऐसे मतभेद एकत्रीकरण के लिए उपयोगी संकेत नहीं देते।
व्यावहारिक निष्कर्ष: सिर्फ़ मतभेदों के अनुपात को नहीं, बल्कि सटीकता को आँकें। अक्षर-दर-अक्षर शोर, अर्थ को बरकरार रखने वाले रूपांतरणों का विकल्प नहीं है।
दोहरा व्यवधान: कब संयोजन का प्रदर्शन गिरता है
दो मोडैलिटी में एक साथ व्यवधान डालने से नतीजा एक कॉल के आधारभूत स्तर से नीचे रहा। रूपांतरणों का संयोजन जीत की गारंटी नहीं देता।
- एक साथ दो मोडैलिटी में व्यवधान;
- नतीजा एक कॉल के आधारभूत स्तर से नीचे;
- संयोजन का अलग से परीक्षण।
व्यावहारिक निष्कर्ष: मोडैलिटी को केवल अलग-अलग तुलना करने के बाद ही मिलाएँ। अन्यथा, TTA का प्रदर्शन एक कॉल से भी नीचे जा सकता है।
विधि का व्यावहारिक चुनाव
चुनाव के मानदंड विविधता के स्रोत, अर्थ को बनाए रखने और कॉल की समान संख्या पर आधारित हैं।
| कार्य | विधि |
|---|---|
| शब्दावली के प्रति स्थिरता जाँचना | नए शब्दों में लिखने के साथ TTA |
| उसी इनपुट पर तर्क की स्थिरता जाँचना | self-consistency |
| वर्तनी के प्रति संवेदनशीलता आँकना | अक्षर-दर-अक्षर शोर के साथ TTA |
| मोडैलिटी को मिलाना | केवल अलग से तुलना करने के बाद |
व्यावहारिक मानदंड: कार्य के अनुसार विविधता का स्रोत चुनें। TTA से सटीकता बढ़ाने के लिए, नए शब्दों में लिखने से सबसे बड़ा मापा गया प्रभाव मिलता है। उसी इनपुट पर तर्क की जाँच के लिए self-consistency उपयुक्त है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
उम्मीदवारों का सत्यापन उन्हें उत्पन्न करने से अधिक महँगा है: LLM-आधारित भेद्यता खोज के विरुद्ध प्रलोभन
इस काम में एजेंट-आधारित दोष खोज की लागत संबंधी विषमता का विश्लेषण किया गया है: संस्करण बनाना सस्ता है, जबकि पहुँच-योग्यता विश्लेषण, निष्पादन और PoC के ज़रिए उनकी पुष्टि करने में अधिकांश बजट खर्च होता है। इसलिए सत्यापन को रक्षा का एक स्वतंत्र लक्ष्य बनाया जा सकता है। प्रस्तावित RedHerring—रिपॉज़िटरी के अनुरूप ढाली गई, सीलबंद प्रमाणपत्र वाली decoy—ने समान लागत पर 33 OSS-Fuzz परियोजनाओं में पाई गई वास्तविक कमज़ोरियों की संख्या 38.7–60.4% तक घटा दी; एजेंट को चेतावनी देने के बाद भी यह गिरावट 37.2% पर बनी रही।
9 नवम्बर 2026
बिना फ़ाइन-ट्यूनिंग के स्रोतों के SQL व्यू के ज़रिए LLM के भ्रमों की जाँच
यह काम जाँचता है कि क्या LLM मतिभ्रम का पता लगाने के लिए बिना पर्यवेक्षण के स्रोत से जोड़ने हेतु एक बुनियादी प्रतीकात्मक कौशल—स्रोत दस्तावेज़ों के आधार पर SQL डेटाबेस बनाना—का उपयोग कर सकता है। RAGTruth और DiaHalu पर यह न्यूरो-सिम्बॉलिक पाइपलाइन सीधे भविष्यवाणी करने से अधिक सटीक साबित होती है और अत्याधुनिक तरीकों के बराबर प्रदर्शन करती है, जबकि इसके लिए डोमेन-विशिष्ट फ़ाइन-ट्यूनिंग की आवश्यकता नहीं होती।
9 नवम्बर 2026
MathAdv: मशीन-निर्मित प्रमाणों की अंतिम सटीकता के पीछे क्या छिपा है?
गणित के 13 स्नातक और स्नातकोत्तर विषयों के कार्यों का यह नैदानिक समूह Lean 4 में स्वचालित प्रमेय-प्रमाणन प्रणालियों का मूल्यांकन केवल अंतिम परिणाम के आधार पर नहीं, बल्कि विषय पर उनकी पकड़, अनौपचारिक तर्क की गुणवत्ता और शर्तों को नए शब्दों में प्रस्तुत किए जाने पर उनकी मजबूती के आधार पर भी करता है। घटक-वार विश्लेषण से पता चलता है कि किसी समस्या को औपचारिक रूप में बदलना अब भी सबसे बड़ी बाधा है, और सफलता गणित के क्षेत्र तथा समस्या को प्रस्तुत करने के तरीके पर बहुत अधिक निर्भर करती है।
9 नवम्बर 2026