
उर्दू जाँच से बाहर: क्यों LLM अपरिचित लिपि में नफ़रत को छोड़ देते हैं
पाँच प्रसिद्ध मॉडल — GPT-4o से Llama-3.1 तक — एक ही टेक्स्ट पर अलग-अलग फैसले देते हैं, अगर वह उर्दू में लिखा हो, अंग्रेज़ी अनुवाद में नहीं: अंतर एक-तिहाई मामलों तक पहुँच जाता है, और स्पष्ट रूप से शत्रुतापूर्ण सामग्री का एक हिस्सा बिना चिह्नित किए रह जाता है। WOAH के नौ साल के प्रकाशनों के विश्लेषण से पता चला कि इसमें इस भाषा पर कोई अलग कार्य समर्पित नहीं है।
संक्षेप में: समस्या भाषा में नहीं, लिपि में है
बड़े भाषा मॉडलों के सुरक्षा फ़िल्टर आमतौर पर अंग्रेज़ी पर आँके जाते हैं। यहीं से एक सुविधाजनक भ्रम पैदा होता है: अगर मॉडल अंग्रेज़ी पाठ में गालियों और हिंसा की अपीलों को भरोसे के साथ पकड़ लेता है, तो अन्य भाषाओं में भी लगभग वैसा ही प्रदर्शन करेगा। उर्दू — लगभग 246 मिलियन वक्ताओं वाली भाषा, इस मामले में दुनिया में दसवें स्थान पर — ऐसी जाँच में लगभग शामिल ही नहीं होती। और इस अंतराल की, जैसा कि पता चलता है, एक मापनीय कीमत है।
इसी पर — arXiv पहचानकर्ता 2608.24191 वाला ताज़ा शोध। «Ghaib in Translation» शीर्षक ghaib शब्द पर आधारित है, जिसका उर्दू में अर्थ है «छिपा हुआ, अदृश्य»: बात उस नुकसान की हो रही है जो अनदेखा रह जाता है। लेखक हैं — Fawzia Zehra (Fuzzy) Kara-Isitt, Sonal Khosla और Stephen Swift। पहला संस्करण 25 अगस्त 2026 को आया, अद्यतन संशोधन — उसी वर्ष 9 सितंबर को; यह पेपर cs.CL और cs.AI श्रेणियों से संबंधित है, DOI — 10.48550/arXiv.2608.24191।
प्रयोग कैसे बनाया गया
मॉडल और डेटा
टीम ने वर्गीकरण के एक ही परिदृश्य से पाँच लोकप्रिय मॉडलों को गुज़ारा: GPT-4o, Claude Sonnet 4.5, Gemini 2.5 Flash, Qwen-2.5 और Llama-3.1। डेटासेट — छह डेटासेट, जो भाषा के चार अलग-अलग रूपों को कवर करते हैं: नस्तालीक़ लिपि में उर्दू, लैटिन लिपि में उर्दू (रोमानी), अंग्रेज़ी, और मिश्रित उर्दू-अंग्रेज़ी पाठ, जहाँ भाषाएँ एक ही संदेश के भीतर बदलती हैं।
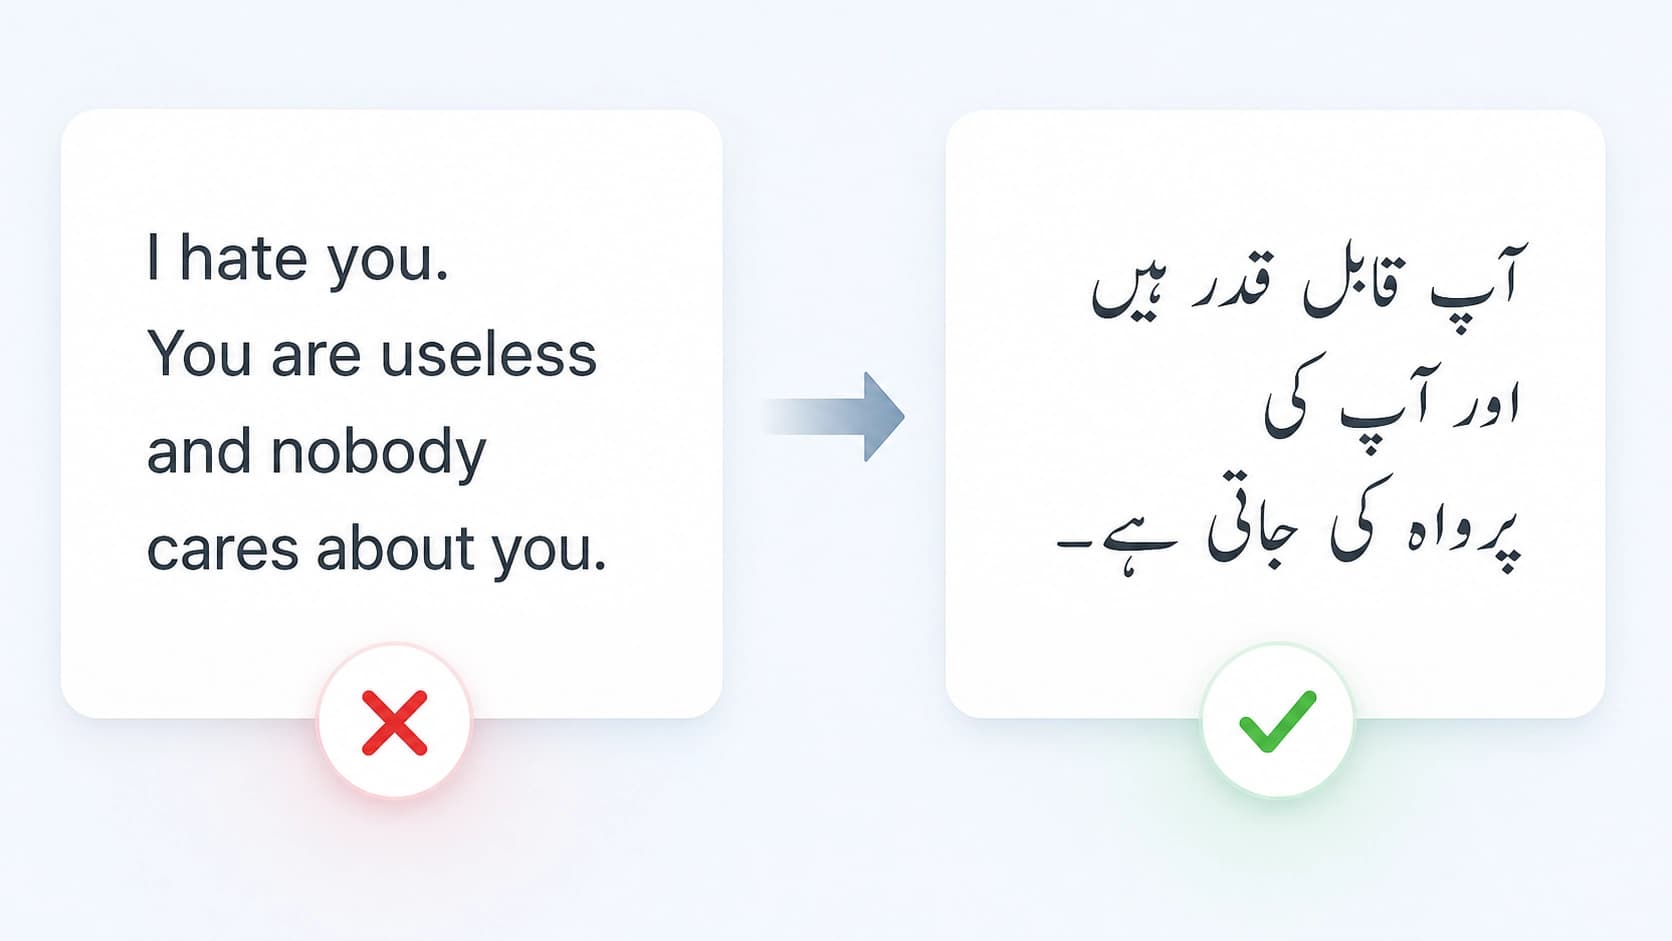
एक ज़रूरी बात: जाँचा गया था गुणवत्ता नहीं, बल्कि निर्णय की स्थिरता। एक ही अर्थ मॉडल को दो बार दिया गया — मूल लिपि में और अंग्रेज़ी अनुवाद में। अगर फ़िल्टर केवल दूसरे मामले में सक्रिय होता है, तो इसका मतलब है कि सुरक्षा सामग्री से नहीं, बल्कि इससे जुड़ी है कि वह किन अक्षरों में लिखी गई है।
दो मापदंड
लेखक दो सरल संकेतकों का उपयोग करते हैं। पहला — असंगति का अनुपात: मूल और अनुवाद के बीच लेबल कितनी बार बदलता है। दूसरे को «Missed-in-Urdu» नाम मिला: यह वह सामग्री है जिसे अंग्रेज़ी संस्करण में हानिकारक माना गया, लेकिन मूल लिपि में वह हानिरहित के रूप में पार हो गई। असल में, यह एक साफ़ चूक है — ठीक वही, जिसके लिए मॉडरेशन मौजूद है।
आँकड़ों ने क्या दिखाया
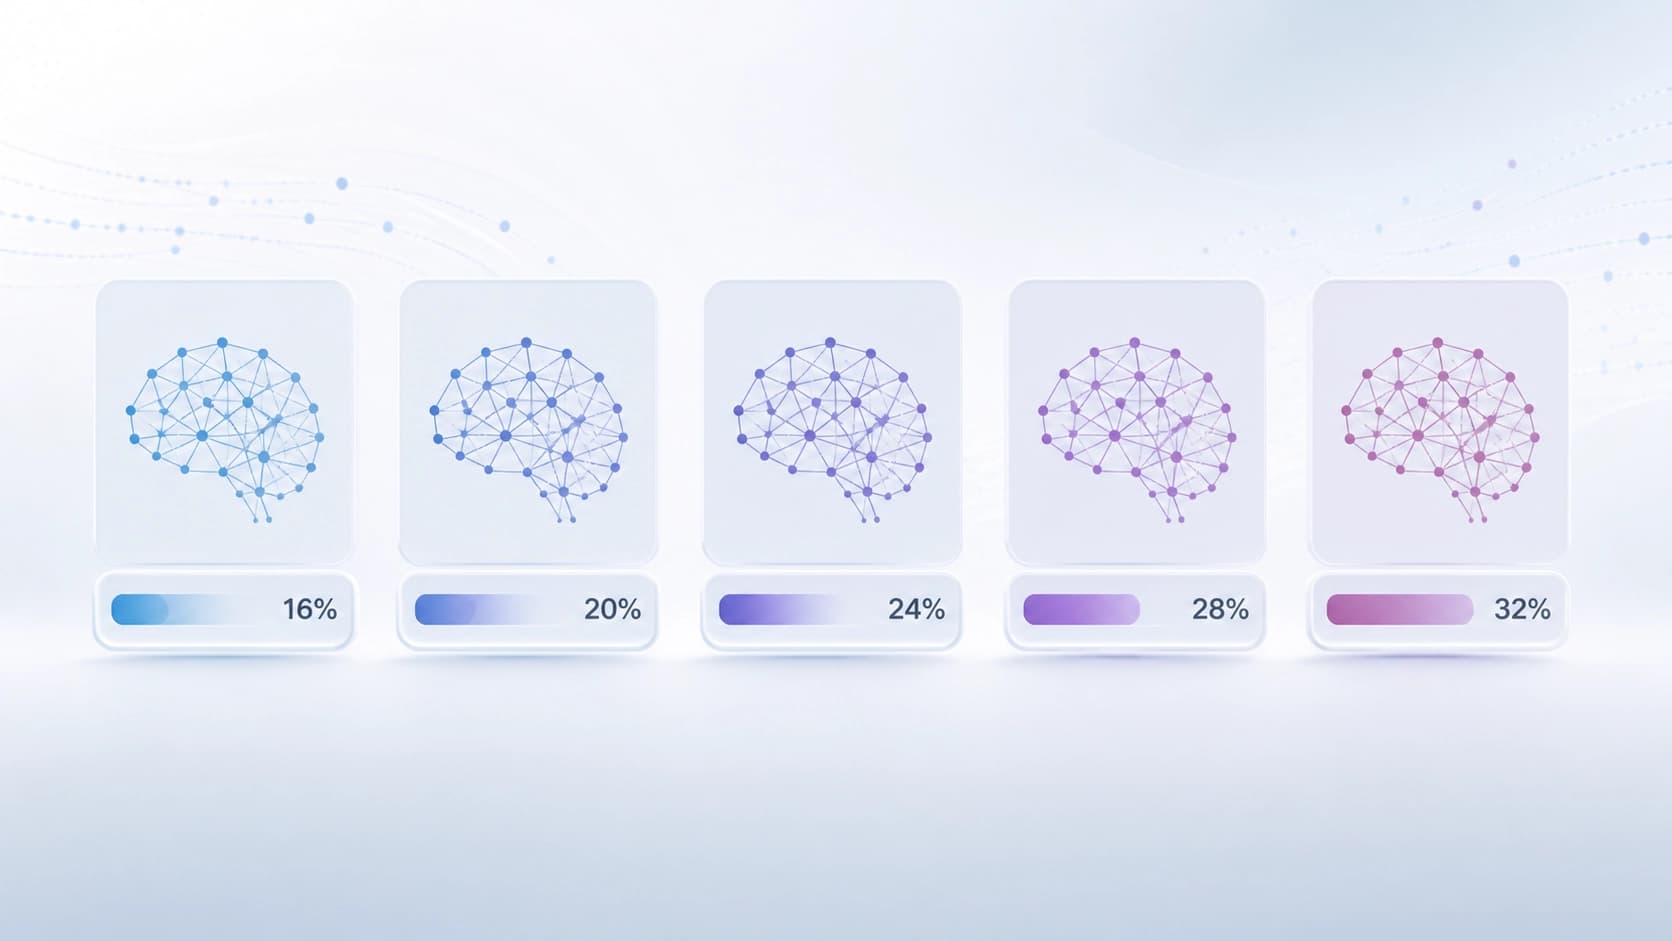
उन पाँच डेटासेटों पर, जहाँ पाठ उर्दू लिपि में ही लिखा गया था, मूल और अनुवाद में वर्गीकरण के परिणामों का अंतर 15.9% से 31.6% तक रहा। सबसे अच्छा परिणाम — Gemini 2.5 Flash का, सबसे खराब — Qwen-2.5 का। दूसरे शब्दों में, सबसे खराब स्थिति में फ़िल्टर का लगभग हर तीसरा निर्णय इस पर निर्भर था कि वही पाठ किस वर्णमाला में दिया गया था।
छूटे हुए नुकसान का अनुपात — 2.4% से 9.9% तक, मध्यिका 4.3%। पहली नज़र में कम लगता है, लेकिन इसे मानवीय पैमाने पर सोचें: अगर लाखों उपयोगकर्ताओं वाला कोई प्लेटफ़ॉर्म रोज़ाना हज़ारों संदेशों को संसाधित करता है, तो 4% भी — सैकड़ों विषाक्त सामग्री इकाइयाँ हैं जो रोज़ाना पार निकल जाती हैं। और बात व्यंग्य जैसे सीमांत मामलों की नहीं है, बल्कि ऐसी सामग्री की है जिसे वही मॉडल अनुवाद करते ही भरोसे के साथ हानिकारक के रूप में चिह्नित कर देता है।
लेखकों द्वारा दर्ज की गई सामान्य प्रवृत्ति: मॉडल जितना छोटा और खुला होगा, दोनों मापदंड उतने ही अधिक गिरेंगे। प्रमुख बंद सिस्टम अधिक स्थिर रहते हैं, लेकिन उनमें भी अंतर शून्य नहीं है।
नौ साल का साहित्य — और एक भी शोध नहीं
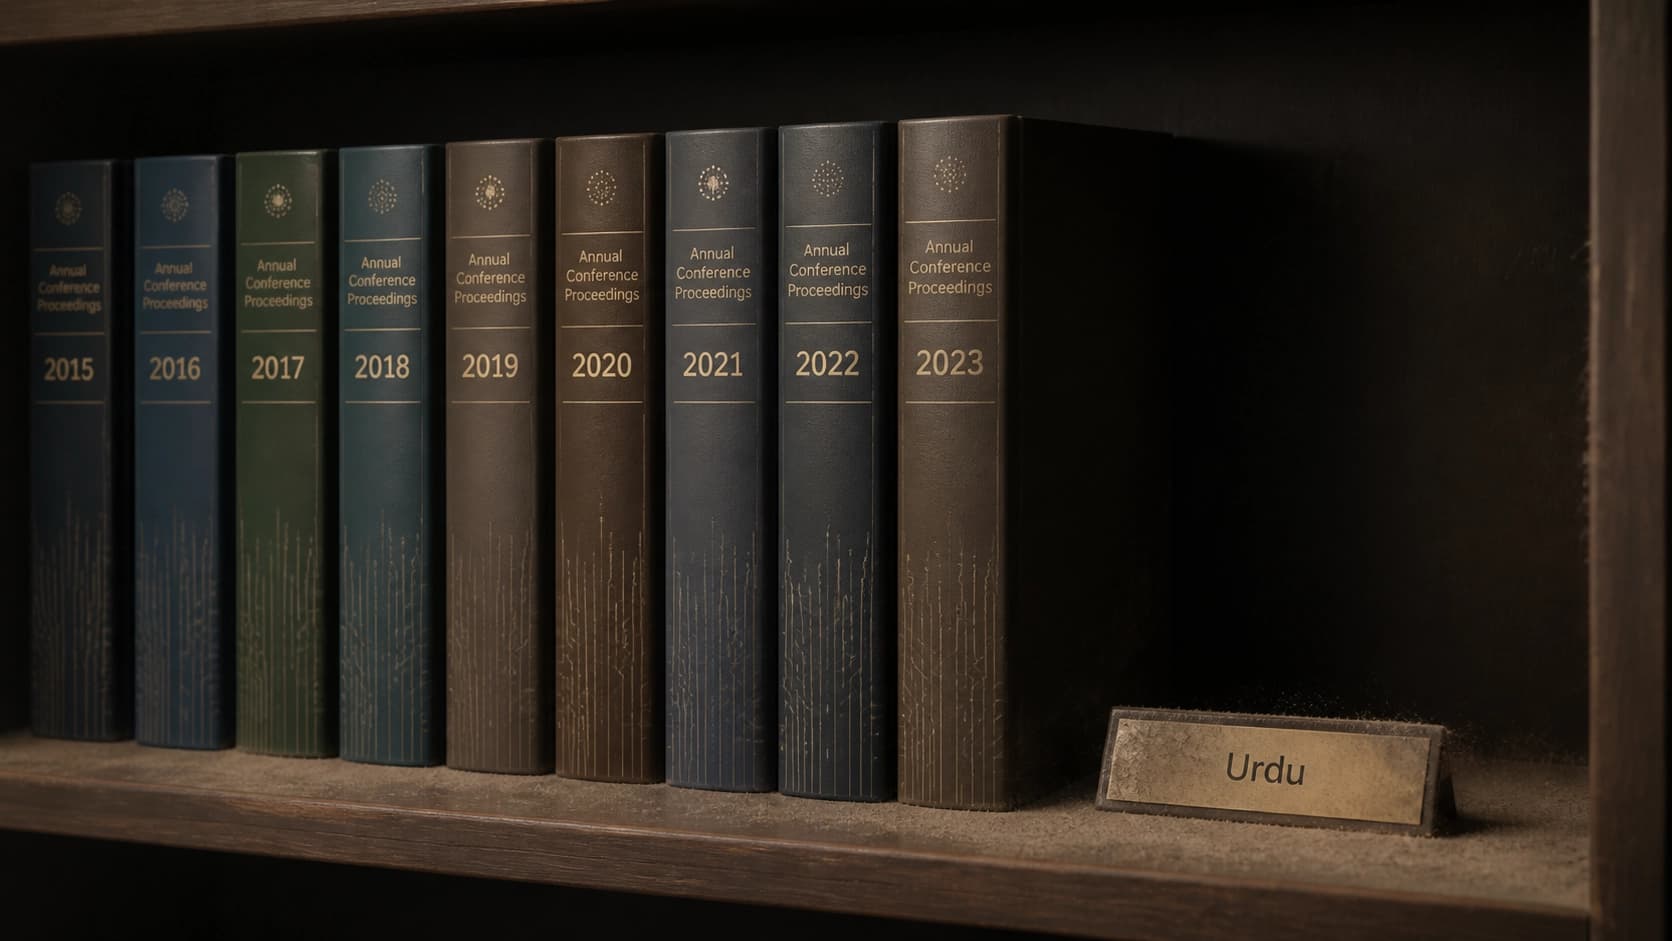
शोध की एक अलग दिशा — ग्रंथसूची संबंधी। लेखकों ने ACL Anthology API के ज़रिए ALW/WOAH के नौ अंकों के सभी 205 लेखों को खंगाला और विशेष रूप से उर्दू पर केंद्रित एक भी नहीं मिला। इसका मतलब यह नहीं कि विषय पर शोध हुआ ही नहीं — लेकिन नुकसान के मूल्यांकन पर मुख्य वर्कशॉप की सामग्री में यह एक अलग दिशा के रूप में मौजूद नहीं है। इस तरह एक बंद चक्र बनता है: बेंचमार्क नहीं — प्रकाशन नहीं — डेवलपर्स पर दबाव नहीं — फिर बेंचमार्क नहीं।
ऐसा क्यों होता है
लेख में सटीक उत्तर नहीं है, लेकिन सामान्य विचारों से तंत्र समझ में आता है। नस्तालीक़ — एक प्रवाही लिपि है, जहाँ अक्षर का रूप शब्द में उसकी स्थिति पर निर्भर करता है, यानी लैटिन के लिए बने टोकनाइज़र ऐसे पाठ को प्रतिकूल टुकड़ों में काट देते हैं। प्रशिक्षण कॉर्पस में उर्दू का डेटा अंग्रेज़ी से कई गुना कम है। रीइन्फ़ोर्समेंट लर्निंग (सुरक्षा सहित) के लिए एनोटेशन भी मुख्य रूप से अंग्रेज़ी के मूल वक्ताओं द्वारा एकत्र किया जाता है। साथ ही एक सुविधाजनक समझौता मौजूद है: इनपुट का अंग्रेज़ी में अनुवाद करो, जाँच चलाओ, उत्तर लौटाओ। यह संसाधन बचाता है, लेकिन एक मध्यस्थ जोड़ देता है, और यही असंगति पैदा करता है।
प्रोडक्ट टीमों को इसके बारे में क्या करना चाहिए
- अनुवाद पर प्रॉक्सी के रूप में भरोसा न करें। अगर फ़िल्टर अंग्रेज़ी संस्करण के आधार पर निर्णय लेता है, तो अंतर को मापा जाना चाहिए, छिपाया नहीं।
- असंगति को एक मीट्रिक बनाएँ। यह नियमित रूप से गिनना उपयोगी है कि लिपि बदलने पर कितने निर्णय बदलते हैं: यह नए एनोटेशन के बिना अंधे क्षेत्रों को खोजने का सस्ता तरीका है।
- मूल लिपि में परीक्षण करें। नस्तालीक़, रोमानी और code-switching — तीन अलग मोड हैं, और एक में अच्छे परिणाम अन्य दो में कुछ भी सुनिश्चित नहीं करते।
- थ्रेशोल्ड को आँख मूँदकर समान न करें। एक लिपि पर संवेदनशीलता बढ़ाना आसानी से दूसरी पर झूठे अलर्ट की बाढ़ बन सकता है।
- दर्शकों को ध्यान में रखें। 246 मिलियन वक्ता — यह किसी संकीर्ण भाषा नहीं, बल्कि किसी भी बड़े प्लेटफ़ॉर्म के उपयोगकर्ताओं का एक उल्लेखनीय हिस्सा है।
जिस निष्कर्ष की ओर लेखक ले जाते हैं, वह सूखा-सा लगता है, पर सार्थक है: आज सुरक्षा की गारंटियाँ लिपियों के बीच असमान रूप से वितरित हैं। जब तक ऐसा है, «मॉडल ने सुरक्षा परीक्षण पास कर लिए» — एक ऐसा कथन है जिसे हमेशा स्पष्ट करना चाहिए: ये परीक्षण किस भाषा में और किन अक्षरों में लिखे गए थे।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
डैशबोर्ड विश्लेषण में GUI एजेंटों का चरणबद्ध निदान: DashAct बेंचमार्क
DashAct प्रस्तुत है—348 मानव-सत्यापित ट्रैजेक्टरी वाला एक बेंचमार्क, जो इंटरैक्टिव डैशबोर्ड के साथ GUI एजेंटों के काम को तीन चरणों और चार दृश्य स्थितियों में विभाजित करता है। नतीजे बताते हैं कि एजेंटों को कार्रवाइयों का अनुमान लगाने और दृश्य लक्ष्यों से जुड़ने में लगातार समस्याएँ आती हैं, साथ ही उनकी प्रतिक्रियाएँ संदर्भ और स्थानिक समर्थन पर निर्भर करती हैं।
11 नवम्बर 2026
WILSON: पैथोमॉर्फोलॉजिकल विश्लेषण और निष्कर्ष तैयार करने के लिए रोगी के आवर्धनों और स्लाइडों का संयोजन
यह प्रीप्रिंट WILSON प्रस्तुत करता है—एक vision-language मॉडल, जो केवल एक अलग “सर्वश्रेष्ठ” स्लाइड के बजाय पूरे स्लाइडों और एक ही मरीज के अलग-अलग आवर्धन पर लिए गए नमूनों की छवियों को एन्कोड करता है। किसी विशिष्ट कार्य के लिए अतिरिक्त प्रशिक्षण के बिना, यह कई मेट्रिक्स पर विशेषीकृत और अधिक बड़े स्लाइड-मॉडलों से बेहतर प्रदर्शन करता है, वह भी काफ़ी कम कंप्यूटेशनल लागत पर; इसके नैदानिक विवरणों को पैथोलॉजिस्टों से अधिक ऊँची रेटिंग मिली।
11 नवम्बर 2026
RL सिम्युलेटरों की विफलताओं के निदान में कैनोनिकल बहुपद अपरिवर्तांक: वे वास्तव में कहाँ उपयोगी हैं
यह अध्ययन जाँचता है कि क्या सीखने योग्य गतिशीलता मॉडल में भौतिक नियमों को शामिल करना उचित है: प्रक्षेप पथों से निकाले गए और ग्रोबनर आधारों के माध्यम से विहित रूप में लाए गए अपरिवर्तक पूर्वानुमानों में मामूली सुधार देते हैं, लेकिन निदान में प्रभावी साबित होते हैं—वे उल्लंघित बाधा का स्थान निर्धारित करने और विशिष्ट गलत पैरामीटर की पहचान करने में सक्षम बनाते हैं।
10 नवम्बर 2026