
जहाँ LLM-न्यायाधीश गलती करता है: वॉइस एजेंट्स के स्वचालित मूल्यांकन की विश्वसनीयता की जाँच
arXiv प्रीप्रिंट के लेखकों ने तुलना की कि कैसे मानव मूल्यांकनकर्ता और GPT-4.1 तथा GPT-5 मॉडल टेलीकॉम और रिटेल में वॉइस एजेंट की एक ही बातचीत को तीन मूल्यांकन योजनाओं में 10 प्रभावशीलता और सुरक्षा मेट्रिक्स के आधार पर आंकते हैं। निष्कर्ष: ऑटोमेशन हर जगह उपयुक्त नहीं है, और कुछ संकेतक (जैसे Recovery Turn Count और safety-recall) को अभी मानव निगरानी के बिना मशीन को नहीं सौंपा जा सकता।
वॉइस एजेंट्स के मूल्यांकन को स्वचालित करना इतना कठिन क्यों है
संवादात्मक वॉइस एजेंट एक ही मॉडल नहीं, बल्कि एक पाइपलाइन है: वाक् पहचान, तर्क, टूल कॉल, प्रतिक्रिया निर्माण, संश्लेषण और ऑडियो स्ट्रीमिंग। किसी भी चरण में विफलता स्थानीय नहीं रहती — वह श्रृंखला में आगे बढ़ती है और संवाद में ही सामने आती है। इसीलिए बातचीत की गुणवत्ता का आकलन केवल संपूर्ण रूप से, end-to-end करना उचित है, अलग-अलग कड़ियों के आधार पर नहीं।
जीवित मूल्यांकनकर्ताओं का स्टाफ रखना महँगा और असुविधाजनक है: आप उन्हें लाखों बातचीतों तक नहीं बढ़ा सकते, और शिफ्ट के अंत तक उनका ध्यान कमजोर पड़ जाता है। स्वाभाविक समाधान है — मूल्यांकन को भाषा मॉडल को सौंप देना। ताज़ा arXiv प्रीप्रिंट arXiv:2608.24314 (Anupam Purwar, Shashank Singh, Kritika Srivastava) ठीक यही जाँचता है कि ऐसा समाधान कितना उचित है और कहाँ टूटता है।
लेखकों ने LLM न्यायाधीशों की परीक्षा कैसे की
प्रयोग दो उद्योगों — टेलीकॉम और रिटेल — के वॉइस एजेंट्स की वास्तविक बातचीतों पर आधारित है। मानवीय मूल्यांकनों की तुलना GPT-4.1 और GPT-5 के निर्णयों से की गई, और वह भी किसी एक सामान्य पैमाने पर नहीं, बल्कि दस मीट्रिक्स पर: कुछ बातचीत की गुणवत्ता का वर्णन करती हैं, कुछ सुरक्षा का।
एक के बजाय तीन कॉन्फ़िगरेशन
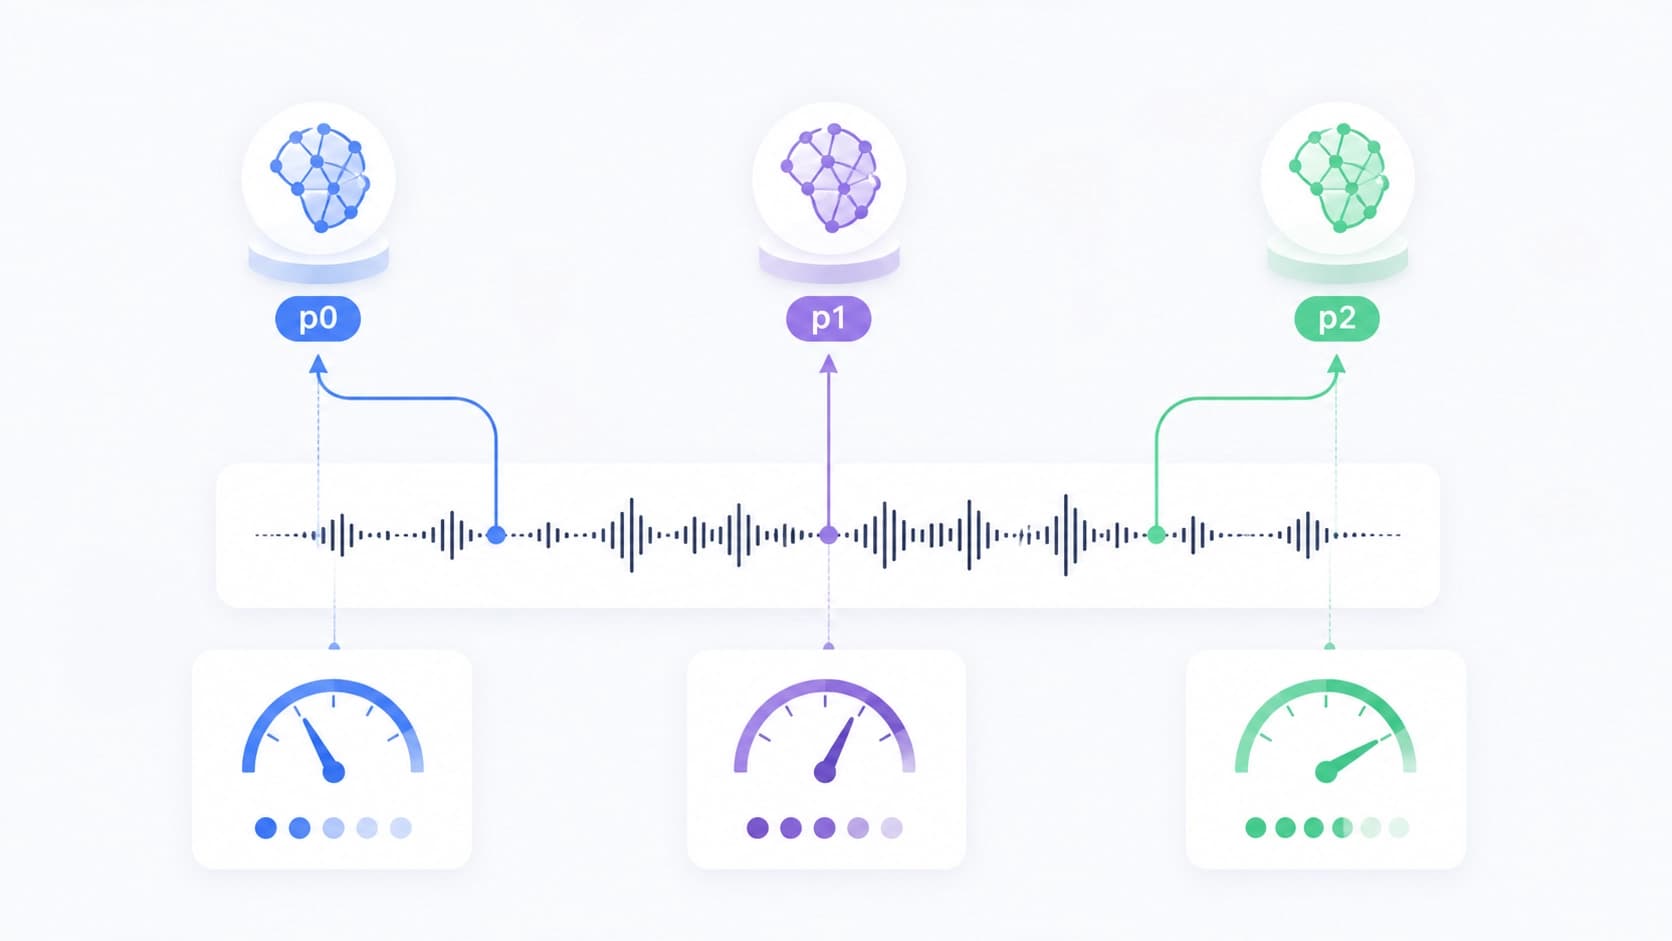
वही संवाद तीन मूल्यांकन योजनाओं — p0, p1 और p2 — से गुज़ारे गए। अभ्यास का अर्थ सरल है: यदि निर्णय इस बात से बदलता है कि रूब्रिक कैसे बनाया गया है, तो न्यायाधीश बातचीत की गुणवत्ता नहीं, बल्कि निर्देश का रूप माप रहा है। कोई भी मीट्रिक जो कॉन्फ़िगरेशनों के बीच "बहती" है, स्वचालन के लिए उपयुक्त नहीं है — कम से कम बिना शर्तों के।
वास्तव में किसकी तुलना की गई
समग्र सहमति — मनुष्य और मॉडल के बीच मेल का प्रतिशत — केवल ऊपरी परत है। लेखक गहराई में जाते हैं: प्रत्येक मीट्रिक पर अलग-अलग सहसंबंध देखते हैं, जाँचते हैं कि मनुष्यों के समूह के भीतर मूल्यांकन कितने स्थिर हैं, और मनुष्य तथा LLM के बीच व्यवस्थित अंतरों का विश्लेषण करते हैं। ऐसा विभाजन यह समझने देता है कि बातचीत के कौन-से गुण स्वचालित मूल्यांकन के योग्य हैं और कौन-से संदर्भ और व्याख्या पर अटक जाते हैं।
LLM न्यायाधीश कहाँ गलती करता है
मुख्य निष्कर्ष विधि के प्रचार की तरह नहीं, बल्कि चेतावनी की तरह लगता है: स्वचालित मूल्यांकन की विश्वसनीयता एक समान नहीं है — यह विशिष्ट मीट्रिक और कॉन्फ़िगरेशन पर निर्भर करती है। वही न्यायाधीश मॉडल कुछ पैमानों पर मजबूत परिणाम देते हैं और अन्य पर स्पष्ट रूप से कमजोर पड़ जाते हैं।
Recovery Turn Count
यह मीट्रिक गिनती है कि एजेंट को बातचीत को विफलता से बाहर निकालने में कितने चरण लगे। यहाँ स्वचालित मूल्यांकन अविश्वसनीय है: न्यायाधीश हमेशा सार्थक पुनर्प्राप्ति और संयोगवश सफल शब्दावली में अंतर नहीं कर पाता। जिस संवाद को मनुष्य बचा हुआ कहेगा, मॉडल उसे आसानी से विफल घोषित कर सकता है — और इसके विपरीत।
पूर्णता पर सुरक्षा मीट्रिक्स
Safety-recall — दूसरा समस्याग्रस्त क्षेत्र। त्रुटि का तर्क पूर्वानुमेय है: न्यायाधीश ऐसा संवाद देखता है जहाँ एजेंट ने कुछ भी खतरनाक नहीं कहा, और उच्च अंक दे देता है, बिना यह सवाल किए कि नीति का उल्लंघन करने का अवसर था भी या नहीं। छूटा हुआ उल्लंघन सबसे महँगी प्रकार की त्रुटि है, और ठीक वहीं स्वचालन सबसे कमजोर है।
डोमेन अंशांकन बदल देता है
न्यायाधीशों की विश्वसनीयता टेलीकॉम और रिटेल के बीच भिन्न होती है। व्यावहारिक निष्कर्ष: थ्रेसहोल्ड और रूब्रिक्स को एक उद्योग से दूसरे में यांत्रिक रूप से स्थानांतरित नहीं किया जा सकता — जो एक डोमेन पर अंशांकित है, वह दूसरे पर बिगड़ जाएगा।
अंशांकन मेल के प्रतिशत से अधिक महत्वपूर्ण है
सहमति का एकल आंकड़ा सतर्कता को शिथिल कर देता है। मॉडल बड़ी संख्याओं में औसतन मनुष्यों से मेल खा सकता है, लेकिन सीमावर्ती मामलों पर व्यवस्थित रूप से अधिक उदार हो सकता है — और यह पूर्वाग्रह समग्र प्रतिशत के पीछे छिप जाता है। इसलिए अंशांकन का सहसंबंध विश्लेषण और प्रत्येक प्रकार के मामलों में अंतरों का विश्लेषण एक सारांश मीट्रिक से अधिक उपयोगी है: यह नहीं दिखाता कि "हम कितने करीब हैं", बल्कि यह कि "हम किस दिशा में और किस पर गलत हैं"।
इसे वास्तविक पाइपलाइन में कैसे शामिल करें
लेखक स्वचालन को छोड़ने का सुझाव नहीं देते — वे एक हाइब्रिड योजना प्रस्तावित करते हैं। LLM न्यायाधीश थोक मूल्यांकन अपने हाथ में लेता है, मनुष्य वहाँ रहते हैं जहाँ संदर्भ और निर्णय में उच्च विश्वास की आवश्यकता होती है। व्यावहारिक नियम इस प्रकार हैं:
- रूब्रिक को कम से कम दो-तीन कॉन्फ़िगरेशनों में चलाएँ और परिणामों की तुलना करें, केवल अंतिम अंक की नहीं;
- सहमति प्रत्येक मीट्रिक पर अलग-अलग गिनें, पूरे डेटासेट के लिए एक संख्या के रूप में नहीं;
- safety-recall और विफलता के बाद पुनर्प्राप्ति की मीट्रिक्स पर मनुष्य को बनाए रखें;
- स्वचालित थ्रेसहोल्ड निर्धारित करने से पहले अपने डोमेन पर अंशांकन जाँचें;
- मनुष्य/मॉडल के अंतर के मामलों को सहेजें — ये रूब्रिक के पुनर्प्रशिक्षण के लिए तैयार सामग्री हैं।
संक्षेप में क्या निकलता है
LLM न्यायाधीश वॉइस एजेंट्स के बड़े पैमाने पर मूल्यांकन का एक कार्यशील उपकरण है, लेकिन मूल्यांकनकर्ता का प्रतिस्थापन नहीं। इसकी विश्वसनीयता असमान रूप से वितरित है: कुछ मीट्रिक्स को निश्चिंत होकर स्वचालन को सौंपा जा सकता है, कुछ के लिए मानवीय दृष्टि आवश्यक है। शोध की उपयोगिता इस बात में है कि यह ऐसे श्रम विभाजन के लिए एक अनुभवजन्य रूपरेखा देता है — और यह याद दिलाता है कि "क्या मॉडल के मूल्यांकन पर भरोसा करें" प्रश्न गलत है, जब तक यह स्पष्ट न हो कि किस मीट्रिक पर और किस डोमेन में।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
Toollery: बिना फ़ाइन-ट्यूनिंग के, दसियों हज़ार विकल्पों में से LLM एजेंटों के लिए टूल चुनना
Toollery कौशलों और टूल्स के विवरणों पर एक खोज इंडेक्स बनाता है और अनुरोध आने पर मॉडल को केवल सीमित उम्मीदवारों का सेट भेजता है। दसियों हज़ार फ़ंक्शनों तक के आकार वाली लाइब्रेरी पर किए गए प्रयोगों में, यह तरीका निश्चित top-K पर चयन की गुणवत्ता बनाए रखने में सक्षम है, हालांकि अंतिम प्रभाव लोड प्रोफ़ाइल और प्रदाता की कैशिंग पर निर्भर करता है।
11 नवम्बर 2026
डैशबोर्ड विश्लेषण में GUI एजेंटों का चरणबद्ध निदान: DashAct बेंचमार्क
DashAct प्रस्तुत है—348 मानव-सत्यापित ट्रैजेक्टरी वाला एक बेंचमार्क, जो इंटरैक्टिव डैशबोर्ड के साथ GUI एजेंटों के काम को तीन चरणों और चार दृश्य स्थितियों में विभाजित करता है। नतीजे बताते हैं कि एजेंटों को कार्रवाइयों का अनुमान लगाने और दृश्य लक्ष्यों से जुड़ने में लगातार समस्याएँ आती हैं, साथ ही उनकी प्रतिक्रियाएँ संदर्भ और स्थानिक समर्थन पर निर्भर करती हैं।
11 नवम्बर 2026
WILSON: पैथोमॉर्फोलॉजिकल विश्लेषण और निष्कर्ष तैयार करने के लिए रोगी के आवर्धनों और स्लाइडों का संयोजन
यह प्रीप्रिंट WILSON प्रस्तुत करता है—एक vision-language मॉडल, जो केवल एक अलग “सर्वश्रेष्ठ” स्लाइड के बजाय पूरे स्लाइडों और एक ही मरीज के अलग-अलग आवर्धन पर लिए गए नमूनों की छवियों को एन्कोड करता है। किसी विशिष्ट कार्य के लिए अतिरिक्त प्रशिक्षण के बिना, यह कई मेट्रिक्स पर विशेषीकृत और अधिक बड़े स्लाइड-मॉडलों से बेहतर प्रदर्शन करता है, वह भी काफ़ी कम कंप्यूटेशनल लागत पर; इसके नैदानिक विवरणों को पैथोलॉजिस्टों से अधिक ऊँची रेटिंग मिली।
11 नवम्बर 2026