
शीर्षक: भाग्य के बजाय ग्राफ़: कैसे GxP-Agent नैदानिक डेटा LLM प्रोग्रामिंग को विश्वसनीय बनाता है
यह प्रीप्रिंट पाँच अत्याधुनिक LLM की विफलता का विश्लेषण करता है, जो नियामक प्रस्तुति के लिए मान्य विश्लेषणात्मक डेटासेट तैयार करने में असमर्थ रहे, जबकि 15 विशेषीकृत नोड्स वाली निर्देशित अचक्रीय ग्राफ-आधारित मल्टी-एजेंट प्रणाली संदर्भ के साथ 100% संरचनात्मक मिलान दिखाती है। यह दृष्टिकोण मोनोलिथिक कोड निर्माण को सत्यापन योग्य डोमेन-विशिष्ट चरणों के अनुक्रम में बदल देता है।
नैदानिक प्रोग्रामिंग: जहां LLM stumble
नियामक प्रस्तुतीकरण के लिए नैदानिक परीक्षण डेटा तैयार करना सख्त आवश्यकताओं के साथ एक प्रक्रिया है। प्रोटोकॉल को विश्लेषणात्मक डेटासेट में बदलने की आवश्यकता होती है जो सीडीआईएससी मानकों का पालन करती है, और यहां कोई गलती एप्लिकेशन की देरी या अस्वीकृति का खर्च कर सकती है। लंबे समय तक, यह चरण एक बाधा बना रहा: इसके लिए डोमेन ज्ञान, कोड में परिशुद्धता और नियामक तर्क की समझ दोनों की आवश्यकता होती है।
जब यह बड़े भाषा मॉडल के साथ इस तरह के कोड को उत्पन्न करने की बात आती है, तो चित्र bleak दिखता है। ArXiv पर एक प्रीप्रिंट में वर्णित एक प्रयोग में, पांच फ्रंटियर मॉडल को वैध विषय-स्तर डेटासेट बनाने के लिए ग्यारह एकल-shot प्रयास दिए गए थे - और कोई सफल नहीं हुआ। यह मामूली खामियों के बारे में नहीं है, लेकिन परिणाम की पूर्ण अक्षमता के बारे में। मॉडल प्रक्रिया की बहुत संरचना को नजरअंदाज करने लगते हैं: वे एक बार में पूरी पाइपलाइन को इकट्ठा करने की कोशिश करते हैं, बिना मध्यवर्ती जांच के या उन चरणों की समझ अनिवार्य है और जो पिछले लोगों पर निर्भर हैं।
GxP-Agent: एक प्रक्रिया ग्राफ के माध्यम से अपघटन
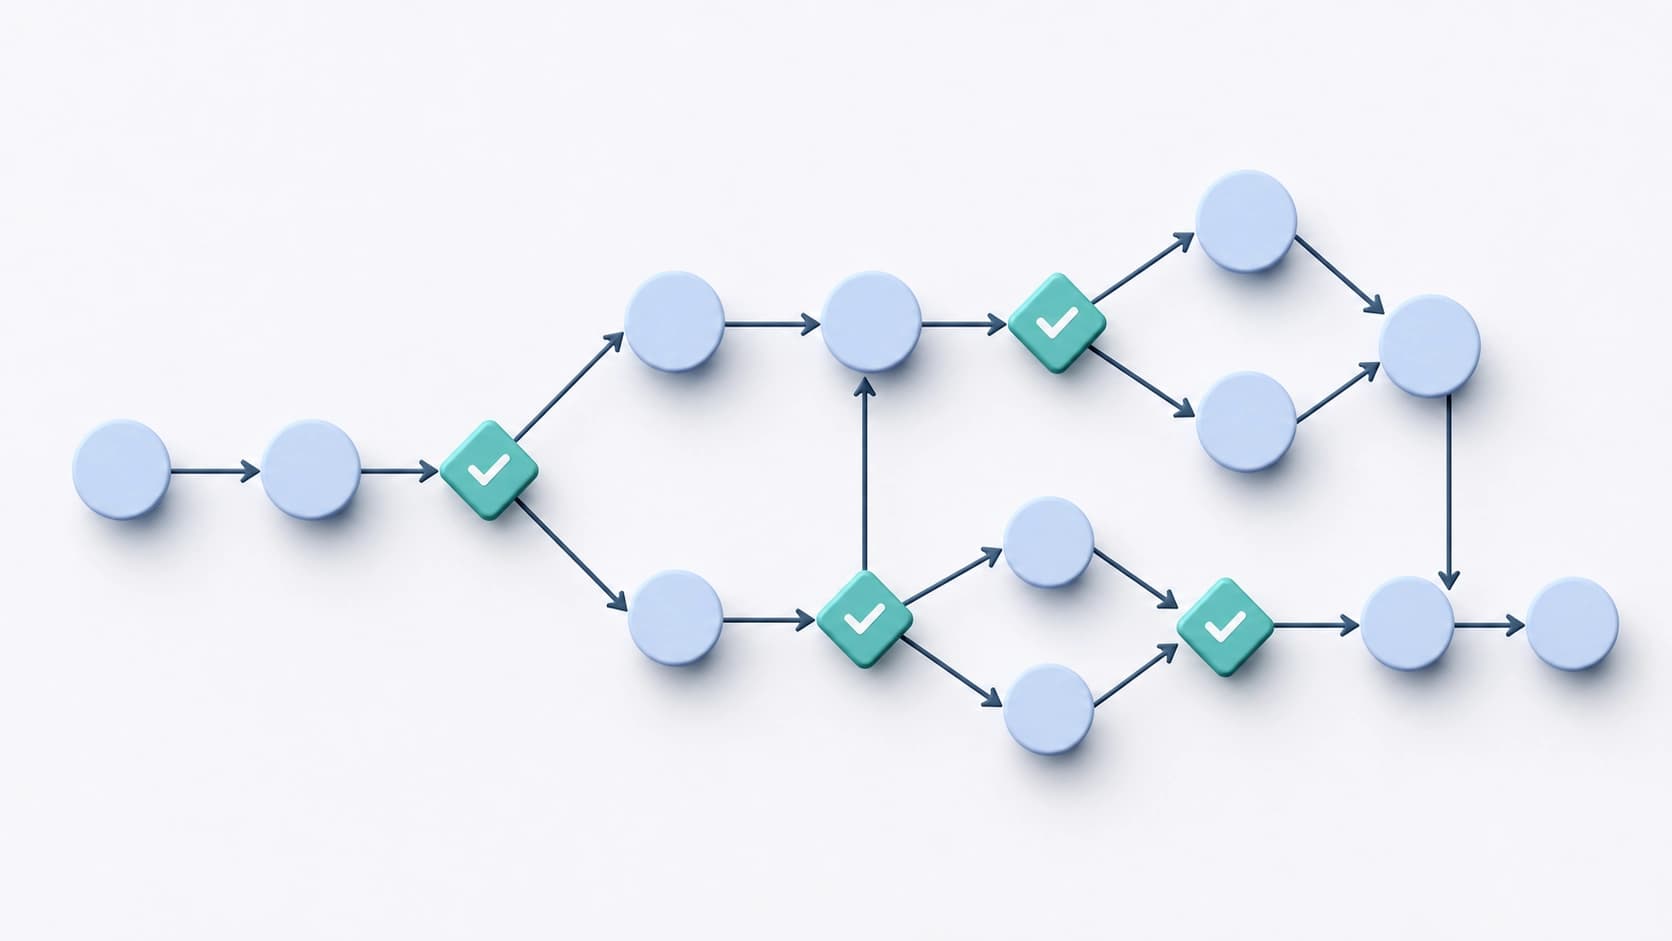
इस समस्या का उत्तर बहु एजेंट प्रणाली GxP-Agent था। इसका मुख्य विचार यह नहीं है कि कैसे नियामक प्रक्रिया काम करती है, इसके बारे में मॉडल के "अनुभव" पर भरोसा करना है, लेकिन इसके बारे में इसका मुख्य विचार यह नहीं है कि कैसे नियामक प्रक्रिया काम करती है, लेकिन इसके बारे में मॉडल के "अनुभव" पर भरोसा करना है। उस प्रक्रिया को स्पष्ट रूप से एन्कोड करने के लिए। क्रियाओं का विनियामक अनुक्रम एक निर्देशित acyclic ग्राफ (DAG) के रूप में दर्शाया गया है। एक कदम में पूरे डेटासेट की एकांत पीढ़ी के बजाय, यह कार्य 15 डोमेन-विशिष्ट नोड्स में टूट गया है। प्रत्येक नोड एक अलग ऑपरेशन है जो एक कार्यकर्ता एजेंट द्वारा किया जाता है जो फार्मावर्स से एक कौशल संदर्भ से सुसज्जित है। नोड्स के बीच, सत्यापन गेट्स हैं, और आवश्यक होने पर सशर्त रिट्री प्रदान की जाती हैं।
यह दृष्टिकोण त्रुटियों की प्रकृति को बदल देता है। यदि मॉडल कुछ नोड पर अपेक्षित परिणाम से विचलित हो जाता है, तो यह तुरंत पता लगाया जाता है, और पूरे पाइपलाइन को फिर से शुरू करने के बजाय कदम को फिर से शुरू किया जा सकता है। संक्षेप में, LLM एक बार में सब कुछ का एक "generator" होना बंद कर देता है और स्थानीय, अच्छी तरह से निर्धारित subtasks का एक निष्पादक बन जाता है। ग्राफ़ टोपोलॉजी एक कठोर ढांचा प्रदान करती है जिसके भीतर मॉडल स्वतंत्र रूप से कार्य कर सकता है।
क्या यह व्यवहार में कैसा दिखता है
प्रत्येक DAG नोड एक विशिष्ट डेटा डोमेन के लिए जिम्मेदार है, और कार्यकर्ता को "ADSL का निर्माण" जैसे अमूर्त कार्य नहीं मिलता है, लेकिन स्पष्ट इनपुट, आउटपुट और सत्यापन मानदंडों के साथ एक संकीर्ण कार्य प्राप्त होता है। यदि परिणाम सत्यापन में विफल हो जाता है, तो एक सशर्त रिट्री सक्रिय होती है - एजेंट को प्रतिक्रिया प्राप्त होती है और कोड को सही करती है। यह एक "generate — चेक — फिक्स" पाश जैसा दिखता है, लेकिन मनमाने ढंग से निष्पादित की बजाय ग्राफ़ संरचना में एम्बेडेड।
CDISC-Bench पर संख्या: शून्य से एक सौ तक
दृष्टिकोण की प्रभावशीलता का मूल्यांकन करने के लिए, लेखकों ने सीडीआईएससी-बेंच नामक एक निष्पादन आधारित बेंचमार्क विकसित किया। यह वास्तविक एफडीए पायलट प्रस्तुतीकरण पर बनाया गया है - CDISCPilot01, जिसमें 254 विषय और 49 ग्राउंड-ट्रिथ ADSL चर शामिल हैं। ऐसा बेंचमार्क कोड के केवल वाक्यविन्यास या अर्थसूचक नहीं बल्कि इसके निष्पादन के वास्तविक परिणाम की जाँच करता है।
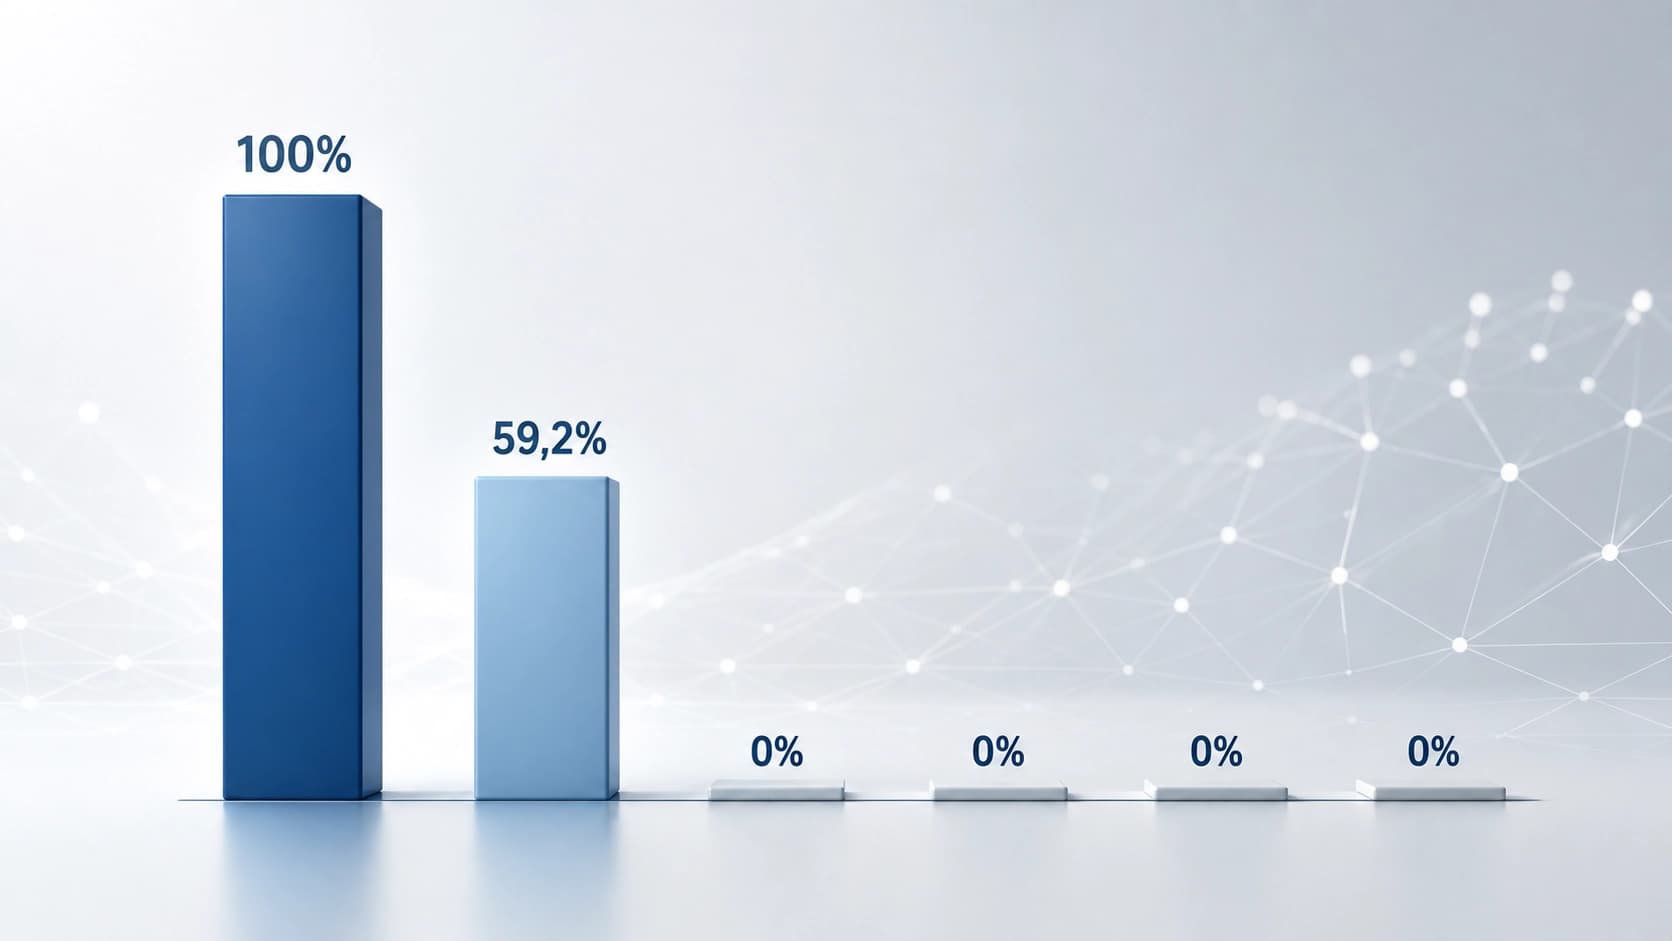
यहां, GxP-Agent ने प्रभावशाली परिणाम दिखाए: क्लाउड सोनेट 4.6 मॉडल के साथ, इसने 100% संरचनात्मक मैच हासिल किया - सभी 49 चर और सभी 254 रिकॉर्ड तीन स्वतंत्र रनों में सही थे। तुलना के लिए, सबसे अच्छा पुनर्प्राप्ति-वर्धित बेसलाइन 59.2% पर बंद कर दिया, और अन्य सभी दृष्टिकोण — एकल एजेंट और फ्लैट बहु एजेंट — शून्य प्रतिशत अंकित। दूसरे शब्दों में, ग्राफ़ टोपोलॉजी के बिना किसी भी वास्तुकला को बस संभालने में असमर्थ है कार्य
वेकर मॉडल भी लाभ
एक दिलचस्प साइड इफेक्ट: DAG टोपोलॉजी मॉडल के लिए भी आवश्यकताओं को कम करती है। जब GPT-4.1 एक ही ग्राफ पर एक कार्यकर्ता के रूप में इस्तेमाल किया गया था, तो औसत संरचनात्मक मैच 59.2% था - एक मजबूत मॉडल पर पुनर्प्राप्ति-वर्धित बेसलाइन के समान स्तर। ग्राफ़ संरचना के बिना, GPT-4.1 ने शून्य परिणाम दिखाया। यह पुष्टि करता है कि निर्णायक भूमिका एक व्यक्तिगत मॉडल की शक्ति से नहीं बल्कि प्रक्रिया कैसे आयोजित की जाती है।
दृष्टिकोण और निष्कर्ष की बहुमुखी प्रतिभा
लेखक ने खुद को एक ही डोमेन पर सीमित नहीं किया। उसी सिद्धांत को ADAE डेटासेट (adverse event) पर लागू किया गया था - जो 9 नोड्स, 55 वेरिएबल्स और 1191 रिकॉर्ड्स की एक शाखा DAG का उपयोग करता है। पहले प्रयास में 100% संरचनात्मक मैच हासिल किया गया था। यह सुझाव देता है कि विधि ADSL से परे सामान्यीकृत है और अन्य प्रकार के नैदानिक डेटा के लिए उपयुक्त है।
काम का मुख्य टेकअवे: नैदानिक प्रोग्रामिंग में विश्वसनीयता LLM के "स्मार्ट तर्क" के माध्यम से प्राप्त नहीं की जाती है, लेकिन ग्राफ़ टोपोलॉजी के रूप में प्रक्रिया के बारे में डोमेन ज्ञान को एन्कोडिंग के माध्यम से प्राप्त की जाती है। मॉडल एक महत्वपूर्ण रहता है, लेकिन सिस्टम का एकमात्र घटक नहीं। यह वह ग्राफ है जो बाधाओं और आदेश सेट करता है, जबकि भाषा मॉडल इसे कंक्रीट कोड से भर देता है। यह सहजीवन GxP-compliant परिणाम प्राप्त करने के लिए संभव बनाता है जिसे नियामक प्रस्तुतियों में भरोसा किया जा सकता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
RL सिम्युलेटरों की विफलताओं के निदान में कैनोनिकल बहुपद अपरिवर्तांक: वे वास्तव में कहाँ उपयोगी हैं
यह अध्ययन जाँचता है कि क्या सीखने योग्य गतिशीलता मॉडल में भौतिक नियमों को शामिल करना उचित है: प्रक्षेप पथों से निकाले गए और ग्रोबनर आधारों के माध्यम से विहित रूप में लाए गए अपरिवर्तक पूर्वानुमानों में मामूली सुधार देते हैं, लेकिन निदान में प्रभावी साबित होते हैं—वे उल्लंघित बाधा का स्थान निर्धारित करने और विशिष्ट गलत पैरामीटर की पहचान करने में सक्षम बनाते हैं।
10 नवम्बर 2026
AURA-Eval: कैसे जाँचें कि LLM एजेंट ने जोखिम को पहचाना और अगला कदम बदल दियाેણ
यह फ्रेमवर्क LLM एजेंटों के व्यवहार का आकलन अंतिम निर्णय के आधार पर नहीं, बल्कि अहम बिंदुओं पर जोखिम के प्रति उनकी प्रतिक्रिया के आधार पर करता है: टूल-कॉल की ट्रैजेक्टरी बीच में रोक दी जाती हैं, जिसके बाद मॉडल को अपना तर्क और कार्रवाई जारी रखनी होती है, जबकि LLM जजों का एक पैनल जोखिम की पहचान, कदम की प्रकृति और उसकी सुरक्षा का विश्लेषण करता है। R-Judge की 157 ट्रैजेक्टरी से संकलित 1249 कार्यों में, 20 मॉडलों में सुरक्षित रास्ता न होने पर असुरक्षित कार्रवाइयाँ बढ़ जाती हैं, और निष्पादन से पहले निगरानी हटाने पर शुरुआत में सुरक्षित रहे 52,3% मामले असुरक्षित हो जाते हैं।
10 नवम्बर 2026
चेर्न–साइमन रिज़र्वॉयर की स्मृति: संयोजकता की स्वायत्त गतिशीलता और घनत्व का परिवहन
यह लेख बताता है कि रिज़र्वॉयर इनपुट संकेतों का इतिहास घनत्व वितरण और ज्यामितीय स्वतंत्रता की डिग्रियों—दोनों में कैसे बनाए रखता है। चार तंत्रों की तुलना से पता चलता है कि धारा एक अलग संयोजकता घटक बनाती है, जो घनत्व की बाद की प्रतिक्रिया को बदलती है, जबकि सभी मापे गए लक्षणों को शामिल करने से पल्स के क्रम को डिकोड करने में थोड़ा सुधार होता है।
10 नवम्बर 2026