सत्यापनीय पुरस्कार और उसका अंध क्षेत्र
सत्यापनीय पुरस्कारों पर आधारित प्रबलन अधिगम (reinforcement learning) भाषा मॉडलों के लिए एक परिचित नुस्खा बन गया है: एक ऐसा कार्य जिसका उत्तर स्पष्ट रूप से सत्यापनीय हो — गणित, कोड, लघु-उत्तर वाले प्रश्न — और एक संकेत "हल हुआ / नहीं हुआ"। यह योजना काम करती है, लेकिन इसमें एक ज्ञात कमज़ोरी है। अंतिम पुरस्कार परिणाम को समग्र रूप से आँकता है, न कि उस तक पहुँचने के मार्ग को। मॉडल को सही निष्कर्ष के लिए अंक मिल सकता है, भले ही वह मनगढ़ंत आधारों पर बना हो, और ठीक उसी तरह सही तर्क के लिए भी अंक खो सकता है यदि अंतिम प्रस्तुति असफल रहे।
यहीं भ्रम (hallucination) का जोखिम बसता है। यदि पुरस्कार केवल अंतिम मिलान पर निर्भर हो, तो नीति के पास रास्ते में सावधान रहने का कोई प्रोत्साहन नहीं होता — उत्तर का अनुमान लगा लेना ही पर्याप्त है। इसे ठीक करने का एक तरीका है प्रक्रिया-स्तर पर तथ्यात्मक नियंत्रण जोड़ना: केवल अंतिम परिणाम की नहीं, बल्कि मध्यवर्ती कथनों की भी जाँच करना।
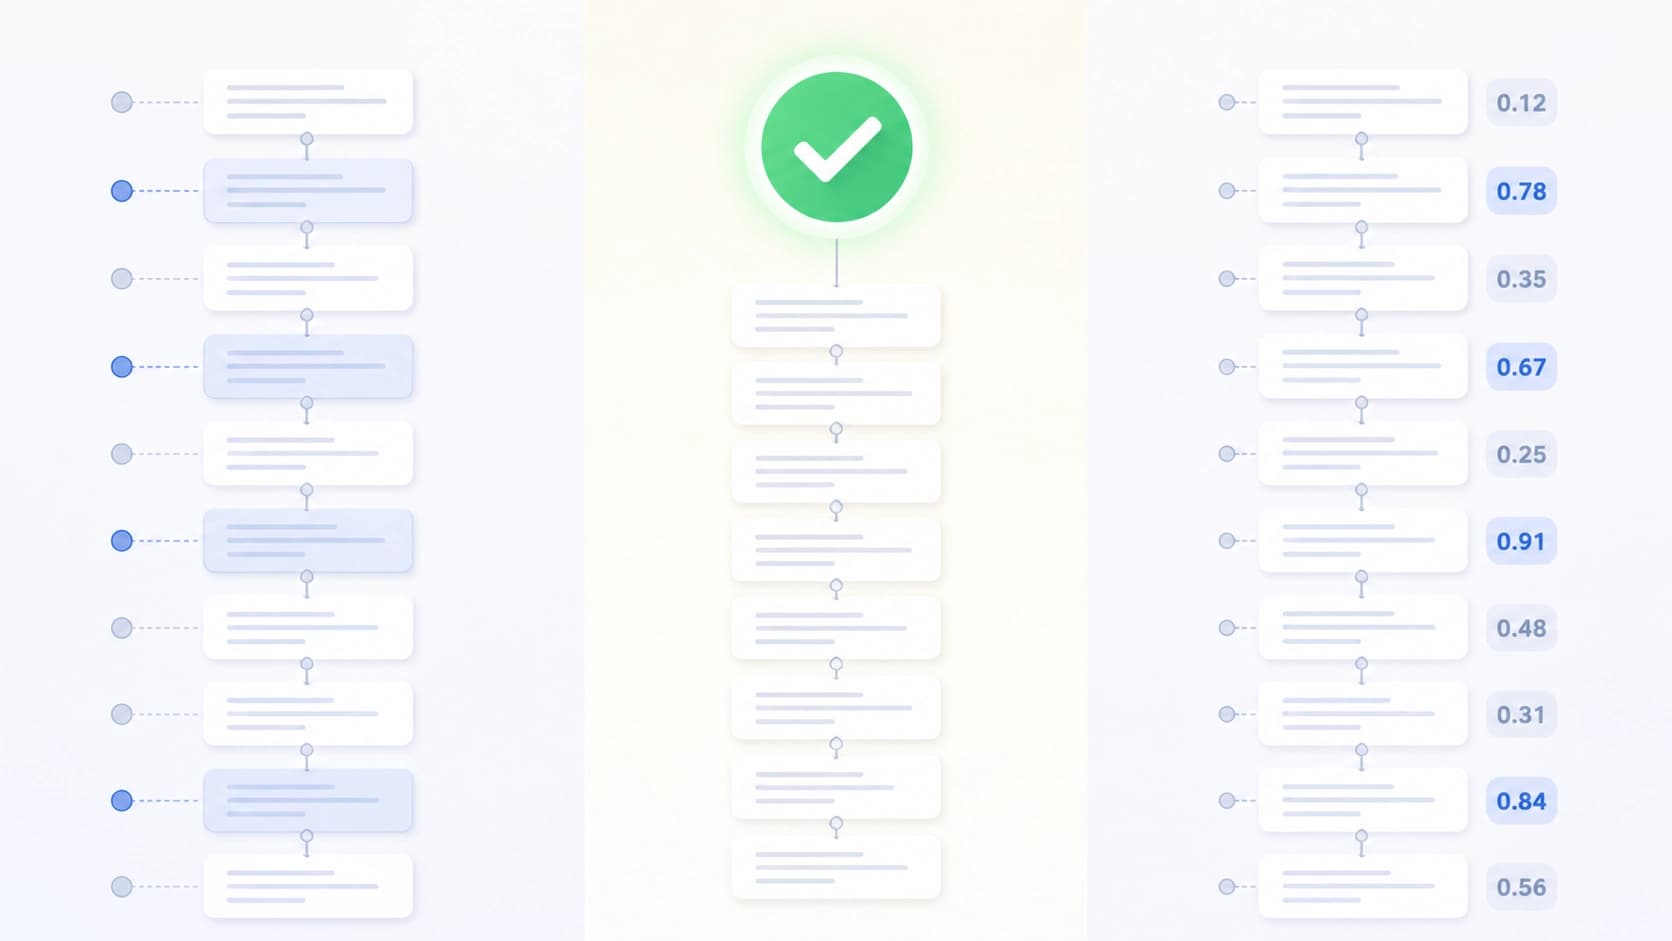
लेकिन process-level दृष्टिकोण में अपनी ही समस्या सामने आती है। तथ्य-जाँचें एकत्र की जाती हैं और मोटे तौर पर औसत की जाती हैं: संकेत पूरे अंश के लिए एक साथ आता है, और जाँचों की विश्वसनीयता का कोई मूल्यांकन नहीं किया जाता। परिणामस्वरूप, जो वास्तव में जाँचा गया और जो वास्तव में नीति में अद्यतन किया गया, उनके बीच एक अंतराल बन जाता है।
एक समस्या के बजाय दो अस्पष्टताएँ
arXiv:2608.24350 (Qiming Xie, Wenjie Zheng, Xiangqing Shen, Rui Xia) के लेखक इस अंतराल को नाम देते हैं — "शोरयुक्त तथ्यात्मक श्रेय निर्धारण" (noisy factual credit assignment) — और इसे दो स्वतंत्र पहलुओं में विभाजित करते हैं।
- श्रेय स्थानीयकरण की अस्पष्टता। यह स्पष्ट नहीं है कि श्रेय या दोष किस विशिष्ट टोकन या अंश को दिया जाए। तथ्य की जाँच वाक्य-स्तर पर की गई, लेकिन अद्यतन टोकन-स्तर पर होता है — ग्रैन्युलैरिटी मेल नहीं खातीं, और संकेत बिखर जाता है।
- श्रेय विश्वसनीयता की अस्पष्टता। यह स्पष्ट नहीं है कि जाँच पर कितना भरोसा किया जा सकता है। कुछ तथ्यात्मक निर्णय विश्वसनीय और पुनरुत्पादनीय होते हैं, अन्य डगमगाते हुए, संदर्भ या विशिष्ट शब्दावली पर निर्भर। विश्वास-भार के बिना वे अधिगम में समान अधिकारों के साथ प्रवेश करते हैं।
दूसरा पहलू सबसे अधिक कम आँका गया है। तथ्यात्मक संकेतों से निपटने की सामान्य योजनाएँ ऐसा व्यवहार करती हैं मानो सभी जाँचें समान गुणवत्ता की हों। व्यवहार में ऐसा नहीं है, और कमज़ोर जाँचें मज़बूत जाँचों के साथ-साथ अनुकूलन को खराब करने लगती हैं।
FARCA कैसे बना है
FARCA का विस्तार है Fact-Aligned Reliability-Aware Credit Assignment — तथ्यों पर आधारित और उनकी विश्वसनीयता को ध्यान में रखते हुए श्रेय निर्धारण। यह कोई नया मॉडल या डेटासेट नहीं है, बल्कि एक नीति-अनुकूलन फ्रेमवर्क है: यह उस तरीके को पुनर्गठित करता है जिसमें तथ्यात्मक नियंत्रण एक प्रशिक्षण संकेत में बदलता है।
ग्रैन्युलैरिटी का मेल बैठाना
पहला कदम है सूक्ष्म-स्तरीय श्रेय स्थानीयकरण। विचार कहने में सरल है और क्रियान्वयन में गैर-तुच्छ: तथ्य-जाँच की ग्रैन्युलैरिटी को नीति-अद्यतनों की ग्रैन्युलैरिटी के अनुरूप लाना होगा। तब तथ्यात्मक संकेत "पूरे उत्तर पर औसत संख्या" के रूप में नहीं आता, बल्कि उन विशिष्ट टोकनों से जुड़ जाता है जो वास्तव में उस कथन के लिए उत्तरदायी हैं। धुँधले औसतन के बजाय नीति को सटीक निर्देश मिलते हैं।
जाँच पर कितना भरोसा किया जा सकता है, इसका मूल्यांकन
दूसरा कदम है विश्वसनीयता-भार। इनकी गणना के लिए लेखक प्रतितथ्यात्मक साक्ष्य श्रेयन (counterfactual evidence attribution) प्रस्तुत करते हैं: वे देखते हैं कि तथ्यात्मक निर्णय किस हद तक मुख्य साक्ष्य-अंश पर निर्भर है। यदि उस साक्ष्य को हटाने या बदलने पर निर्णय बदल जाता है — तो जाँच वास्तव में उसी पर आधारित है, और ऐसा संकेत अधिक विश्वास का पात्र है। यदि साक्ष्य की परवाह किए बिना निर्णय वही रहता है, तो निर्णय संभवतः उस विषय पर नहीं है जो हम सोचते हैं — और उसका भार गिर जाता है।
प्राप्त भार आगे तथ्यात्मक पुरस्कारों और नीति के स्थानीय लाभों को मॉड्यूलेट करते हैं। व्यावहारिक अर्थ: संभावित रूप से अविश्वसनीय संकेतों को अद्यतन में कम वोट मिलता है, न कि उन्हें पूरी तरह अवरुद्ध किया जाता है। यह कठोर छँटाई के बजाय कोमल निस्पंदन है — नीति जानकारी नहीं खोती, लेकिन उसका आँख मूँदकर पालन करना बंद कर देती है।
प्रयोग क्या दिखाते हैं
लेखकों ने इस दृष्टिकोण को विभिन्न मॉडलों और तथ्यात्मक तर्क का मूल्यांकन करने वाले कई बेंचमार्कों पर परखा। घोषित परिणाम — सामान्य तर्क क्षमताओं को बनाए रखते हुए तथ्यात्मकता में उल्लेखनीय वृद्धि। यहाँ अंतिम भाग पहले से कम महत्वपूर्ण नहीं है: तथ्यात्मकता में सुधार अक्सर अन्य कौशलों के ह्रास की कीमत पर खरीदा जाता है, जब मॉडल सतर्क तो हो जाता है पर साथ ही कमज़ोर भी। लेखकों के आँकड़ों के अनुसार, यहाँ ऐसा नहीं होता।
अलग से उल्लेखनीय है कि यह विधि सत्यापनीय पुरस्कारों वाले RL प्रतिमान में ही बनी रहती है — इसे मौजूदा पाइपलाइन को छोड़ने या उसे किसी मूलतः भिन्न चीज़ से बदलने की आवश्यकता नहीं है। यह तथ्य-जाँच और नीति-अद्यतन के बीच एक परत के रूप में जुड़ जाती है।
इससे क्या निकलता है
इस कार्य का मुख्य विचार किसी एक आर्किटेक्चर से व्यापक है। मॉडलों की तथ्यात्मकता पर चर्चा आमतौर पर "जाँचना है या नहीं जाँचना" के तर्क में होती है। लेकिन जब जाँचें पहले से मौजूद हों, तो मुख्य प्रश्न खिसक जाता है: उनका परिणाम कैसे अधिगम में बदलता है। इस जोड़ पर हुई त्रुटि त्रुटि जैसी दिखती नहीं, वह सामान्य प्रशिक्षण शोर जैसी दिखती है — और इसीलिए आसानी से अनदेखी रह जाती है।
यह स्वीकार करना कि सभी स्रोतों पर समान भरोसा नहीं किया जाता, सामान्य बुद्धि के स्तर पर लगभग तुच्छ लगता है। लेकिन प्रबलन अधिगम की योजनाओं में यह अब भी दुर्लभ है: संकेत एक साझा कड़ाह में जमा हो जाते हैं, और विश्वसनीय साक्ष्य तथा आकस्मिक अनुमान के बीच का अंतर मिट जाता है। FARCA इस अंतर को सूत्र में वापस लाने का एक प्रयास है। यह दृष्टिकोण सत्यापनीय उत्तर वाले कार्यों से परे कितना स्थानांतरणीय सिद्ध होगा, जहाँ किसी तथ्य की पुष्टि या खंडन इतनी आसानी से नहीं किया जा सकता — यह एक खुला प्रश्न है, और यही आगे के कार्यों की सबसे दिलचस्प दिशा भी है।