
शुद्ध डेटा KAN वेरिएंट के बीच का अंतर क्यों छिपा देता है
कुशल कोलमोगोरोव–आर्नोल्ड नेटवर्क वेरिएंट पर साहित्य में Chebyshev, वेवलेट और रेडियल-बेसिस संस्करणों सहित मूल KAN को शामिल किया गया है। इन कार्यों में बेंचमार्क शुद्ध डेटा पर बनाए गए हैं। ऐसा चयन आर्किटेक्चर की क्षमताओं में बड़े अंतर को छिपा देता है।
arXiv:2608.14773 कार्य इस अंतर को सामने लाता है। पहला संस्करण 14 अगस्त 2026 को आया, दूसरा — 25 अगस्त 2026 को। आयतन — 22 पृष्ठ, 20 चित्र और 8 तालिकाएँ। विषय — मशीन लर्निंग और कृत्रिम बुद्धिमत्ता।
व्यावहारिक मानदंड: KAN वेरिएंट की तुलना केवल शुद्ध डेटा पर चयन का आधार नहीं देती। मूल्यांकन के लिए शोरयुक्त डेटा वाला प्रोटोकॉल चाहिए।
शोर पर त्रुटि कितनी बढ़ती है
मीट्रिक — टेस्ट MSE, जिसे शुद्ध संदर्भ फलन के विरुद्ध मापा जाता है। प्रशिक्षण sigma = 0,1 वाले शोर से खराब किए गए डेटा पर होता है। वृद्धि संकेतक बताता है कि शुद्ध स्थिति की तुलना में त्रुटि कितने गुना बढ़ी।
| आर्किटेक्चर वेरिएंट | sigma = 0,1 पर टेस्ट MSE की वृद्धि |
|---|---|
| ChebyKAN | 10,6x |
| मूल KAN | 7,9x |
| मानक MLP | 1,7x |
| ER-KAN | 1,4x |
निष्कर्ष: ER-KAN परीक्षण किए गए वेरिएंट में त्रुटि की सबसे कम वृद्धि देता है। मानक MLP भी ChebyKAN और मूल KAN की तुलना में काफ़ी बेहतर टिकता है।
तीन समाधान जो ER-KAN को स्थिरता देते हैं
ER-KAN तीन तकनीकों से बना है, जो डेटा की कमी के साथ शोरयुक्त मोड पर लक्षित हैं।
- परत के सभी किनारों पर साझा गाऊसी RBF-बेसिस। स्थानीयता और किफ़ायती पैरामीटरीकरण देते हैं।
- प्रशिक्षण के दौरान Curriculum noise injection। मॉडल स्पष्ट रूप से शोर के प्रति स्थिरता सीखता है।
- Entropy-weighted adaptive regularisation। कम संख्या में उदाहरणों पर ओवरफ़िटिंग रोकता है।
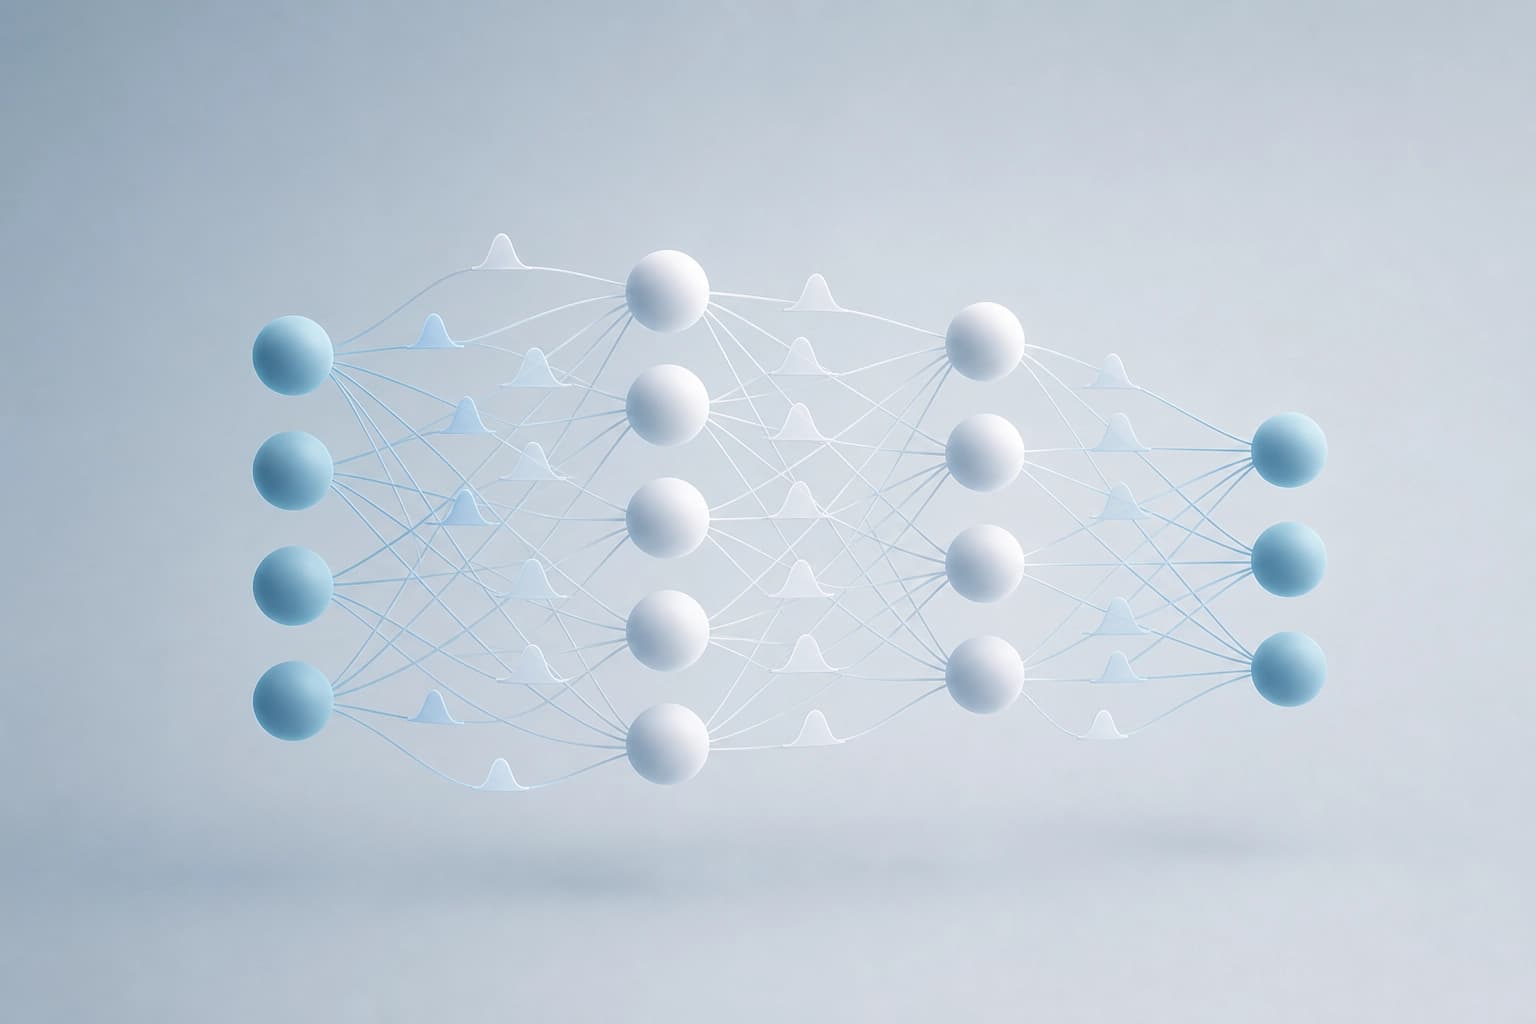
परिणाम: 595 पैरामीटर वाला नेटवर्क मध्यम शोर पर सटीकता में MLP से मेल खाता है। शोर बढ़ने पर यह कहीं अधिक हल्के ढंग से क्षीण होता है।
सत्यापन प्रोटोकॉल और उसका नकारात्मक परिणाम
प्रयोग कई शर्तों के समूहों पर बनाए गए हैं।
- आठ विश्लेषणात्मक फलन, उदाहरणों की संख्या N समूह 50, 200 और 500 से।
- शोर स्तर sigma समूह 0,03 और 0,1 से।
- अवमंदित हार्मोनिक ऑसिलेटर के लिए PINN: ER-KAN MLP की तुलना में 4,2 गुना कम solution MSE देता है।
- बर्गर्स समीकरण के लिए PINN: सभी मॉडल अभिसरित नहीं होते।
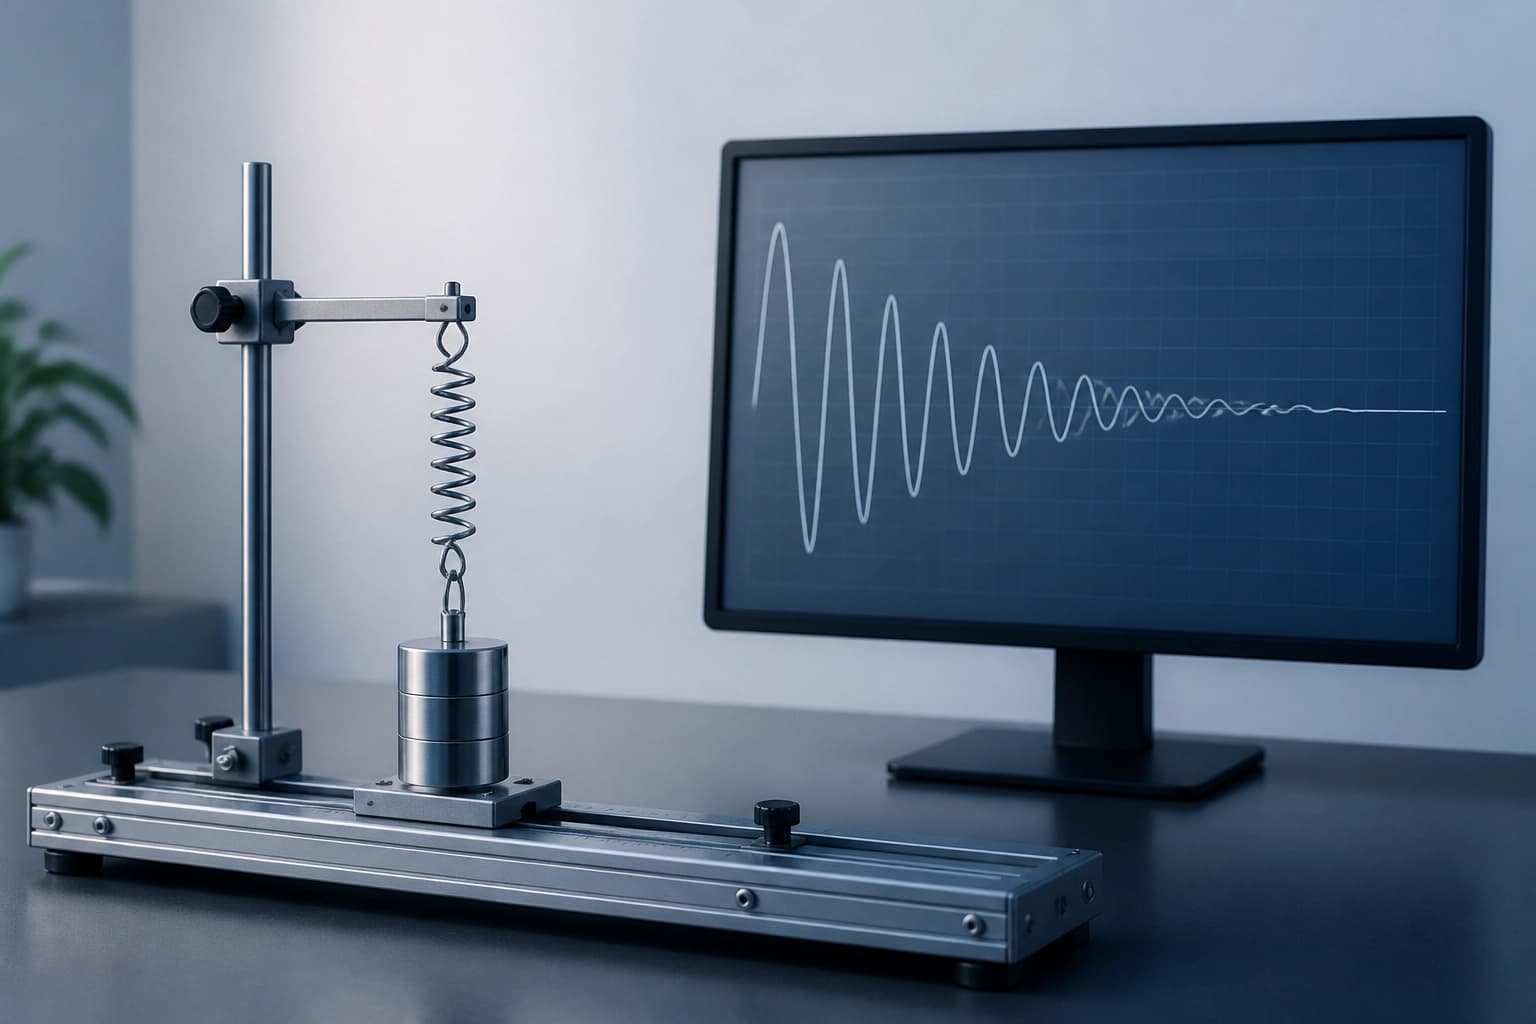
लेखक बर्गर्स समीकरण पर विफलता की जानकारी खुलकर देता है। यह विधि की सीमा है, रिपोर्ट का छिपा दोष नहीं। ऑसिलेटर पर निष्कर्ष स्वतः अन्य समीकरणों पर लागू नहीं होते।
Noise degradation ratio एक अलग मीट्रिक के रूप में
लेखक noise degradation ratio पेश करता है — मौजूदा मापों का सरल पूरक। मीट्रिक बताती है कि शोरयुक्त डेटा पर त्रुटि शुद्ध डेटा की त्रुटि से कितने गुना अधिक है। लेखक इसे कुशल KAN वेरिएंट पर लेखों में रिपोर्टिंग का अनिवार्य तत्व बनाने की सिफ़ारिश करता है।
मीट्रिक का व्यावहारिक मूल्य — आर्किटेक्चर की तुलना केवल सटीकता से नहीं, बल्कि स्थिरता से भी करना। उस साहित्य के लिए, जहाँ बेंचमार्क शुद्ध डेटा पर टिके थे, यह मूल्यांकन का मानदंड बदल देता है।
चयन का व्यावहारिक मानदंड
- शोरयुक्त डेटा और कम उदाहरण। ER-KAN परीक्षण किए गए वेरिएंट में त्रुटि की सबसे कम वृद्धि देता है।
- मध्यम शोर। 595 पैरामीटर वाला नेटवर्क सटीकता में MLP से मेल खाता है।
- तुलना के लिए सरल आधार चाहिए। मानक MLP ChebyKAN और मूल KAN की तुलना में कम क्षीण होता है।
- अवमंदित ऑसिलेटर के लिए PINN। ER-KAN MLP की तुलना में कम solution MSE दिखाता है।
- बर्गर्स समीकरण के लिए PINN। परीक्षण किए गए मॉडलों में से कोई भी अभिसरित नहीं हुआ।
चयन शोर के स्तर और नमूने के आयतन पर आधारित है, न कि शुद्ध डेटा पर परिणामों पर। जहाँ शोर मौजूद है, वहाँ noise degradation ratio के बिना रिपोर्ट अधूरी है।


