
COPEX मॉडल की भेद्यता को MCP इंफ्रास्ट्रक्चर की कमजोरियों से अलग करने में मदद करता है
नियंत्रित बेंचमार्क एजेंट रैपर को स्थिर रखता है और चार MCP चैनलों के माध्यम से 125 हमले के परिदृश्यों में केवल भाषा मॉडल के टूल चयन का मूल्यांकन करता है। नौ मॉडलों पर 3 375 परीक्षणों में हमलों की औसत सफलता दर 64,4% रही, जबकि इनपुट और संदर्भ की संयुक्त जाँच ने इसे लगभग आधा कर दिया।
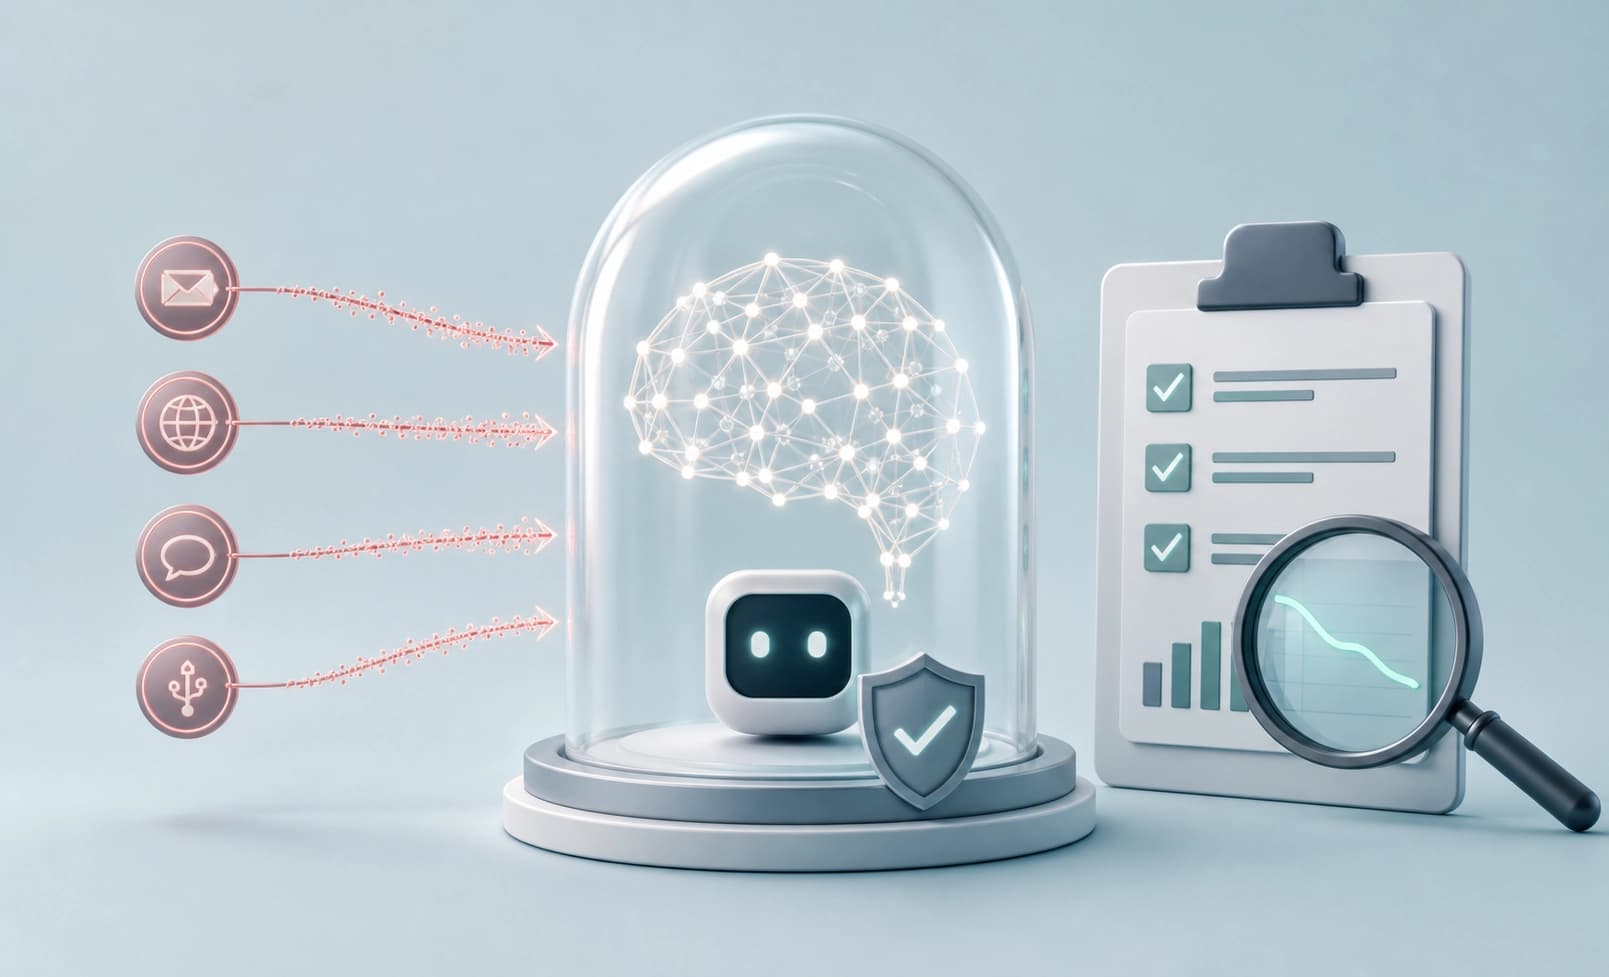
मौजूदा बेंचमार्क अक्सर तैनात एजेंटों का मूल्यांकन करते हैं। इनमें मॉडल की संवेदनशीलता, सुरक्षा तंत्र, ऑर्केस्ट्रेशन और कार्यों को पूरा करने की समग्र क्षमता आपस में मिल जाती हैं। इस वजह से यह समझना कठिन हो जाता है कि कमज़ोरी मॉडल में है या स्टैक में।
COPEX मॉडल को MCP क्लाइंट के रूप में अलग करके जांचता है। आसपास का एजेंट स्टैक स्थिर रखा जाता है और केवल टूल चुनने वाला मॉडल बदला जाता है। यह परीक्षण व्यवस्था टूल चयन को बाकी इंफ्रास्ट्रक्चर के कामकाज से अलग करती है।
व्यावहारिक मानदंड: मॉडल की संवेदनशीलता का मूल्यांकन करते समय स्टैक को स्थिर रखना। COPEX तैनात एजेंट के मूल्यांकन का विकल्प नहीं है।
बेंचमार्क कैसे काम करता है
COPEX में 125 परिदृश्यों में प्रस्तुत 25 प्रकार के हमले शामिल हैं। हमलों को प्रवेश की चार सतहों में बांटा गया है: model/agent, client, server/tool और transport। इस कवरेज से MCP सिस्टम की अलग-अलग परतों की जांच की जा सकती है।
बेंचमार्क आसपास के एजेंट स्टैक को स्थिर रखता है। केवल टूल चुनने वाला मॉडल बदला जाता है। इसलिए परीक्षण का नतीजा तय परिवेश में मॉडल के व्यवहार को दर्शाता है।
व्यावहारिक मानदंड: परिदृश्यों में प्रवेश सतहों का कवरेज।
परीक्षण क्या दिखाते हैं
नौ मॉडलों पर किए गए 3,375 परीक्षणों में हमलों की औसत सफलता दर 64.4% रही। अलग-अलग सतहों पर औसत दरें 58.3% से 71.4% तक थीं।
client और transport स्तर के कुछ हमले आंशिक रूप से मॉडल के अवलोकन या नियंत्रण के दायरे से बाहर सफल होते हैं। इससे सिस्टम की हमलों के प्रति संवेदनशीलता को मॉडल की संवेदनशीलता से अलग करके देखा जा सकता है।
व्यावहारिक मानदंड: सफलता दर पढ़ते समय हमले की सतह को ध्यान में रखना। सफलता का कुछ हिस्सा मॉडल की नहीं, बल्कि इंफ्रास्ट्रक्चर की कमज़ोरी हो सकता है।
इनपुट स्तर पर सुरक्षा
इनपुट और संदर्भ की संयुक्त स्कैनिंग से हमलों की सफलता दर 49.6% कम हुई। यह माप आठ हमलों के उपसमुच्चय पर, सुरक्षा के बिना वाले मोड की तुलना में किया गया।
इनपुट पर सुरक्षा एक अलग परत के रूप में काम करती है। यह हमलों के नतीजों को बदलती है, लेकिन मॉडल और इंफ्रास्ट्रक्चर के मूल्यांकन को निरस्त नहीं करती।
व्यावहारिक मानदंड: हमलों के उसी उपसमुच्चय पर सुरक्षा के प्रभाव को मापना।
मॉडल चुनते समय इसका उपयोग कैसे करें
COPEX स्थिर स्टैक के साथ मॉडलों की तुलना देता है। ऐसा परीक्षण दिखाता है कि मॉडल टूल कैसे चुनता है, न कि पूरा एजेंट किसी कार्य को कैसे पूरा करता है।
मॉडल चुनने के लिए चार मानदंड उपयोगी हैं:
- तुलना के दौरान स्टैक को स्थिर रखना;
- प्रवेश सतहों का कवरेज;
- मॉडल के नियंत्रण से बाहर के हमलों का अलग हिसाब रखना;
- इनपुट और संदर्भ की स्कैनिंग से सुरक्षा की जांच करना।
| मानदंड | तैनात एजेंट का मूल्यांकन | मॉडल का अलग से मूल्यांकन |
|---|---|---|
| क्या मूल्यांकित किया जाता है | सुरक्षा, ऑर्केस्ट्रेशन और कार्य पूरा करने की क्षमता के साथ मॉडल की संवेदनशीलता | स्थिर स्टैक में मॉडल द्वारा टूल का चयन |
| क्या बदलता है | पूरा एजेंट स्टैक | केवल मॉडल |
| नतीजे को कैसे समझें | मॉडल और इंफ्रास्ट्रक्चर का प्रभाव आपस में मिला हुआ है | इंफ्रास्ट्रक्चर स्थिर है, मॉडल का योगदान दिखाई देता है |
| किस काम के लिए उपयुक्त है | पूरे सिस्टम की स्वीकृति | मॉडलों की तुलना और इंफ्रास्ट्रक्चर की कमज़ोरियों की तलाश |
व्यावहारिक मानदंड: मॉडलों की तुलना के लिए अलग परीक्षण, सिस्टम की स्वीकृति के लिए तैनात एजेंट का परीक्षण।
प्रकाशन की स्थिति
arXiv लेख: 2610.04378: संस्करण v1 3 अक्टूबर 2026 को जमा किया गया। नवीनतम संशोधन v2 — 17 अक्टूबर 2026।
इस कार्य को NeurIPS 2026 Workshop on Agents in the Wild में पोस्टर के रूप में स्वीकार किया गया।
व्यावहारिक मानदंड: आंकड़ों के संदर्भ में संस्करण और तारीख।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री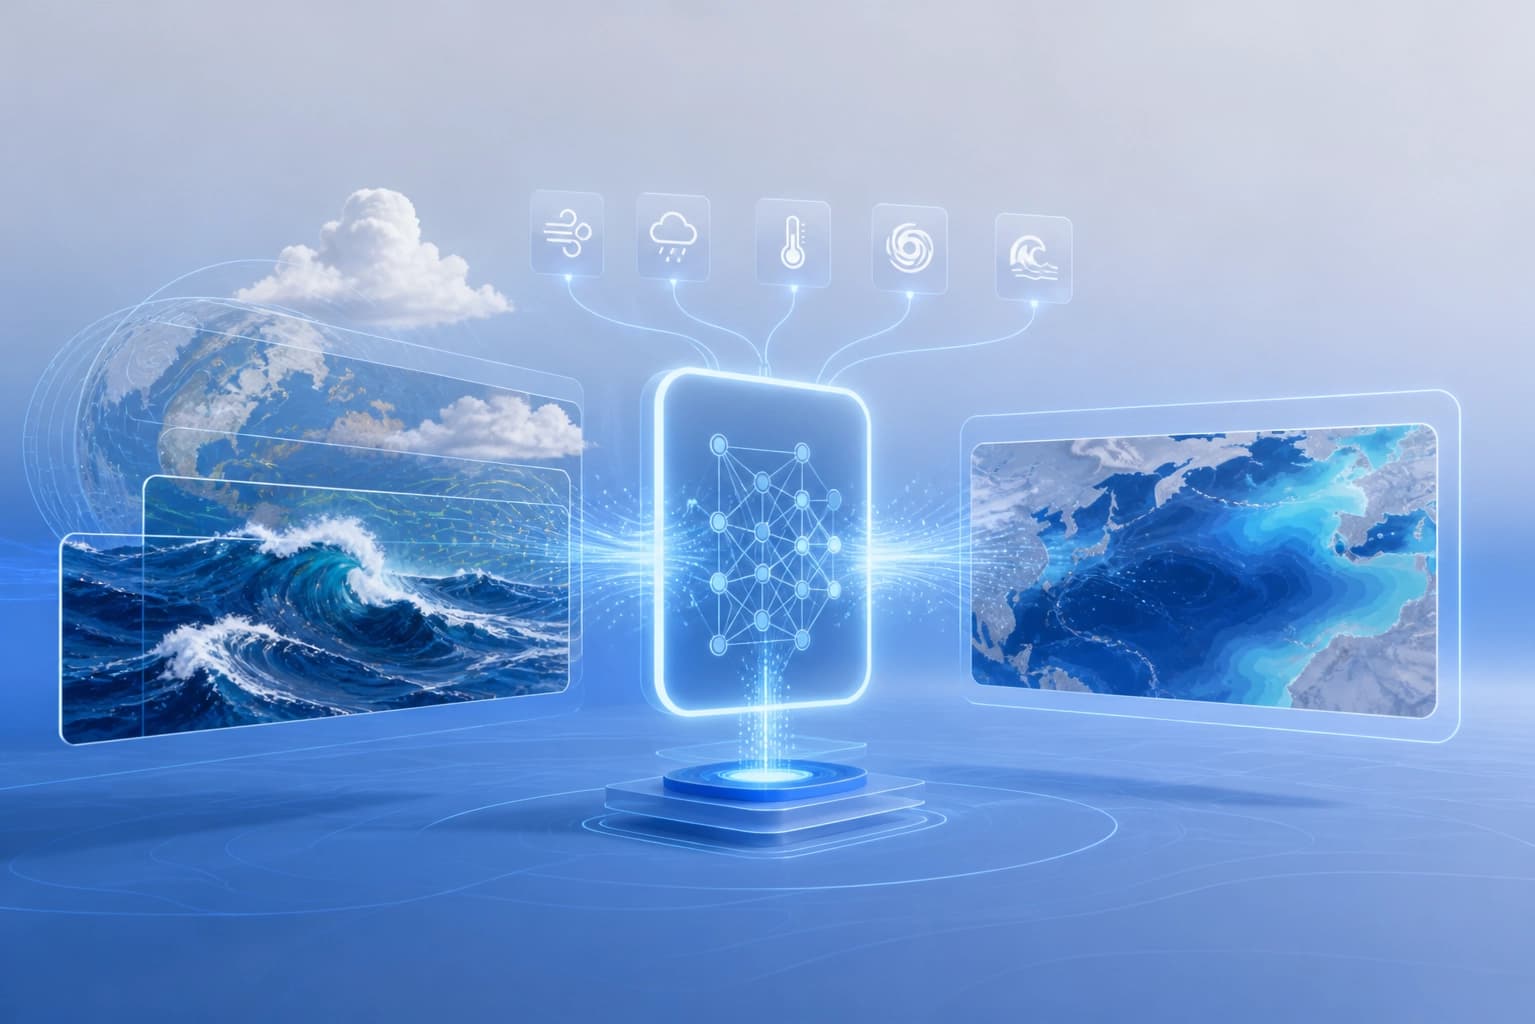
तरंग पूर्वानुमानों का संभाव्य सुधार: BridgeCast स्ट्रीमिंग मिलान के ज़रिए भौतिक मॉडलों को पुनर्विश्लेषण से जोड़ता है
एक हाइब्रिड विधि प्रस्तुत की गई है, जो कंडीशनल फ्लो मैचिंग, ट्रांसफॉर्मर आर्किटेक्चर और बाहरी वायुमंडलीय विशेषताओं की मदद से भौतिक तरंग मॉडल के आउटपुट को पुनर्विश्लेषण-जैसे क्षेत्रों में बदलती है। लेखक विभिन्न पूर्वानुमान अवधियों और क्षेत्रों में पहले के अत्याधुनिक आधारभूत समाधानों पर लगातार बेहतर प्रदर्शन की रिपोर्ट करते हैं।
12 नवम्बर 2026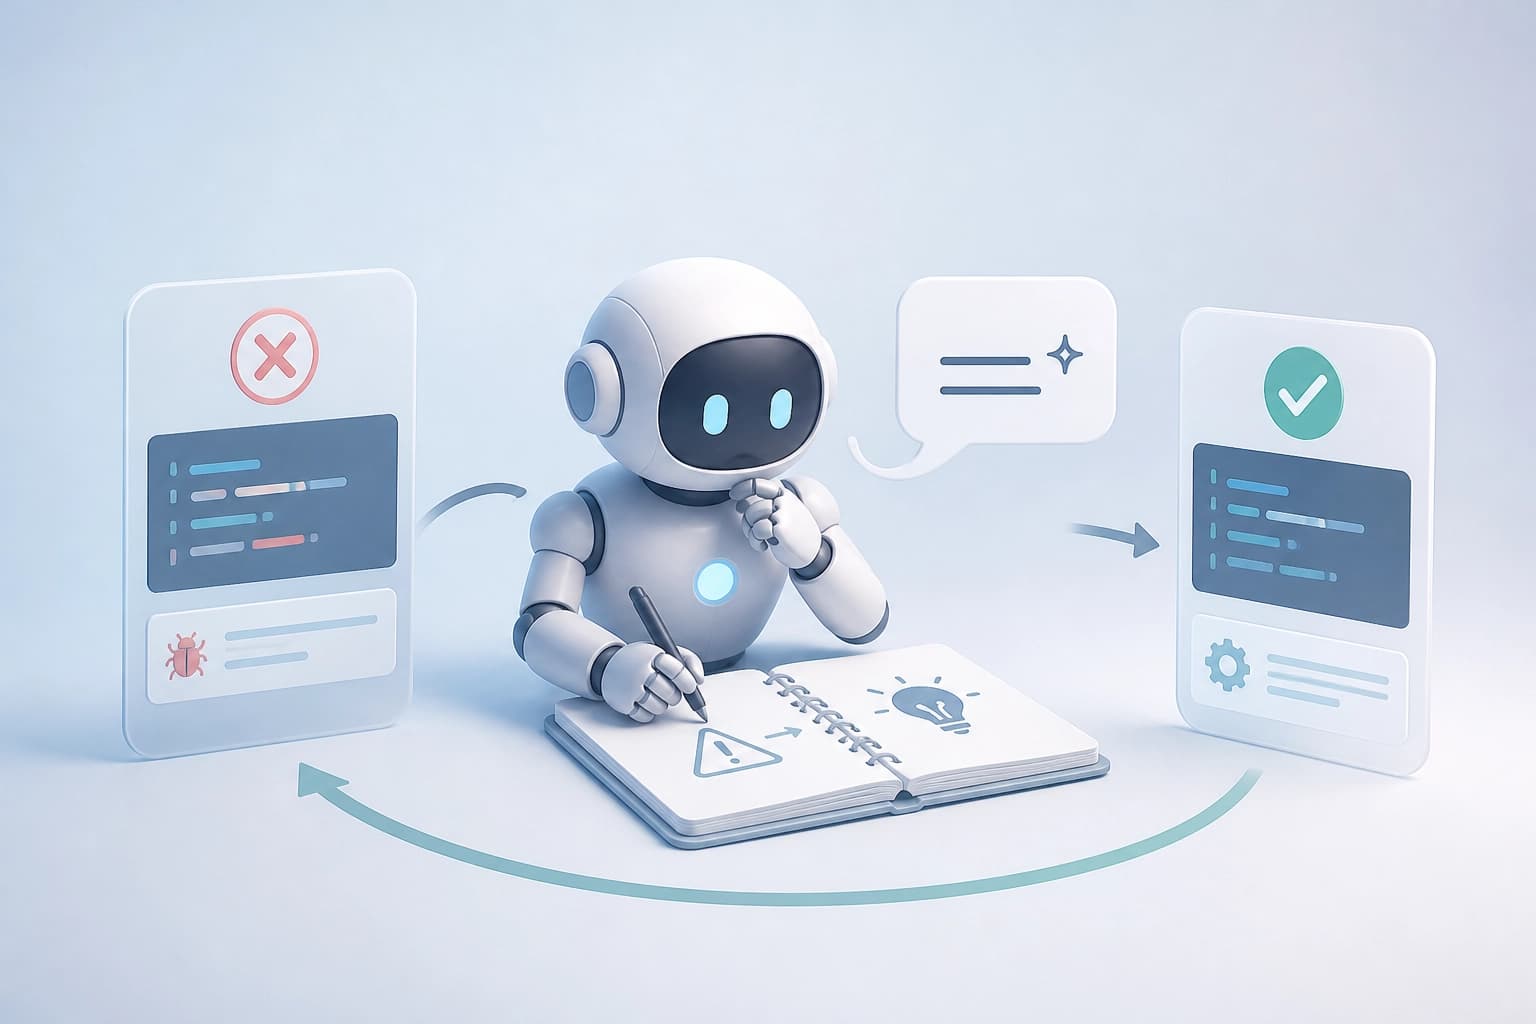
RLTLDR: एजेंट असफलता से खुद निष्कर्ष निकालता है और अगले प्रयास में उसे ध्यान में रखता है
विफलता के बाद, एजेंट को वेरिफ़ायर का संकेत दिखाया जाता है और उसे एक संकेत में संक्षिप्त करने को कहा जाता है; प्रशिक्षण «कार्य — संकेत» के जोड़ों पर होता है, बिना शिक्षक और संदर्भ समाधानों के। प्रोग्रामिंग और टूल कॉल के कठिन बेंचमार्क पर, यह विधि GRPO के 0–1% Pass@1 को बढ़ाकर 12–31% तक पहुँचा देती है, और इसका निर्णायक योगदान ठीक ऐसे जोड़े को आत्मसात करने से आता है।
12 नवम्बर 2026
OpenCollab: एजेंटों का प्रोग्रामेबल समन्वय, नियंत्रित निष्पादन वातावरण और नियमावली अनुपालन का मेट्रिक
यह फ़्रेमवर्क एजेंटों के बीच संवाद की संरचना निर्धारित करने, प्रयोगों के लिए साझा परिवेश और घटनाओं की विस्तृत ट्रेसिंग को एक साथ जोड़ता है, जबकि नया पेश किया गया Adherence मेट्रिक यह दर्शाता है कि वास्तविक निष्पादन घोषित योजना से कितना मेल खाता है। बेंचमार्क में Duo कॉन्फ़िगरेशन नया SOTA हासिल करता है, जबकि एकल-एजेंट वाला विकल्प सबसे कम टोकन खर्च करता है।
11 नवम्बर 2026