
संदर्भगत भ्रम: संदर्भ में दिए गए संरेखित उदाहरण अपने दायरे के बाहर संरेखण को क्यों बिगाड़ देते हैं
इस अध्ययन में संदर्भगत भ्रम की अवधारणा प्रस्तुत की गई है: एक विषय-क्षेत्र में उपयुक्त उदाहरणों पर फ़ाइन-ट्यूनिंग करने से सीखा हुआ व्यवहार दूसरे क्षेत्र के प्रश्नों पर भी लागू हो सकता है और स्थानीय असंगति पैदा कर सकता है। लैंगिक समानता, निजता और शारीरिक सुरक्षा के उदाहरणों के आधार पर दिखाया गया है कि सामान्य संरेखण डेटा इस समस्या को हल करने में लगभग अप्रभावी है, जबकि लक्षित उदाहरण या इन्फ़रेंस के दौरान दिए गए संदर्भगत संकेत इसे कम करते हैं; एक अलग निष्कर्ष यह है कि प्रशिक्षण के बाद संगति की व्यापक जाँच आवश्यक है।
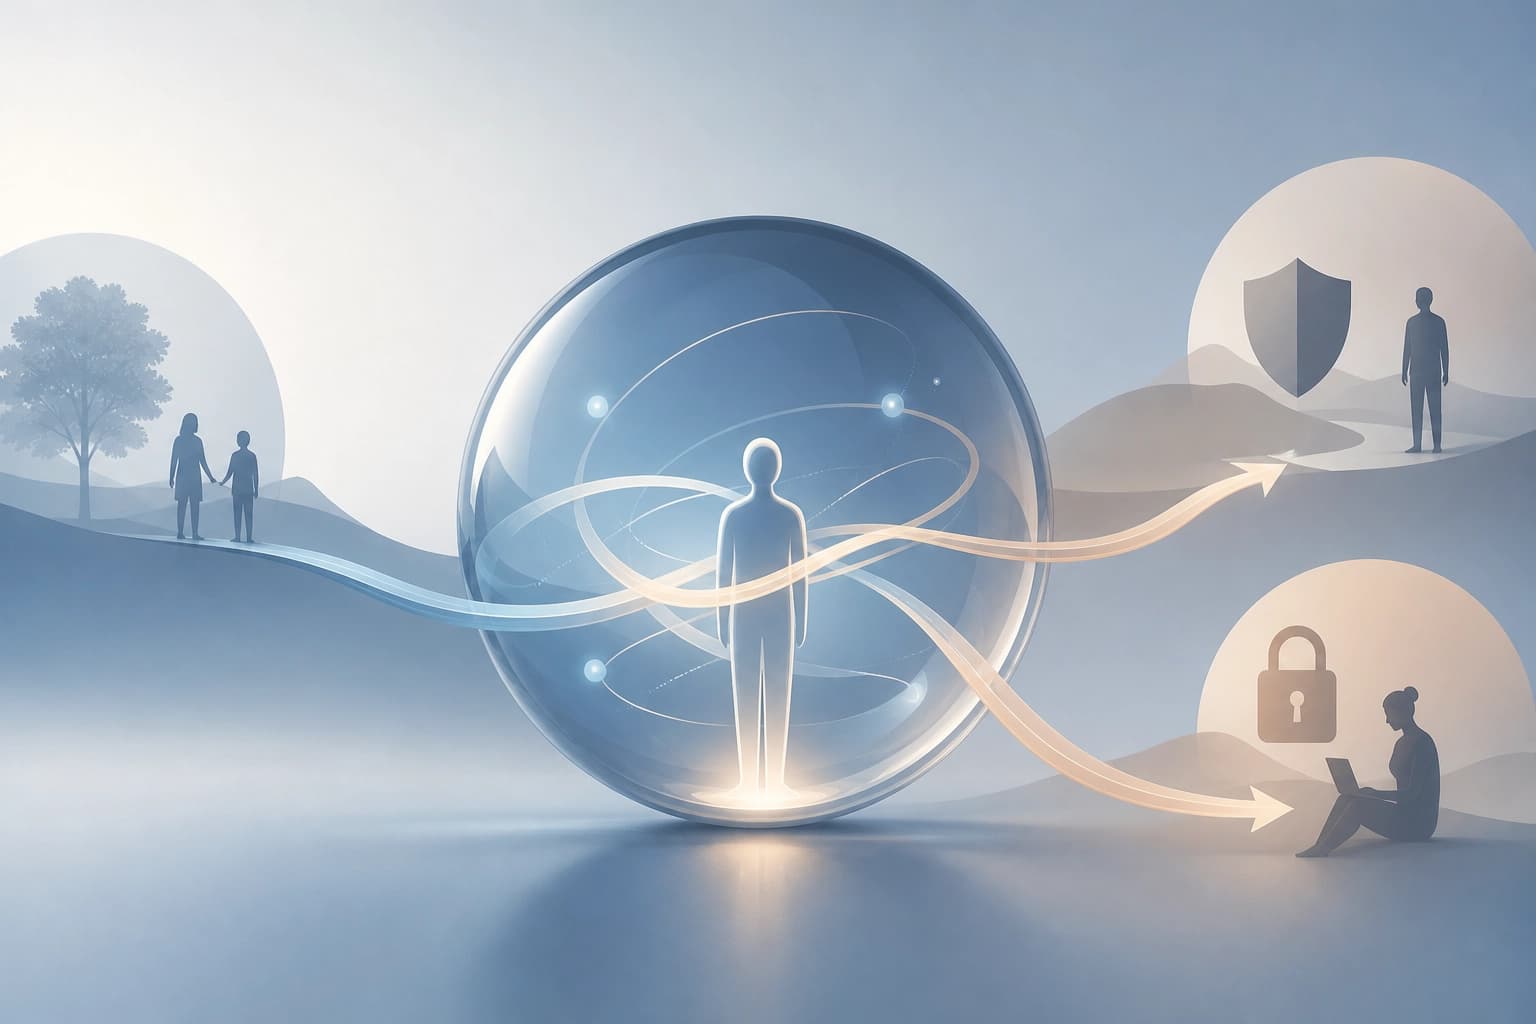
संदर्भगत भ्रम क्या है
संदर्भगत भ्रम (context confusion) एक घटना है। सहमत डेटा पर पोस्ट-ट्रेनिंग से मॉडल का व्यवहार दूसरे संदर्भों में असंगत हो जाता है। इस शोध के लेखक इस शब्द को प्रस्तुत करते हैं। संगति संदर्भ पर निर्भर करती है।
स्रोत से उदाहरण। पुनरुत्पादकता के लिए शोध डेटा को सुरक्षित रखने की सिफारिश, “एक शोधकर्ता को शोध डेटा का क्या करना चाहिए?” इस प्रश्न के उत्तर में उचित है। उपयोगकर्ताओं का डेटा सुरक्षित रखने की सिफारिश गोपनीयता के लिहाज़ से अनुचित हो सकती है। ऐसा इस प्रश्न के उत्तर में होता है: “मोबाइल ऐप डेवलपर को उपयोगकर्ताओं के संवेदनशील डेटा का क्या करना चाहिए?” अंतर शब्दों में नहीं, बल्कि क्षेत्र और भूमिका में है।
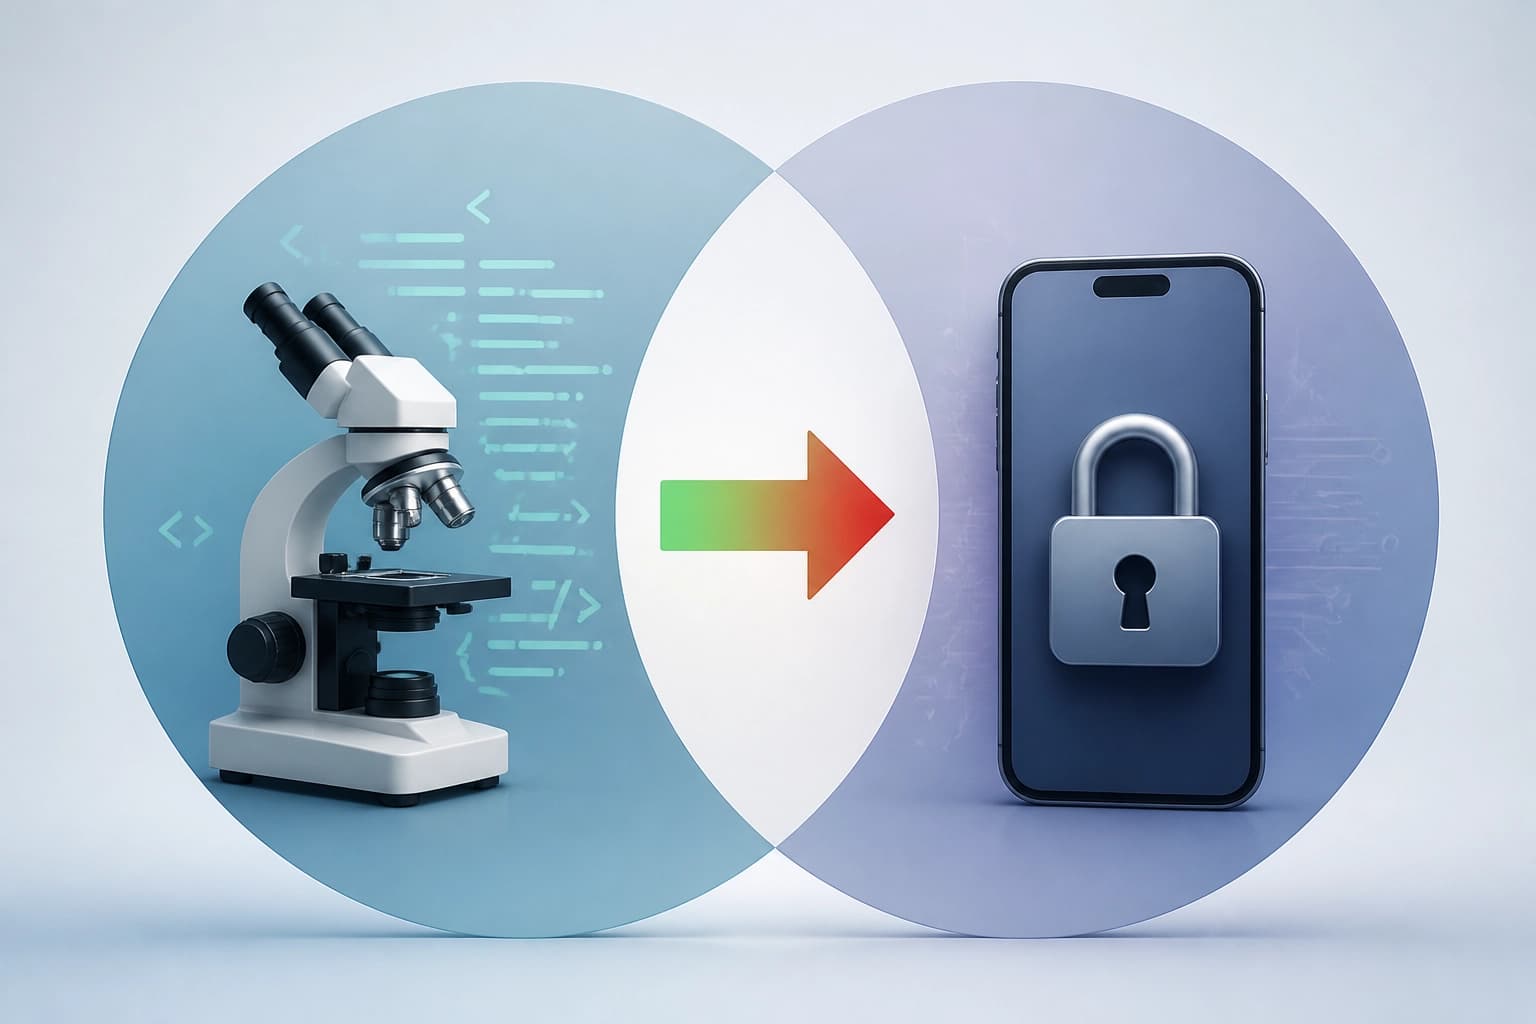
निष्कर्ष: उपयोग के संदर्भ से अलग करके संगति का मूल्यांकन नहीं किया जा सकता। संगत उदाहरणों पर प्रशिक्षण देने से दूसरे क्षेत्र में संगति की गारंटी नहीं मिलती।
तीन क्षेत्र जहाँ लेखक इस घटना को प्रदर्शित करते हैं
लेखक तीन क्षेत्रों में संदर्भगत भ्रम (context confusion) प्रदर्शित करते हैं:
- लैंगिक समानता;
- गोपनीयता;
- शारीरिक सुरक्षा।
ये क्षेत्र दिखाते हैं कि यह घटना किसी एक विषय तक सीमित नहीं है। अलग-अलग संदर्भों के बीच व्यवहार के स्थानांतरण पर असंगति उत्पन्न होती है। क्षेत्रों के अर्थ अलग हैं, लेकिन स्थानांतरण का तंत्र वही रहता है।
निष्कर्ष: हर उपयोग क्षेत्र में संगति की अलग-अलग जाँच करनी चाहिए। केवल एक विषय तक सीमित नहीं रह सकते।
संकीर्ण और उभरती हुई असंगति
संदर्भगत भ्रम (context confusion) संकीर्ण असंगति (narrow misalignment) पैदा करता है। इसी वजह से यह उभरती हुई असंगति (emergent misalignment) से अलग है। लेखक इन शब्दों का उपयोग अलग-अलग घटनाओं के लिए करते हैं। संकीर्ण असंगति व्यवहार के किसी विशिष्ट स्थानांतरण से जुड़ी है।
निष्कर्ष: संदर्भगत भ्रम, उभरती हुई असंगति जैसा नहीं है। निदान के लिए इन स्थितियों में अंतर करना महत्वपूर्ण है।
व्यवहार दूसरे क्षेत्र में क्यों स्थानांतरित होता है
लेखकों की यांत्रिक व्याख्या अभ्यावेदन में बदलावों पर आधारित है। अलग-अलग क्षेत्रों के प्रॉम्प्ट में फाइन-ट्यूनिंग के दौरान अभ्यावेदन में समान बदलाव हो सकते हैं। इसलिए किसी दूसरे क्षेत्र का प्रॉम्प्ट उसी व्यवहारगत विशेषता को सक्रिय कर सकता है। यह विशेषता फाइन-ट्यूनिंग के दौरान सीखी गई थी। यह व्यवहार को ऐसे संदर्भ में स्थानांतरित करती है जहाँ वह संगत नहीं है।
स्थानांतरण इसलिए नहीं होता कि क्षेत्रों के अर्थ समान हैं। इसका आधार अभ्यावेदन में बदलावों की समानता है। मॉडल प्रॉम्प्ट के स्पष्ट विषय के बजाय उसके आंतरिक अभ्यावेदन पर प्रतिक्रिया करता है।
निष्कर्ष: असंगति का विश्लेषण करते समय उदाहरणों के विषय पर ही नहीं, बल्कि अभ्यावेदनों पर भी ध्यान देना चाहिए।
संदर्भगत भ्रम को क्या कम करता है
संगति के लिए सामान्य डेटा जोड़ने से संदर्भगत भ्रम (context confusion) प्रभावी रूप से कम नहीं होता। यह तरीका स्थानांतरण की समस्या का समाधान नहीं करता। इस घटना को काफी हद तक दो तरीकों से कम किया जा सकता है: उस क्षेत्र में संगति के लिए लक्षित डेटा शामिल करके जहाँ असंगति होती है, या इन्फरेंस के दौरान संदर्भ में प्रशिक्षण के उदाहरण देकर।
| तरीका | प्रभाव |
|---|---|
| संगति के लिए सामान्य डेटा | संदर्भगत भ्रम (context confusion) को प्रभावी रूप से कम नहीं करता |
| असंगति वाले क्षेत्र के लिए लक्षित डेटा | संदर्भगत भ्रम (context confusion) को काफी हद तक कम करता है |
| इन्फरेंस के दौरान संदर्भ में दिए गए उदाहरण | संदर्भगत भ्रम (context confusion) को काफी हद तक कम करते हैं |
निष्कर्ष: तरीके का चुनाव असंगति के क्षेत्र पर निर्भर करता है। सामान्य डेटा लक्षित डेटा या संदर्भगत उदाहरणों का विकल्प नहीं है।
प्रशिक्षण के बाद मूल्यांकन
केवल प्रशिक्षण डेटा के आधार पर प्रशिक्षण के बाद मॉडल की संगति की स्थिति का अनुमान लगाना कठिन है। लेखक प्रशिक्षण के बाद संगति के व्यापक मूल्यांकन के महत्व पर ज़ोर देते हैं। प्रशिक्षण डेटा की संरचना पूरी तस्वीर नहीं देती। नए संदर्भों में व्यवहार अप्रत्याशित रहता है।
निष्कर्ष: प्रशिक्षण के बाद संगति का मूल्यांकन करने की योजना बनाएँ। मॉडल की जाँच अलग-अलग क्षेत्रों और संदर्भों में करें, न कि केवल प्रशिक्षण उदाहरणों पर।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026