
मल्टी-एजेंट AI में केंद्रीकृत मेमोरी प्रबंधन: कम लागत में वैयक्तिकरण
लेखक साझा मेमोरी की एक सिस्टम लेयर का प्रस्ताव रखते हैं: एजेंट संरचित जानकारी सहेजते हैं, जबकि सिस्टम उसके चयन, डेटा सुरक्षा और मॉडलों तक पहुँचाने को नियंत्रित करता है। AIOS पर परीक्षणों में, इस दृष्टिकोण ने बाहरी स्टोरेज और RAG की तुलना में वैयक्तिकरण को बेहतर बनाया, और पूर्ण संदर्भ भेजने की तुलना में दो में से तीन मॉडलों पर तुलनीय परिणाम देते हुए विलंबता 15–61% तक घटाई।
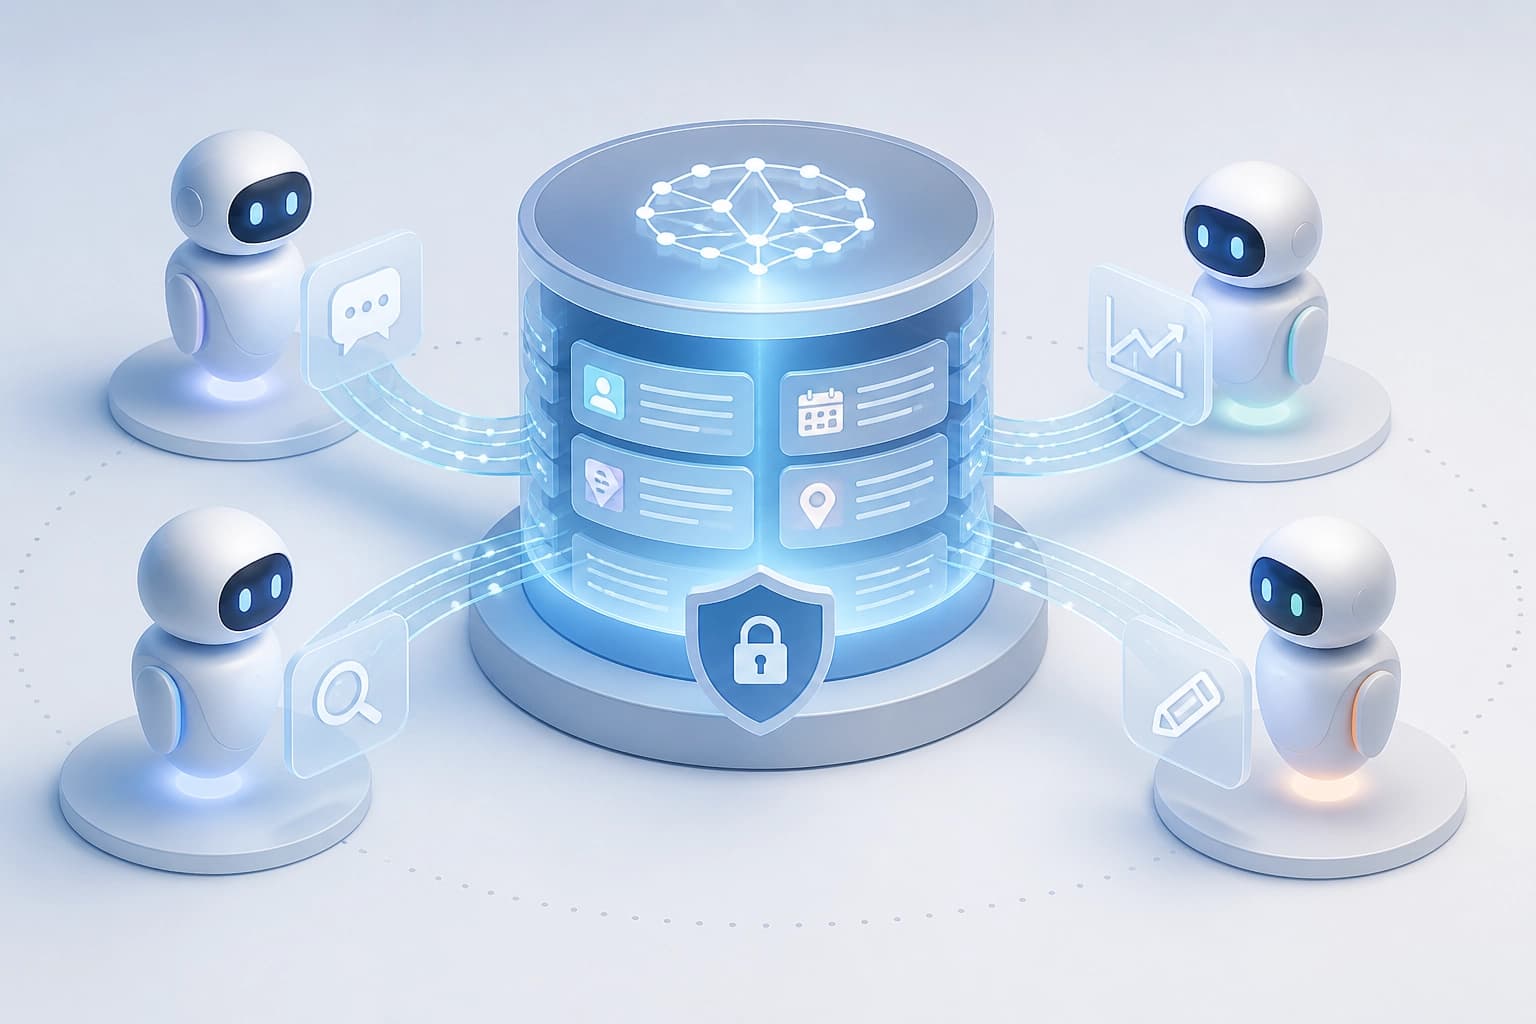
केंद्रीय मेमोरी कैसे काम करती है
विशेषीकृत एजेंट लेबल वाली संरचित यादें दर्ज करते हैं। एजेंट सिस्टम का कर्नेल उनके पुनर्प्राप्ति, गोपनीयता और प्रॉम्प्ट में जोड़ने को नियंत्रित करता है।
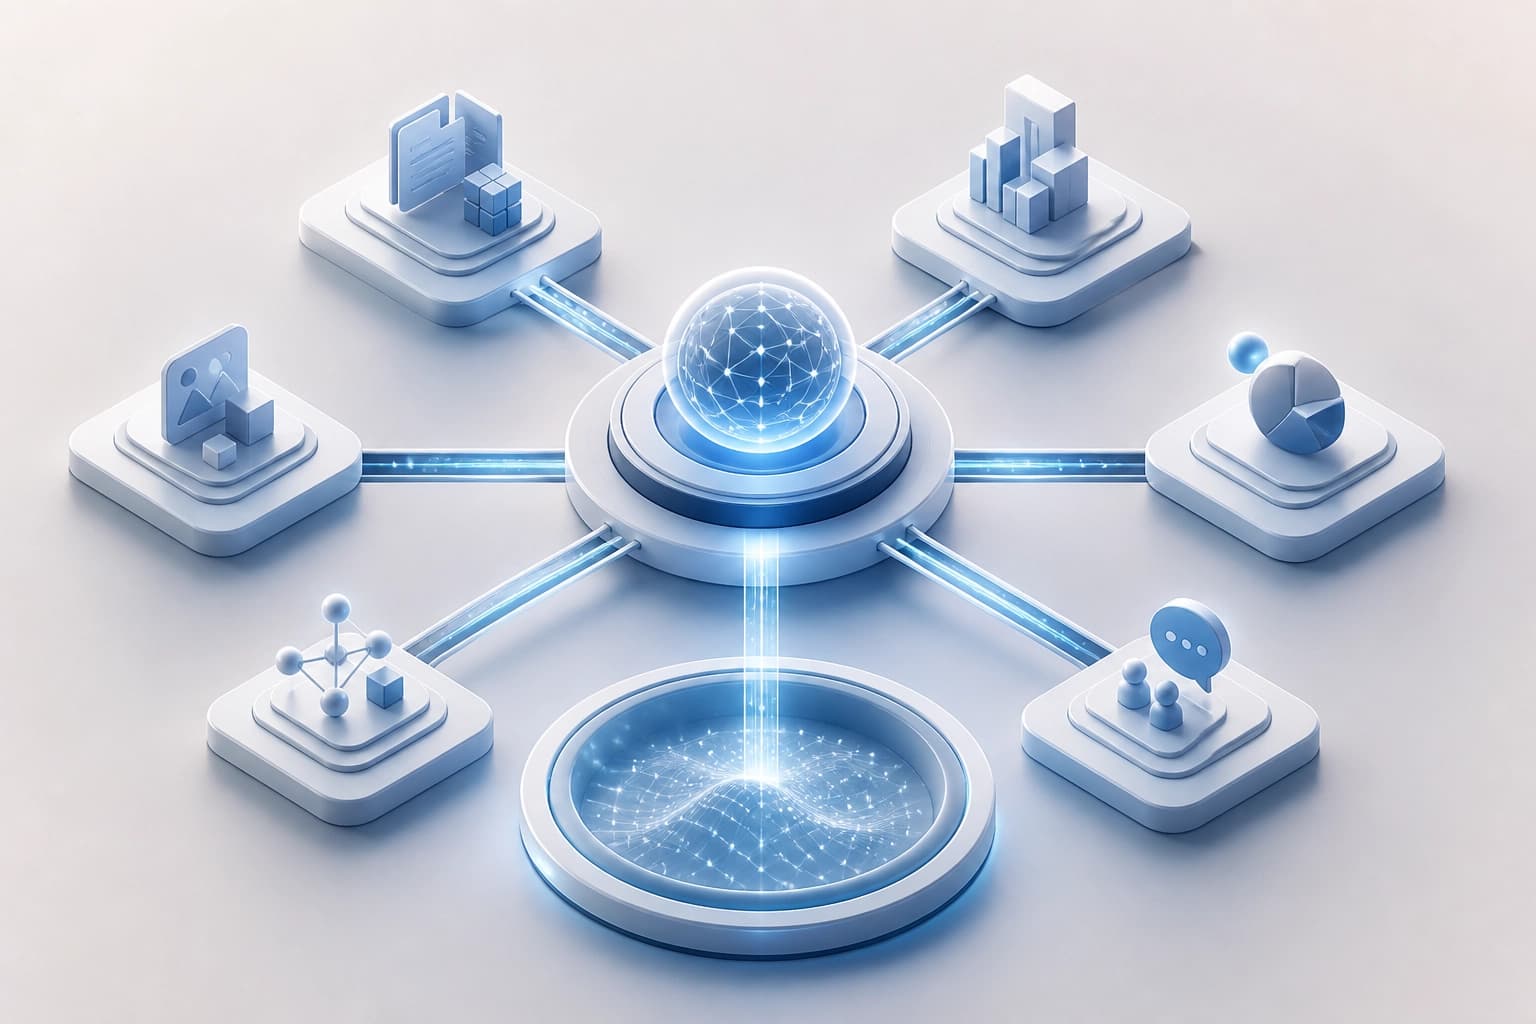
इस व्यवस्था में एजेंट यादें बनाते हैं, और कर्नेल तय करता है कि सिस्टम उनका उपयोग कैसे करता है:
- दर्ज करना: एजेंट लेबल वाली संरचित यादें सहेजते हैं।
- पुनर्प्राप्ति: इसे अलग-अलग एजेंट नहीं, बल्कि कर्नेल नियंत्रित करता है।
- सुरक्षा और समावेशन: गोपनीयता और प्रॉम्प्ट में यादें जोड़ने की ज़िम्मेदारी कर्नेल की होती है।
केंद्रीकरण से यादें बनाने और उनके उपयोग को नियंत्रित करने की प्रक्रिया अलग हो जाती है। यह तब महत्वपूर्ण है, जब पुनर्प्राप्ति और समावेशन के नियम पूरे एजेंट सिस्टम पर लागू होने चाहिए।
इस दृष्टिकोण का परीक्षण कैसे किया गया
इस डिज़ाइन को AIOS पर लागू किया गया और उसका मूल्यांकन किया गया। लेखकों ने तीन सहायक मॉडलों पर इसकी तुलना तीन विकल्पों से की।
- GPT-4o
- Llama-3.1:8B
- Qwen-2.5:7B
इस अध्ययन में कुल 1 800 परीक्षण शामिल थे। इस हिस्से में परीक्षण के पैमाने का वर्णन है, न कि तुलना की अलग-अलग शर्तों का।
तुलनाओं से क्या पता चला
परिणाम इस बात पर निर्भर करते हैं कि मेमोरी के साथ कैसे काम किया जाता है। तालिका में तीन विकल्पों के लिए लेखकों के निष्कर्ष दिए गए हैं।
| विकल्प | केंद्रीकृत प्रबंधन का परिणाम |
|---|---|
| उसी आधारभूत स्टोरेज के साथ Mem0 | वैयक्तिकरण के स्कोर पाँच-बिंदु पैमाने पर 2,4–4,0 अंक बढ़े। हर तुलना सांख्यिकीय रूप से महत्वपूर्ण है: p < 10^-18. |
| retrieval-augmented generation के ज़रिए मानक समावेशन | तीनों मॉडलों पर सुधार बड़े और लगातार रहे। |
| संदर्भ का पूरा, बिना फ़िल्टर किया हुआ संयोजन | दो मॉडलों पर परिणाम सांख्यिकीय रूप से तुलनीय रहे; तीसरे पर केंद्रीकृत विकल्प का प्रदर्शन थोड़ा कम रहा। प्रॉम्प्ट छोटे हुए और सभी मॉडलों पर शुरू से अंत तक की देरी 15–61% घट गई। प्रति कॉल टोकन की संख्या और इन्फ़रेंस की लागत भी कम हुई। |
GPT-4o के लिए, प्रोफ़ाइल के उपयोग का स्कोर 1,05 से बदलकर 4,69 हो गया। यह माप Mem0 के साथ तुलना का परिणाम दर्शाता है।
केंद्रीकरण पर कब विचार करें
अगर सिस्टम को यादों की पुनर्प्राप्ति, सुरक्षा और समावेशन के लिए साझा नियमों की ज़रूरत है, तो मेमोरी के केंद्रीय प्रबंधन पर विचार करना चाहिए। इस दृष्टिकोण में ये निर्णय अलग-अलग एजेंटों से हटाकर सिस्टम के कर्नेल को सौंप दिए जाते हैं।
एक व्यावहारिक कसौटी यह है कि ज़रूरी वैयक्तिकरण की तुलना संदर्भ की स्वीकार्य मात्रा और लागत से की जाए। लेखकों का निष्कर्ष है कि केंद्रीकरण से असीमित संदर्भ के वैयक्तिकरण संबंधी अधिकांश लाभ मिलते हैं, जबकि लागत काफ़ी कम रहती है।
यह लेख सिस्टम-व्यापी वैयक्तिकरण के लिए कर्नेल-प्रबंधित साझा मेमोरी रायन लूम और योंगफ़ेंग झांग का है, जिसे 9 सितंबर 2026 को प्रस्तुत किया गया था।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026