
CARAT: यह जांचता है कि पदार्थ-विज्ञान के LLM संरचना प्रस्तुत करते हैं या प्रॉम्प्ट को दोहराते हैं
इस कार्य में एक ऐसा प्रोटोकॉल प्रस्तावित है जो संरचना प्रस्तुत करने के आठ तरीकों में प्रश्न और संदर्भ उत्तर को स्थिर रखता है तथा GraphSpace में संबंधों को अलग से चिह्नित करता है। युग्मित फाइन-ट्यूनिंग, लक्ष्य फ़ील्ड को मास्क करने और साक्ष्य जोड़ने के प्रयोगों से पता चलता है कि मॉडल संबंध का उपयोग करना और लिंक का अनुसरण करना—दोनों सीख सकता है, लेकिन लिंक हटाने से सटीकता अनुमानी खोज विधियों के स्तर से भी नीचे गिर जाती है।
सटीकता तर्क को क्यों साबित नहीं करती
सामग्री विज्ञान के लिए भाषा मॉडल दो अलग-अलग कारणों से सही जवाब दे सकता है। या तो वह संरचनात्मक डेटा से जवाब निकालता है, या इनपुट में पहले से मौजूद मान को दोहराता है। सामान्य सटीकता मेट्रिक इन दोनों स्थितियों में अंतर नहीं करता। संरचनात्मक विवरण में वह फ़ील्ड हो सकता है जिसके आधार पर जवाब का मूल्यांकन किया जाता है; ऐसे में स्कोर केवल संकेत पढ़ने की क्षमता दिखाता है।
CARAT बेंचमार्क इसी अंतर पर आधारित है। यह जाँचता है कि सामग्री विज्ञान के LLM संरचनात्मक डेटा के आधार पर तर्क करते हैं या संकेत को दोहराते हैं। शोधपत्र के लेखक Jiajun Wu, Jian Yang, Zixiang Ni, Zhenzhu Li और Bin Chong हैं; यह काम 29 सितंबर 2026 को प्रस्तुत किया गया था।
व्यावहारिक कसौटी: संरचनात्मक डेटा पर उच्च सटीकता अपने आप में कुछ साबित नहीं करती। यह देखना ज़रूरी है कि जवाब किन परिस्थितियों में मिला।
मिलान की गई तुलना कैसे काम करती है
आठ मिलान किए गए निरूपणों में प्रश्न और संदर्भ उत्तर एक जैसे रखे जाते हैं। संरचनात्मक संबंधों को GraphSpace में अलग से दर्शाया जाता है।
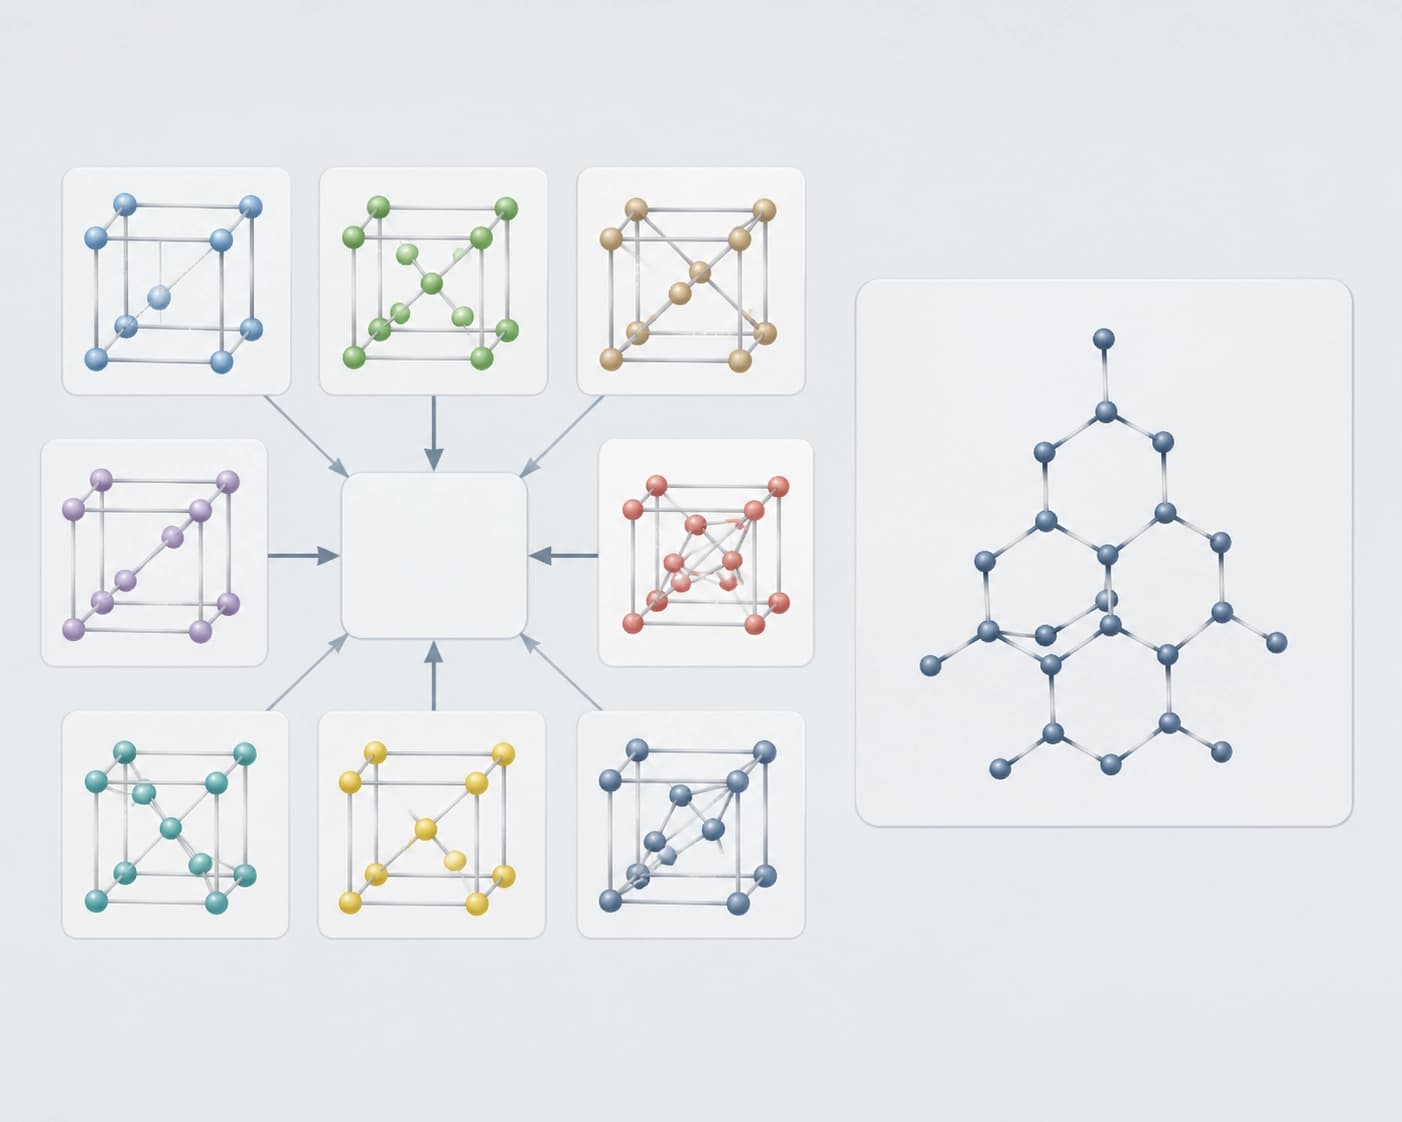
इसके अलावा मिलान के साथ फ़ाइन-ट्यूनिंग, जवाबों को मास्क करना, साक्ष्य जोड़ना, युग्मित इन्फ़रेंस और दावा करने से विरत रहने का नियम शामिल हैं।
| किसकी तुलना की जाती है | अंतर |
|---|---|
| सबसे कठिन कार्य-समूहों में संरचना-आधारित निरूपण बनाम केवल फ़ॉर्मूला इनपुट | 17.3 अंक |
एक ही प्रश्न रखने से कार्य के शब्दांकन को संभावित कारण नहीं माना जा सकता। जवाबों को मास्क करने से मॉडल तैयार मान डाल नहीं सकता।
निष्कर्ष: निरूपणों की तुलना तभी सार्थक है जब प्रश्न और संदर्भ उत्तर एक जैसे हों। वरना अंतर संरचना के उपयोग के बजाय कार्य के पाठ की गुणवत्ता दिखाएगा।
GraphSpace और साधारण ग्राफ़ के बीच कितना अंतर है
GraphSpace, साधारण आवर्त सारणी ग्राफ़ से 19.3 अंक बेहतर प्रदर्शन करता है। यह अंतर दो अलग-अलग प्रभावों से बनता है।
| स्थिति | अंतर |
|---|---|
| साधारण निरूपण में जवाब के लिए ज़रूरी सारी जानकारी मौजूद है | 1.96 अंक |
| साधारण निरूपण में ये फ़ील्ड पूरी तरह अनुपस्थित हैं | 46.7 अंक |
जब जवाब देने के लिए आधारभूत निरूपण पर्याप्त होता है, तो इसका लाभ लगभग गायब हो जाता है। जब उसमें ज़रूरी फ़ील्ड नहीं होते, तो अंतर बड़ा हो जाता है। लेखक बताते हैं कि तुलना का मुख्य नतीजा आधारभूत निरूपण में डेटा की कमी दिखाता है, न कि साक्ष्य को दर्शाने के तरीके का असर।
व्यावहारिक कसौटी: किसी एक निरूपण को बेहतर बताने से पहले जाँचें कि उसमें कौन-से फ़ील्ड मौजूद हैं। वरना माप डेटा की पूर्णता का होगा, विधि का नहीं।
शॉर्टकट रणनीतियाँ और बेंचमार्क का पुनर्निर्माण
जाँच से कार्यों के सेट की एक कमज़ोरी सामने आई। एक नियम जो संबंध को छोड़कर सूची को सीधे पढ़ता है, कठिन बनाए गए सात कार्य-समूहों में से चार का जवाब दे देता है। मॉडल संबंध को समझने के बजाय उससे बच निकल सकता है।
बेंचमार्क को दोबारा तैयार किया गया। ऐसी ग्यारह शॉर्टकट रणनीतियाँ अब लगभग संयोग के बराबर नतीजे देती हैं।
निष्कर्ष: तर्क क्षमता का मूल्यांकन करने के लिए कार्यों के सेट को शॉर्टकट के रास्तों पर जाँचने के बाद ही इस्तेमाल किया जा सकता है। अगर कोई सरल नियम कुछ कार्य-समूहों को हल कर देता है, तो माप तर्क क्षमता का नहीं है।
जवाब में लिंक और संबंध पर निर्भरता
फ़्रीज़ किया गया मॉडल लिंक का हवाला देता है, लेकिन लिंक को दूसरी जगह भेजने पर भी 95.6% युग्मित मामलों में वही जवाब देता है। मॉडल संबंध को दोहराता है, उसका इस्तेमाल नहीं करता।
| स्थिति | समान जवाब वाले युग्मित मामलों का अनुपात |
|---|---|
| फ़्रीज़ किया गया मॉडल, लिंक को दूसरी जगह भेजा जाता है | 95.6% |
| मिलान के साथ प्रशिक्षण के बाद, लिंक को दूसरी जगह भेजा जाता है | 99.8% |
| लिंक हटाया जाता है | 23.4% |
| सबसे अच्छी शॉर्टकट रणनीति | 27.0% |
मिलान के साथ प्रशिक्षण के बाद यह आँकड़ा 99.8% तक पहुँच जाता है। लिंक हटाने पर यह घटकर 23.4% रह जाता है, जो सबसे अच्छी शॉर्टकट रणनीति के 27.0% से कम है। लेखक निष्कर्ष निकालते हैं कि प्रशिक्षण के दोनों चरण—संबंध का इस्तेमाल करना और लिंक पर निर्भर रहना—सीखे जा सकते हैं।
कसौटी: लिंक का हवाला देना, उसका इस्तेमाल करने के बराबर नहीं है। यह जाँचना चाहिए कि लिंक को दूसरी जगह भेजने और उसे हटाने पर मॉडल कैसा व्यवहार करता है।
उपकरणों के मूल्यांकन के लिए इसका क्या मतलब है
- जाँचें कि क्या इनपुट में पूछे गए प्रश्न का जवाब पहले से मौजूद है।
- केवल हवाला देने के बजाय लिंक को दूसरी जगह भेजने और हटाने पर नतीजे देखें।
- नियंत्रण का विवरण माँगें: एक ही प्रश्न, संदर्भ उत्तर और कई निरूपण।
- पता करें कि शॉर्टकट रणनीतियों की जाँच के बाद कार्यों के सेट को अपडेट किया गया है या नहीं।
- बताए गए अंतर का मूल्यांकन डेटा की बनावट के साथ करें, न कि अकेले एक संख्या के रूप में।
चयन की कसौटी: नतीजा तभी भरोसेमंद है जब उसे संकेत में ज़रूरी फ़ील्ड की मौजूदगी या किसी सरल शॉर्टकट नियम से समझाया न जा सके।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026
मेडिकल LLMs दिशानिर्देशों में संशोधन के बारे में जान लेते हैं, लेकिन अक्सर पुराने नियमों के अनुसार जवाब देते हैं
1709 नैदानिक दिशानिर्देशों में हुए बदलावों पर ChronoEvo के अध्ययन से पता चलता है: मुख्य मॉडल में 90,8% उत्तरों ने नए बदलाव को दर्ज किया, लेकिन केवल 58,5% ने उसे पूरी तरह लागू किया; 32,3 प्रतिशत अंकों का यह अंतर 14 मॉडलों में बना रहा। अपडेट को अधिक प्रमुखता देने से भी नए नियमों को नैदानिक दिशानिर्देश में पूरी तरह शामिल करने में कोई महत्वपूर्ण बढ़ोतरी नहीं हुई।
4 नवम्बर 2026