वितरित ऊर्जा ऑपरेटरों के लिए एक चुनौती क्यों है
सक्रिय वितरण नेटवर्क अब उस क्लासिक 'पाइप' से कम मिलते-जुलते हैं जिसके माध्यम से बिजली एक दिशा में बहती है। सौर पैनलों, स्टोरेज सिस्टम, चार्जिंग स्टेशनों के बड़े पैमाने पर कनेक्शन और सक्रिय उपभोक्ताओं के उभरने के कारण, जो एक साथ ऊर्जा खरीदते और बेचते हैं, ऐसे नेटवर्क का प्रबंधन कई परिदृश्यों और परस्पर विरोधी लक्ष्यों वाले कार्य में बदल जाता है। एक ही समाधान को विश्वसनीयता, अर्थव्यवस्था, उपकरण की सीमाओं और बाजार संकेतों को ध्यान में रखना होता है — वह भी लगभग वास्तविक समय में।
ऐसी समस्याओं को हल करने के लिए, इंजीनियरों और शोधकर्ताओं ने हाल के वर्षों में कई अत्यधिक विशिष्ट मॉडल बनाए हैं: कुछ लोड की भविष्यवाणी करते हैं, अन्य पावर फ्लो को अनुकूलित करते हैं, और कुछ नेटवर्क की स्थिति का आकलन करते हैं। अलग-अलग, ऐसे मॉडल अच्छी तरह से काम करते हैं। लेकिन जब ऑपरेटर के सामने कोई नया जटिल कार्य आता है, तो उसे मैन्युअल रूप से सही एल्गोरिदम चुनने, उनके इंटरफेस को समझने, उनके बीच डेटा स्थानांतरित करने और परिणामों की व्याख्या करने की आवश्यकता होती है। इसके लिए उच्च विशेषज्ञता और भारी मात्रा में मैन्युअल काम की आवश्यकता होती है। व्यावहारिक रूप से हर नया परिदृश्य एक अलग एकीकरण परियोजना बन जाता है।
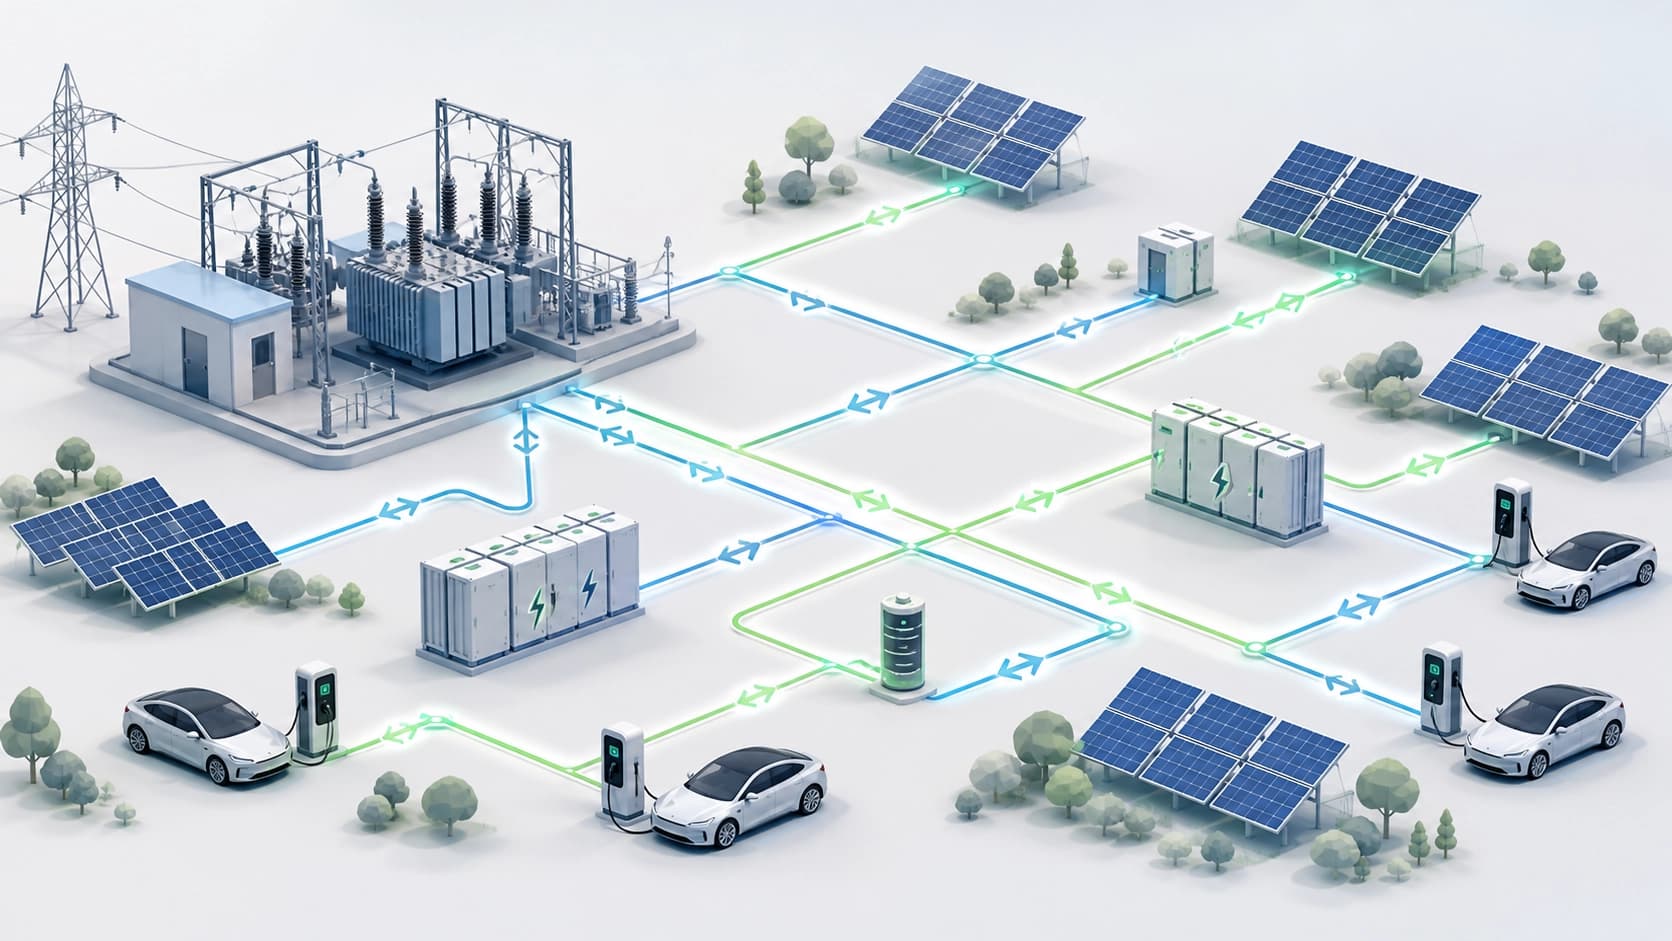
यह एक विरोधाभास पैदा करता है: विशेष AI मॉडल अधिक से अधिक होते जा रहे हैं, लेकिन ऑपरेटर के लिए उनका सामूहिक लाभ उतनी तेजी से नहीं बढ़ रहा है, क्योंकि ऑर्केस्ट्रेशन पर बहुत अधिक समय खर्च होता है। एक ऐसे उपकरण की आवश्यकता है जो इस काम का नियमित हिस्सा अपने ऊपर ले ले: मानव अनुरोध को समझे, उसे उप-कार्यों में विभाजित करे, और सही क्रम में आवश्यक मॉडलों को स्वयं कॉल करे।
LLM-समन्वयक जटिल अनुरोध को एक कार्य प्रवाह में बदल देता है
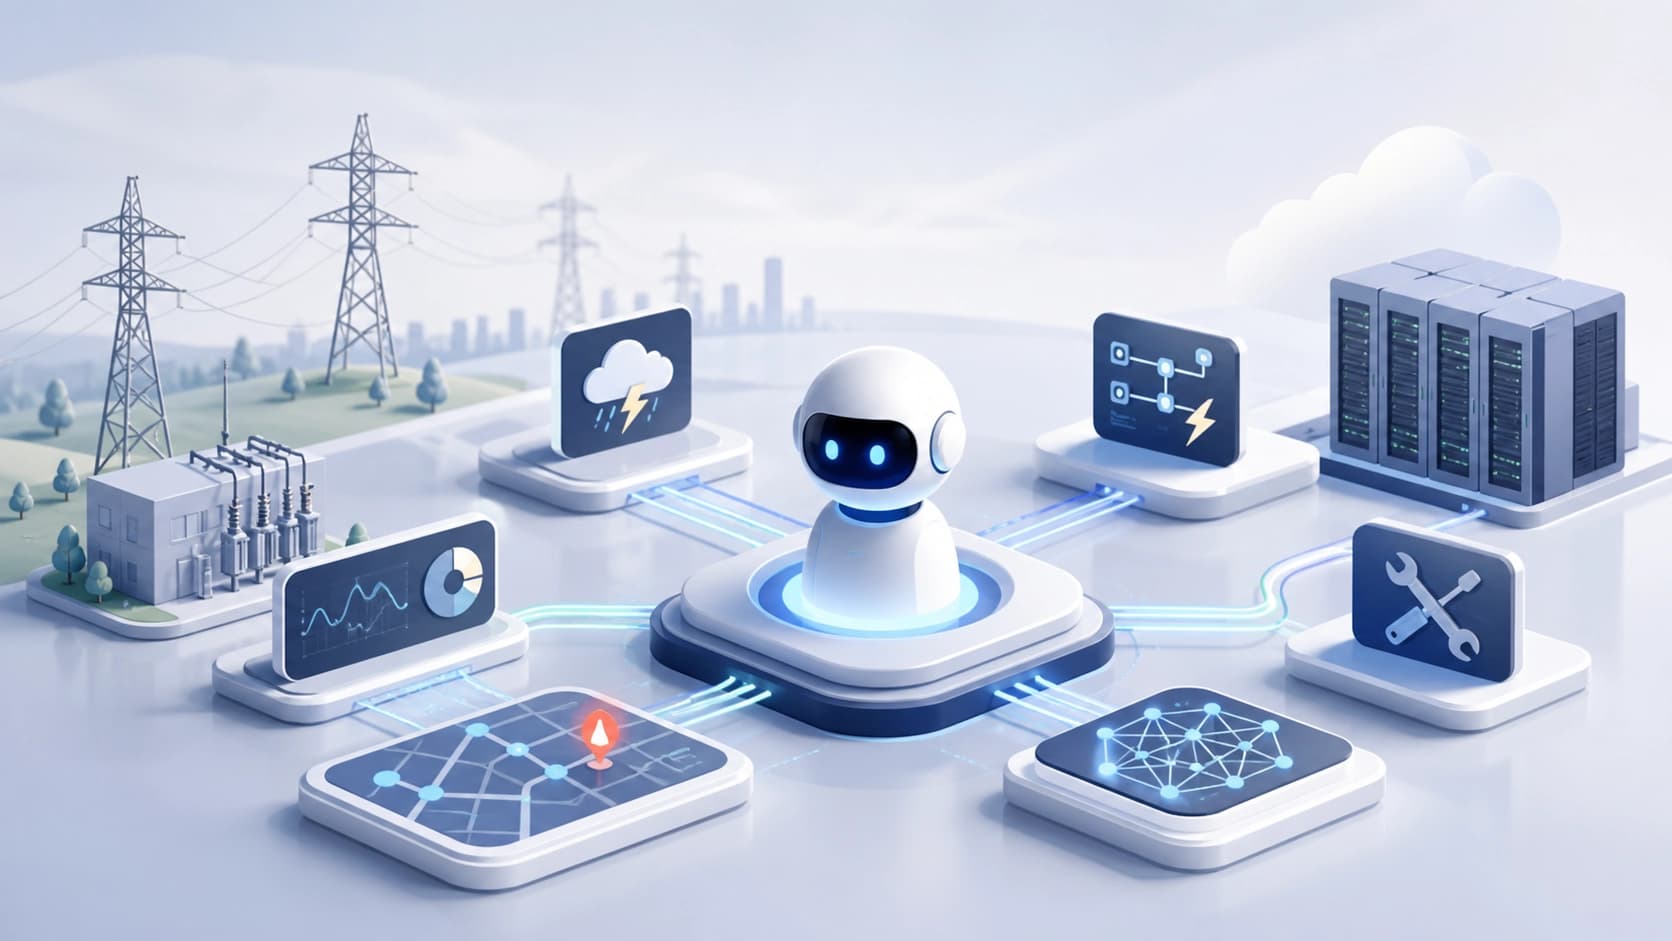
Xu Yang के नेतृत्व में शोधकर्ताओं के एक समूह ने एक दृष्टिकोण प्रस्तावित किया जहां एक बड़ा भाषा मॉडल डिस्पैचर की भूमिका निभाता है। इस विकास को ADN-Agent नाम दिया गया है। विचार यह है कि उपयोगकर्ता सिस्टम के साथ सामान्य भाषा में संवाद करता है, और अंदर का भाषा मॉडल डोमेन मॉडलों के एक सेट का समन्वय करता है — वही संकीर्ण विशेषज्ञ जो पहले से ही ऊर्जा क्षेत्र में मौजूद हैं।
व्यवहार में यह इस तरह दिखता है: ऑपरेटर एक अनुरोध लिखता है, उदाहरण के लिए, 'इस मौसम पूर्वानुमान के साथ फीडर के आउटेज के परिणामों का आकलन करें और इष्टतम स्विचिंग का सुझाव दें'। पूर्वानुमान, स्थिर-अवस्था गणना और अनुकूलन मॉडल को मैन्युअल रूप से चलाने की आवश्यकता नहीं है। ADN-Agent स्वयं इरादे को पहचानता है, कार्य को चरणों में विभाजित करता है, और यह निर्धारित करता है कि काम में कौन से विशेष मॉडल शामिल किए जाएं। मॉडलों के अनुकूली चयन के माध्यम से, सिस्टम विभिन्न प्रकार के प्रश्नों के अनुकूल हो सकता है और व्यक्ति को प्रत्येक मॉडल के कार्यान्वयन विवरण जानने की आवश्यकता नहीं होती है।
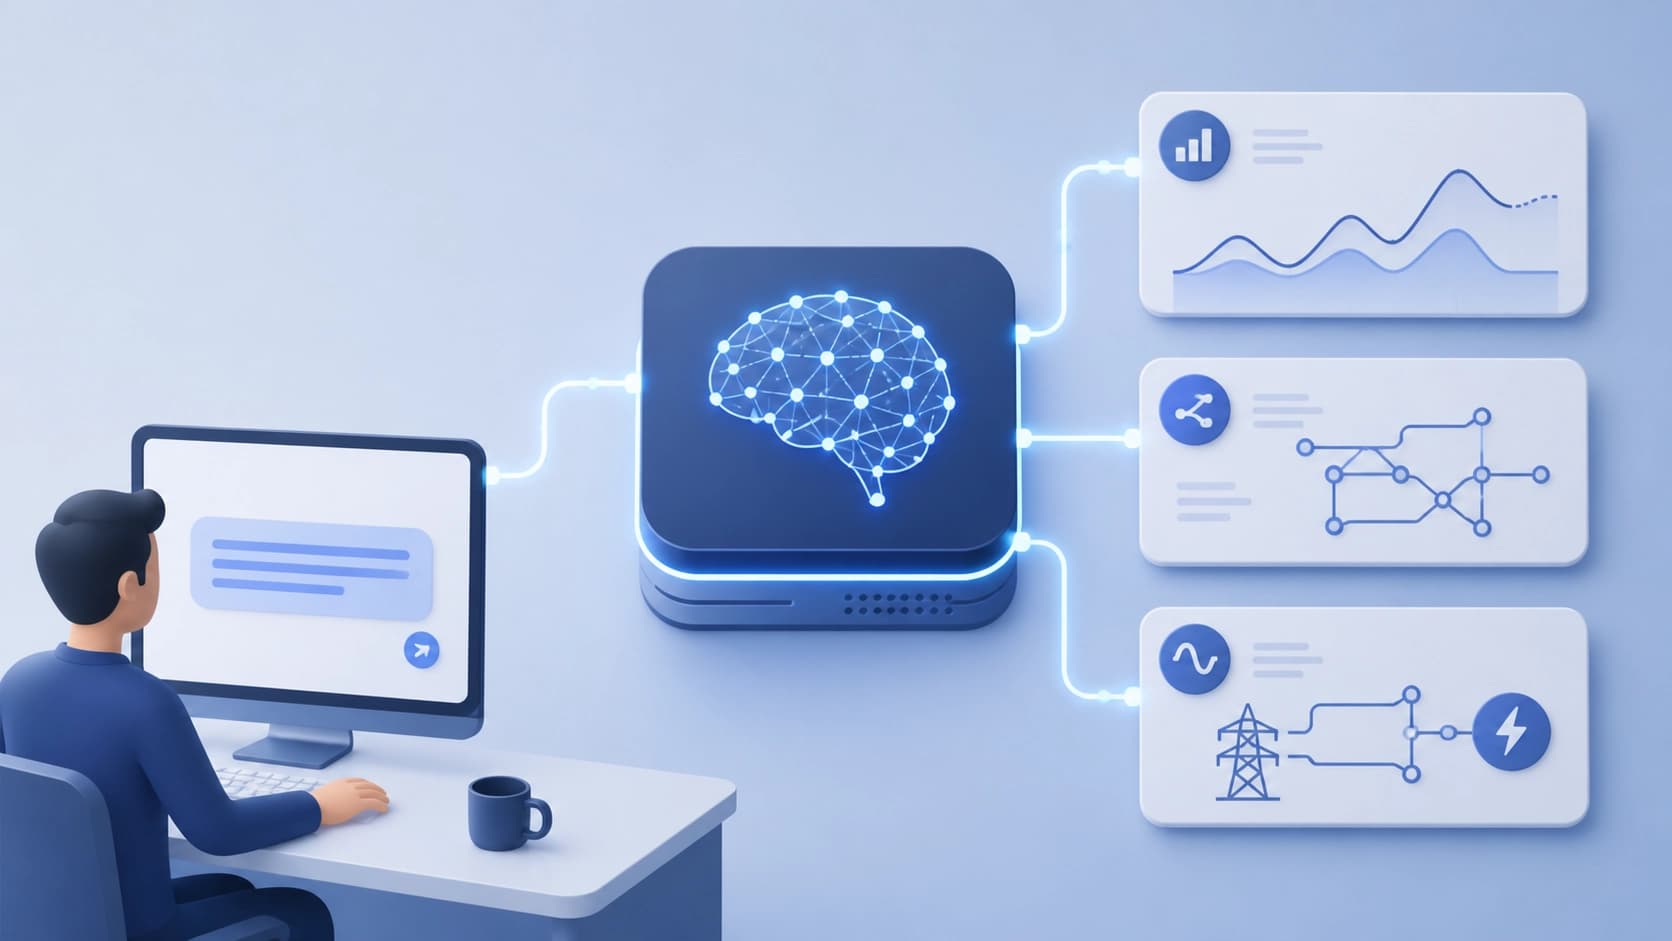
यह महत्वपूर्ण है कि LLM स्वयं ऊर्जा की गणना करने या समीकरणों को हल करने का प्रयास नहीं करता है। यह एक मौलिक बिंदु है: भाषा मॉडल संदर्भ को समझने और योजना बनाने में अच्छे हैं, लेकिन संख्यात्मक गणनाओं में नहीं। इसलिए, ADN-Agent गणनाओं को सिद्ध डोमेन मॉडलों को सौंपता है, और अपने लिए 'समन्वयक' का काम रखता है — कार्यों का विघटन, उपकरणों का चयन, और उत्तर को मानव-समझने योग्य रूप में इकट्ठा करना।
मॉडलों की 'विविधता' के लिए एकीकृत इंटरफ़ेस
ऐसी प्रणालियों को बनाने में मुख्य समस्याओं में से एक डोमेन मॉडलों की विषमता है। वे विभिन्न प्रोग्रामिंग भाषाओं में लिखे गए हैं, विभिन्न डेटा प्रारूपों का उपयोग करते हैं, और इनपुट पर विभिन्न संरचनाओं की अपेक्षा करते हैं। ऐसे 'चिड़ियाघर' को केवल भाषा मॉडल को 'खिलाना' संभव नहीं है। इसलिए, वास्तुकला के हिस्से के रूप में, लेखकों ने एक नया इंटरैक्शन तंत्र प्रस्तावित किया जो सभी मॉडलों को एक एकीकृत और लचीला इंटरफ़ेस देता है। इसके लिए धन्यवाद, समन्वयक एक साधारण स्क्रिप्ट और एक भारी अनुकूलक दोनों के साथ समान रूप से संवाद कर सकता है, बिना उनकी आंतरिक संरचना में जाने के।
ऐसी एकीकृत परत केवल एक तकनीकी विवरण नहीं है, बल्कि स्केलिंग के लिए एक आवश्यक शर्त है। यदि कल एक नया डोमेन मॉडल सामने आता है, तो उसे एक बार सामान्य बस से जोड़ना पर्याप्त है, और यह तुरंत सभी उपयोगकर्ताओं के लिए मानक भाषा अनुरोध के माध्यम से उपलब्ध हो जाता है।
सिस्टम कैसे समझदार बनती है: छोटे भाषा मॉडल का फाइन-ट्यूनिंग
LLM के साथ समन्वय केवल आधी कहानी है। एक जटिल अनुरोध के भीतर कुछ उप-कार्यों के लिए संख्यात्मक गणना की तुलना में भाषा प्रसंस्करण की अधिक आवश्यकता होती है। उदाहरण के लिए, मुक्त पाठ से किसी वस्तु के मापदंडों को निकालना, उपकरण के नामों का मिलान करना, या परिणाम के लिए स्पष्टीकरण तैयार करना आवश्यक है। ऐसे भाषा-गहन कार्यों के लिए, शोधकर्ताओं ने एक अलग तकनीक लागू की: उन्होंने सिस्टम में छोटे भाषा मॉडल एम्बेड किए जो विशिष्ट कार्यों के लिए एक स्वचालित पाइपलाइन द्वारा फाइन-ट्यून किए जाते हैं।
यह क्यों आवश्यक है जब एक बड़ा भाषा मॉडल पहले से मौजूद है? क्योंकि छोटे मॉडल को वास्तविक समय में जल्दी और सस्ते में चलाया जा सकता है, और ऊर्जा क्षेत्र की बारीकियों के लिए उनका फाइन-ट्यूनिंग समग्र रूप से सिस्टम की सटीकता को बढ़ाता है। इसके अलावा, प्रशिक्षण पाइपलाइन स्वचालित है, यानी हर कदम पर उदाहरणों के मैन्युअल संग्रह की आवश्यकता नहीं होती है — सिस्टम काफी हद तक खुद डेटा तैयार करता है और सहायकों को सिखाता है। परिणाम एक बहु-स्तरीय वास्तुकला है: बड़ा LLM रणनीतिक रूप से 'सोचता है', और छोटे फाइन-ट्यून किए गए मॉडल स्थानीय भाषा संचालन करते हैं, मुख्य समन्वयक पर बोझ नहीं डालते।
प्रयोग: एकल LLM की तुलना में एन्सेम्बल बेहतर प्रदर्शन करता है
लेखकों ने खुद को विचार का वर्णन करने तक सीमित नहीं रखा। उन्होंने विस्तृत तुलना और एब्लेशन प्रयोग किए, जिसमें उन्होंने प्रत्येक घटक के योगदान की जांच की — रूटिंग तंत्र से लेकर छोटे मॉडल के फाइन-ट्यूनिंग तक। परिणामों से पता चला कि ADN-Agent दृष्टिकोण ऊर्जा कार्यों में बड़े भाषा मॉडल के उपयोग के मौजूदा प्रतिमानों से बेहतर है। यह लाभ विशेष रूप से बहु-परिदृश्य और जटिल अनुरोधों पर ध्यान देने योग्य है, जहां एक भाषा मॉडल में या तो सटीकता की कमी होती है या बाहरी सॉल्वरों तक पहुंचने की क्षमता की कमी होती है।
यह लेख, 'One Request, Multiple Experts: LLM Orchestrates Domain Specific Models via Adaptive Task Routing', arXiv पर संख्या 2511.12484 के तहत उपलब्ध है और इसे ग्रीष्म 2026 में CSEE Journal of Power and Energy Systems पत्रिका में प्रकाशन के लिए स्वीकार किया गया था। यह एक संकेत है कि काम ने गंभीर विशेषज्ञ समीक्षा पारित की है, न कि केवल एक प्रीप्रिंट बनकर रह गया है। वह दिशा जिसमें एक भाषा मॉडल एक स्वायत्त 'सर्वज्ञ' नहीं बल्कि विशेष एन्सेम्बल का एक लचीला समन्वयक बन जाता है, कई औद्योगिक क्षेत्रों के लिए आशाजनक दिखती है — और ऊर्जा यहां केवल शुरुआती संकेतों में से एक है।