परिणाम-आधारित इनाम — और उसके भीतर छिपा अंधा धब्बा
GUI-एजेंट पर शोध में ज़ोर साफ़ तौर पर बदल गया है: अब ज़्यादा काम परिणाम-आधारित इनाम मॉडलिंग (outcome reward modeling) पर हो रहा है। तर्क सीधा है — एजेंट को उसके ट्रैजेक्टरी के उस स्थिति तक पहुँचने के आधार पर अंक मिलता है जिसकी उपयोगकर्ता के निर्देश में अपेक्षा थी। एक क्रिया है, एक स्क्रीन है, एक नतीजा है, एक मूल्यांकन है।
लेकिन असली पेच यहीं छिपा है। अगर एजेंट को "नतीजे के लिए" इनाम मिलता है, तो किसी को यह तय करना होगा कि आख़िर नतीजा किसे माना जाए। आम ढाँचे में यह क़दम या तो छोड़ दिया जाता है — किसी सामान्य वाक्य से बदलकर — या फिर मॉडल के भरोसे छोड़ दिया जाता है: वह जाँच के दौरान "सोच-विचार" करता है, बिना किसी स्पष्ट रूप से तय मानदंड के। दोनों ही तब तक काम करते दिखते हैं, जब तक एक ही वेरिफ़ायर से दर्जनों अलग-अलग कार्यों का मूल्यांकन न करना पड़े।
सामान्यीकृत रूब्रिक की तीन ठेठ ग़लतियाँ
arXiv:2608.24174 «Task-Adaptive Rubrics for GUI Reward Modeling» (Tao Xiong और सह-लेखक) के लेखक बताते हैं कि सार्वभौमिक टेम्पलेट या मॉडल के अंतर्निहित तर्क पर निर्भरता कहाँ ले जाती है। समस्याएँ पूर्वानुमेय हैं:
- कार्यों के बीच जाँच का स्थानांतरण। किसी एक परिदृश्य के लिए कभी निकाला गया मानदंड यंत्रवत् रूप से किसी दूसरे पर लागू कर दिया जाता है, जहाँ उसका कोई अर्थ ही नहीं बनता।
- प्रतिबंधों का खो जाना। मौजूदा निर्देश की ठोस शर्तें — ज़रूरी मान, विशिष्ट फ़ील्ड, तय क़दम — अनदेखी रह जाती हैं, क्योंकि सामान्य रूब्रिक उनमें फ़र्क़ नहीं कर पाती।
- अत्यधिक कड़ाई। वेरिफ़ायर वह माँगने लगता है जो उपयोगकर्ता ने कभी नहीं माँगा, और सही ढंग से पूरा किया गया कार्य भी ख़ारिज कर देता है।
तीनों की जड़ एक ही है: रूब्रिक कार्य से अलग रहती है। वह निर्देश से निकाली नहीं जाती, बल्कि बाहर से उस पर थोप दी जाती है।
AdaptRubric कैसे बना है
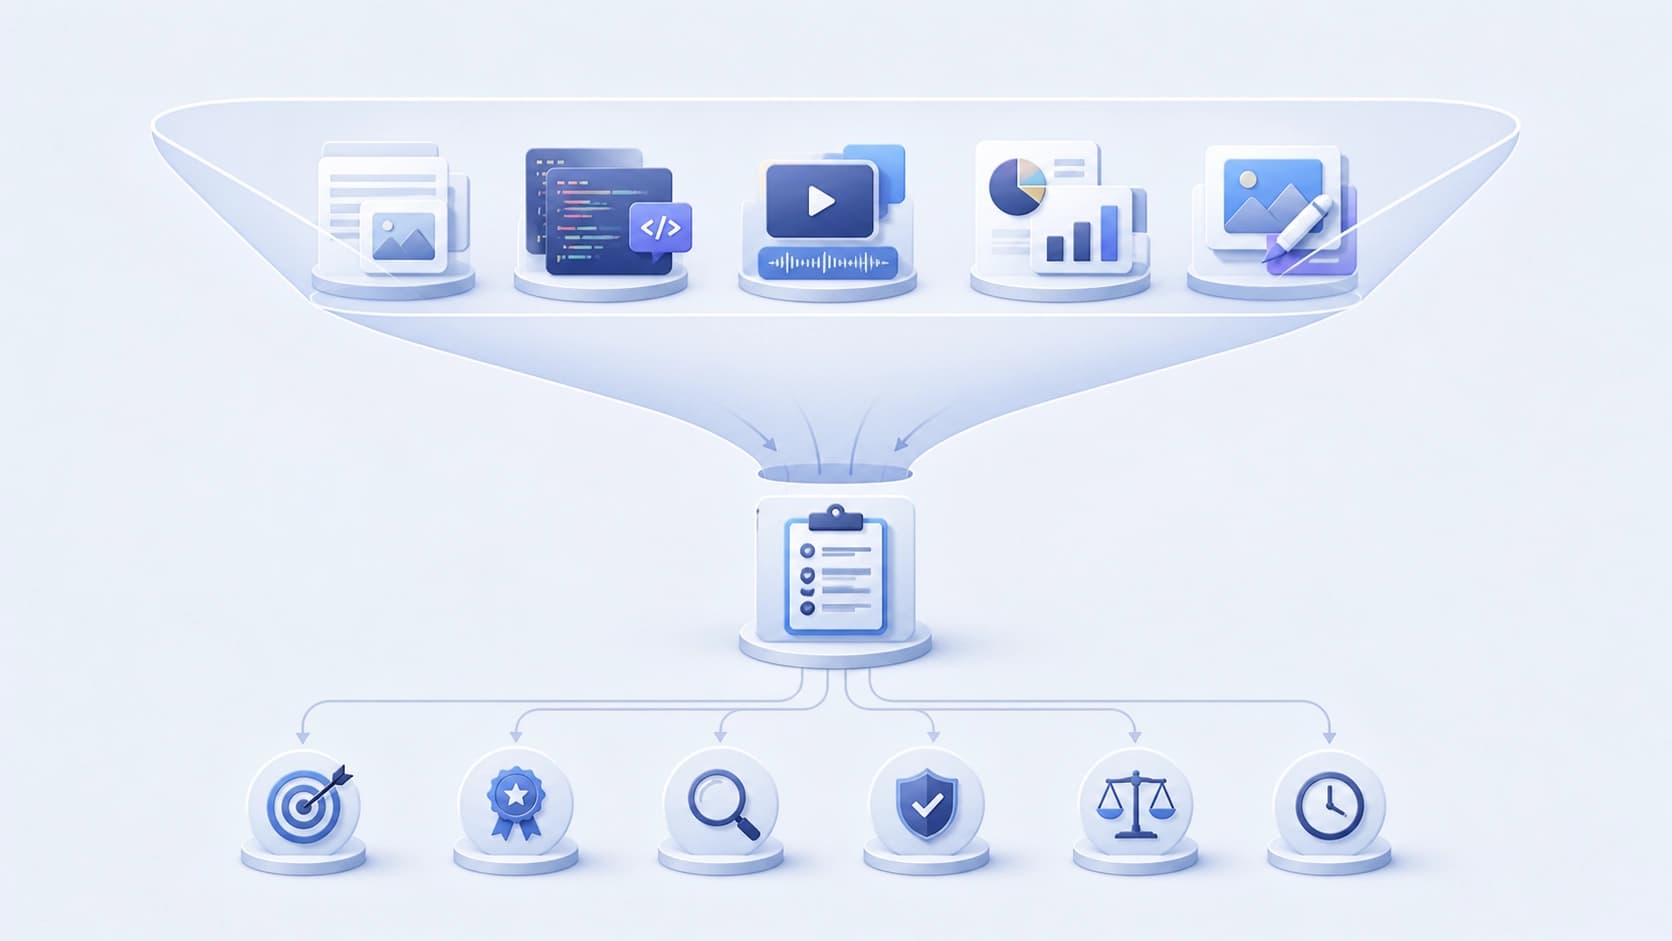
प्रस्तावित फ़्रेमवर्क का नाम ही यही है — "मोटे से बारीक तक" रूब्रिक फ़्रेमवर्क (Coarse-to-Fine Rubrics Framework)। इसका काम तैयार मानदंडों का सेट रखना नहीं, बल्कि हर ठोस निर्देश के लिए उन्हें बनाना है, चौड़े स्तर से संकीर्ण स्तर की ओर बढ़ते हुए। दो चरण दो अलग-अलग समस्याएँ हल करते हैं, और यही इस रचना की मुख्य बारीकी है।
मोटा चरण: पहले यह समझना कि यह किस श्रेणी का कार्य है
पहला क़दम है रूटिंग। निर्देश GUI-कार्यों के किसी ख़ास परिवार से जोड़ा जाता है, और उसी परिवार से दोबारा इस्तेमाल होने वाले मानदंड खींच लिए जाते हैं। मतलब यह है कि मिलती-जुलती क्रियाओं में सफलता के स्थिर लक्षण होते हैं: वे पहले से ज्ञात हैं और हर नए अनुरोध के लिए उन्हें नए सिरे से ईजाद करने की ज़रूरत नहीं। मोटी रूब्रिक एक ढाँचा तय करती है — ढाँचा, न कि अंतिम फ़ैसला।
बारीक चरण: किसी ठोस उदाहरण की बारीकियाँ निकालना
दूसरा क़दम अब अलग-अलग निर्देश के साथ काम करता है। उससे संक्षिप्त संकेत निकाले जाते हैं — ठोस मान, कार्यक्षेत्र, प्रतिबंध, जो इस कार्य में निर्णायक हैं। यहीं रूब्रिक सामान्य होना छोड़कर इस विशेष मामले की अपनी बन जाती है। जो शर्तें उपयोगकर्ता ने नहीं रखीं, वे नहीं आतीं; जो शर्तें उसने रखीं, वे खोती नहींं।
यह विभाजन सार्वभौमिक योजनाओं पर मुख्य आपत्ति हटा देता है: सामान्यीकरण बना रहता है, पर अब वह विशिष्टता की जगह नहीं लेता।
नतीजे: ऑफ़लाइन और रीइन्फ़ोर्समेंट लर्निंग में
AdaptRubric को दो तरीक़ों से परखा गया। पहला — ऑफ़लाइन इनाम मूल्यांकन, यानी यह कि वेरिफ़ायर सफल और असफल ट्रैजेक्टरियों में कितनी अच्छी तरह फ़र्क़ करता है। दूसरा — रीइन्फ़ोर्समेंट लर्निंग के साथ ऑनलाइन ऑप्टिमाइज़ेशन, जहाँ रूब्रिक एजेंट के प्रशिक्षण के लिए संकेत-स्रोत का काम करती हैं।
बताए गए आँकड़े: तुलनीय इमेज बजट पर F1 स्कोर बेसलाइन समाधानों के औसत से 3,6 अंक बढ़ा, और कार्य पूरा करने की सफलता में 4,23 अंक की वृद्धि हुई। लेखक ज़ोर देते हैं कि यह बढ़त लगातार दोहराई जाती है, कुछ अलग-अलग कामयाब रनों पर टिकी नहीं है।
इससे मूल रूप से क्या बदलता है
एजेंट का मूल्यांकन अब "वेरिफ़ायर अच्छा है या बुरा" का सवाल नहीं रह जाता। वह प्रक्रिया का सवाल बन जाता है: इस ठोस कार्य के लिए मानदंड किसने और किस आधार पर तय किए। जब तक मानदंड अंतर्निहित ढंग से निकाले जाते थे, मूल्यांकन की ग़लती को एजेंट की ग़लती से अलग करना लगभग असंभव था — अंतिम रिपोर्ट में दोनों एक जैसी दिखती थीं।
अनुकूली रूब्रिक का तरीक़ा बीच की परत को स्पष्ट बना देता है, यानी उसे मॉडल से अलग जाँचा, चर्चा किया और सुधारा जा सकता है। विकास के लिए यह एक व्यावहारिक सुविधा भी है: अगर रूब्रिक निर्देश के अनुसार बनती है, तो कार्य की शब्दावली बदलने पर उसके मूल्यांकन का तरीक़ा भी अपने आप बदल जाता है, बिना वेरिफ़ायर दोबारा लिखे।
कुछ खुले सवाल भी बने रहते हैं — रूटिंग उन कार्यों में कितनी अच्छी तरह काम करती है जो कई परिवारों के संगम पर हैं, और जान-बूझकर द्विअर्थी निर्देशों पर बारीक चरण कैसा व्यवहार करता है। लेकिन मूल ढाँचा अब भी सार्वभौमिक टेम्पलेट को ज़रा और साफ़-सुथरा बनाने की एक और कोशिश से ज़्यादा उपयोगी लगता है।