
OpenAI promet : sa puce Jalapeño sera plus rapide et plus économique que les solutions de ses concurrents
La société affirme que son processeur d'inférence, développé avec Broadcom, surpasse les accélérateurs Nvidia en efficacité énergétique et en vitesse de réponse lors de tests sur plusieurs modèles d'IA. Le déploiement des puces à petite échelle est prévu d'ici la fin de l'année, mais elle n'envisage pas de remplacer entièrement son parc Nvidia.
OpenAI mise sur la puce Jalapeño : plus rapide, plus économique et bientôt disponible
Lorsqu'il s'agit de déployer de grands modèles de langage, les ingénieurs doivent constamment trouver un compromis : soit le système répond très rapidement, mais peine à supporter le flux de requêtes, soit il est capable d'absorber d'énormes charges, mais au prix de latences notables. Chez OpenAI, on est convaincu d'avoir trouvé une solution qui lève cette contradiction. La puce maison de l'entreprise, baptisée Jalapeño, afficherait selon ses développeurs à la fois une faible latence et un haut débit. Selon Richard Ho, vice-président d'OpenAI en charge du matériel, la nouveauté offrirait « le meilleur des deux mondes ».
Jalapeño n'est pas un processeur universel, mais un circuit intégré spécifique (ASIC), créé en partenariat avec Broadcom. La puce est taillée pour une tâche précise : l'inférence, c'est-à-dire l'exécution directe de modèles entraînés pour accomplir des tâches et faire fonctionner des agents. Annoncée dès juin, elle obtient aujourd'hui ses premiers résultats de tests officiels, que l'entreprise n'hésite pas à qualifier de révolutionnaires.
Ce que montrent les tests de performance
Pour évaluer les capacités de la puce, OpenAI a utilisé sa propre plateforme de benchmarks, InferenceX. Les meilleurs résultats enregistrés sur les superpuces Nvidia GB200 et GB300 servaient de référence pour la comparaison. Les tests ont été menés sur trois modèles populaires : GPT-OSS 120B, DeepSeek R1 et Kimi K2.5 1T.
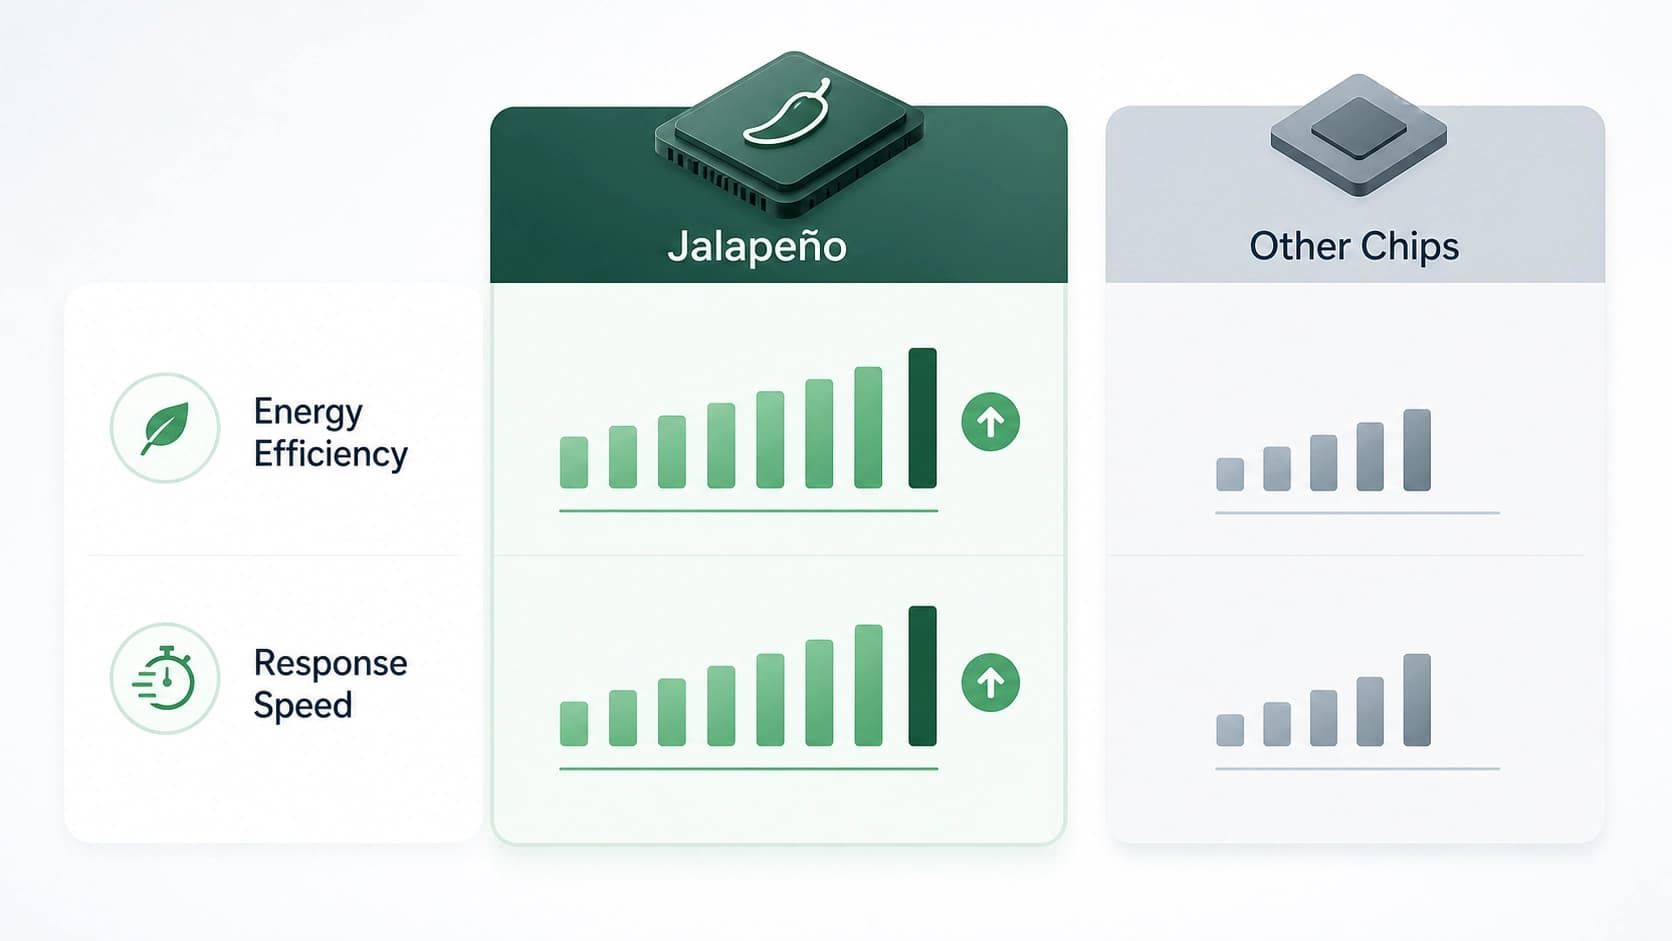
L'entreprise affirme que les résultats sont impressionnants. Selon le modèle, Jalapeño a démontré 1,5 à 1,9 fois plus de calculs par watt que les systèmes concurrents. En clair, cela signifie que pour chaque kilowatt d'énergie consommé, la nouvelle puce accomplit nettement plus de travail utile. C'est un point crucial à une époque où les factures d'électricité des centres de données deviennent l'un des principaux postes de dépenses.
La différence est encore plus marquée en matière de vitesse de réponse. La latence de bout en bout sur les trois modèles testés s'est révélée 1,7 à 3,6 fois plus faible par rapport aux systèmes de référence équipés de puces Nvidia. Concrètement, cela se traduit par des réponses plus rapides des assistants, des actions plus réactives des agents IA et un accès stable aux services même en cas de pics de charge. Plus le modèle traite une requête rapidement, moins l'utilisateur doit regarder l'indicateur de « frappe » de la réponse.
Stratégie : pas un remplacement, mais un complément
Malgré ces chiffres très encourageants, OpenAI n'entend pas renoncer à sa collaboration avec Nvidia. Richard Ho souligne que la stratégie de calcul globale de l'entreprise repose sur un large éventail de partenaires, et que Nvidia reste l'un des acteurs clés. Jalapeño ne remplacera pas le parc de puces existant, mais deviendra plutôt un élément important de la mise à l'échelle de l'infrastructure.
La première génération de la puce devrait être déployée « en volumes limités » d'ici la fin de l'année en cours. La montée en puissance à grande échelle débutera en 2027. L'entreprise ne révèle volontairement pas le nombre exact de puces qu'elle prévoit d'utiliser l'année prochaine. Parallèlement, les travaux sont déjà en cours sur les deuxième et troisième générations de Jalapeño, ce qui témoigne du caractère durable de cette orientation — contrairement à de nombreux projets expérimentaux qui n'atteignent jamais le stade pratique.
Le succès de ce projet pourrait considérablement réduire la dépendance des opérateurs de grands modèles d'IA vis-à-vis d'un nombre limité de fournisseurs de puces. Les ASIC maison permettent d'adapter plus précisément l'architecture aux algorithmes et aux charges de travail spécifiques d'OpenAI, économisant des ressources et accélérant la mise sur le marché de nouveaux produits.
Foire aux questions
Matériaux connexes
Tous matériaux
AURA-Eval : comment vérifier qu’un agent LLM a reconnu le risque et modifié l’étape suivante
Le framework évalue le comportement des agents LLM non pas d’après leur verdict final, mais selon leur réaction au risque aux étapes clés : les trajectoires d’appels aux outils sont interrompues, puis le modèle doit poursuivre son raisonnement et son action, tandis qu’un panel de juges LLM examine la détection du risque, sa nature et la sécurité de l’étape. Sur 1 249 tâches issues de 157 trajectoires R-Judge, les actions dangereuses deviennent plus fréquentes chez 20 modèles en l’absence de voie sûre, et la levée de la supervision avant l’exécution fait basculer 52,3 % des cas initialement sûrs dans la catégorie des cas dangereux.
10 novembre 2026
Mémoire du réservoir de Chern-Simons : dynamique autonome de la connectivité et transfert de densité
L’article explique comment un réservoir conserve l’historique des signaux d’entrée à la fois dans la distribution de densité et dans les degrés de liberté géométriques. La comparaison de quatre mécanismes montre que le courant crée une composante de connectivité distincte, qui modifie la réponse ultérieure de la densité, tandis que la prise en compte de toutes les caractéristiques mesurées apporte un léger gain dans le décodage de l’ordre des impulsions.
10 novembre 2026
La validation des candidats coûte plus cher que leur génération : des leurres contre la recherche de vulnérabilités par les LLM
Cette étude analyse l’asymétrie des coûts de la recherche agentique de défauts : la génération de variantes est peu coûteuse, tandis que leur confirmation au moyen d’une analyse d’accessibilité, de l’exécution et d’un PoC mobilise l’essentiel du budget ; la vérification peut donc devenir une cible de défense à part entière. RedHerring, qui propose des leurres adaptés au dépôt et assortis d’un certificat secret, a réduit de 38,7 à 60,4 % le nombre de véritables vulnérabilités détectées, à coût égal, dans 33 projets OSS-Fuzz ; même après avoir averti l’agent, la baisse restait de 37,2 %.
9 novembre 2026