
Un lapin poursuit un tigre : le test qui a révélé un angle mort
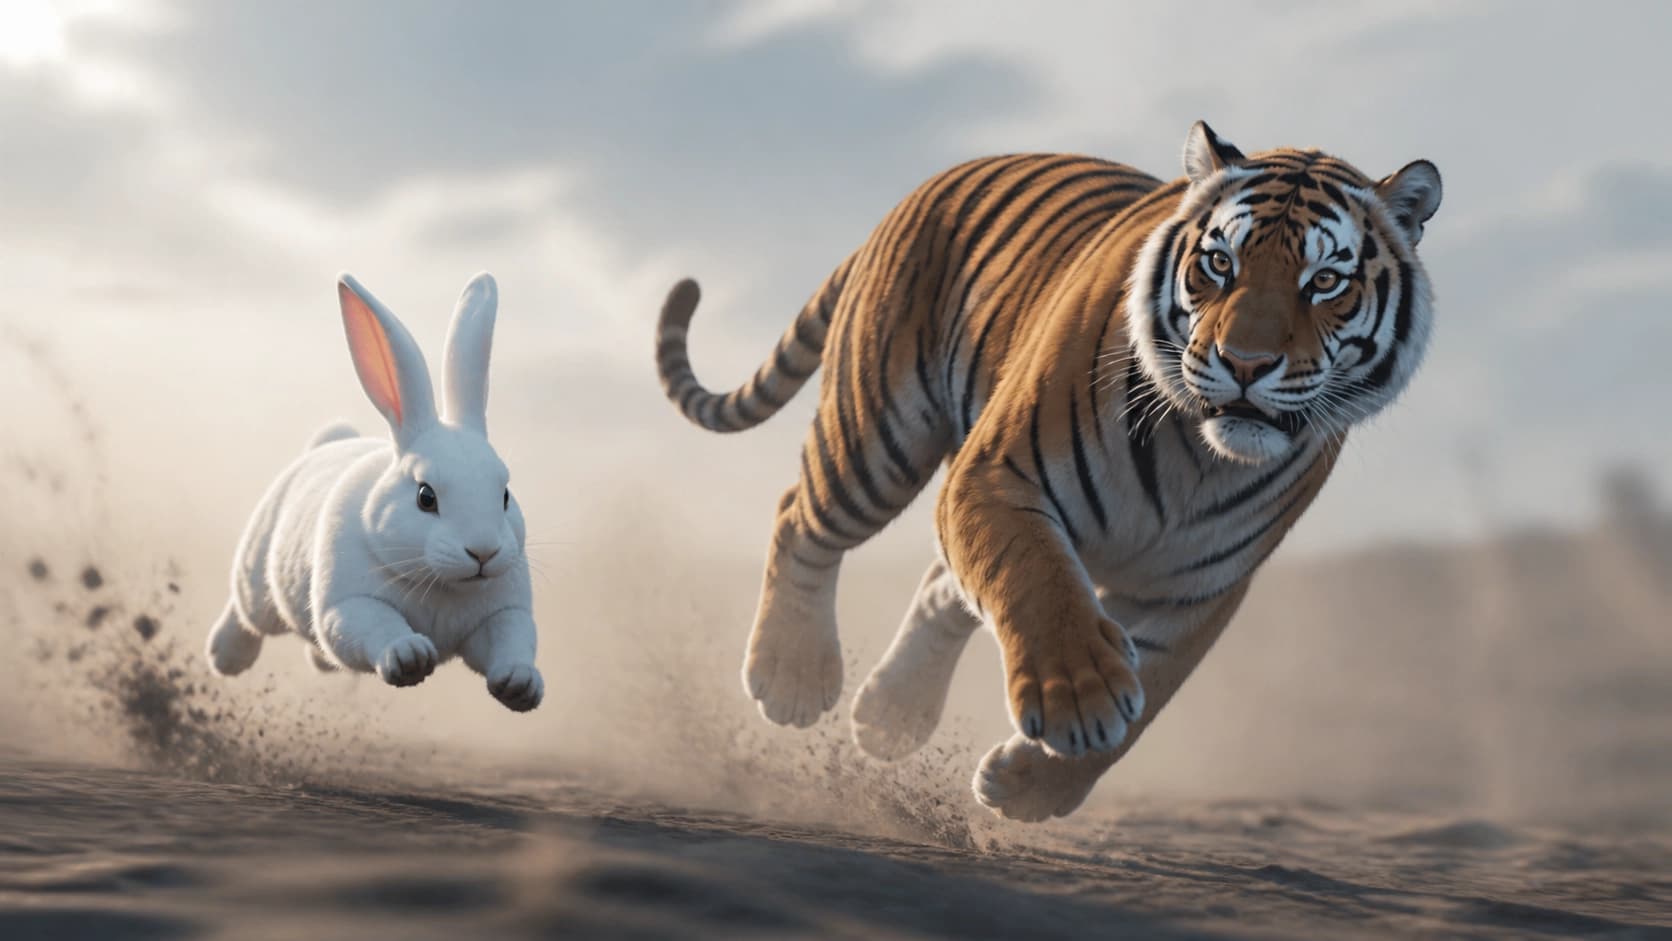
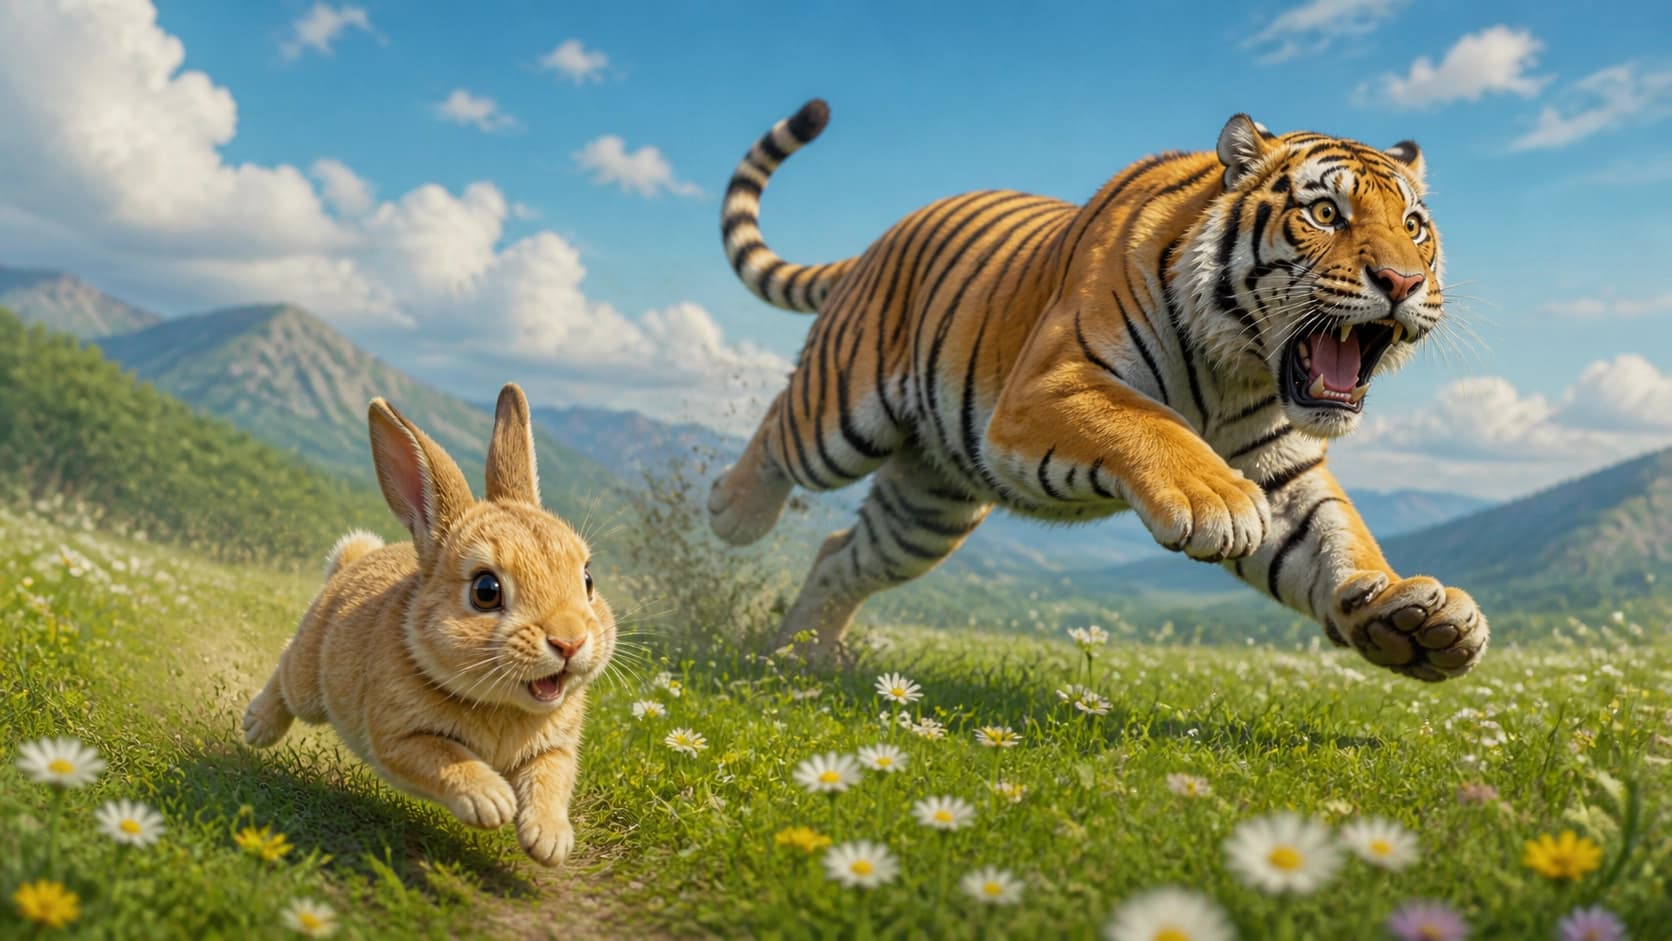
Imaginez la scène : un lapin fonce à travers une prairie, tandis qu'un tigre le précède en fuyant. La composition est soignée, les détails sont dessinés, aucune ambiguïté — visuellement, tout est sans équivoque. Et pourtant, une part considérable des modèles multimodaux ouverts décrit cette scène à l'envers. Non pas parce qu'ils voient mal, mais parce qu'ils ne croient pas ce qu'ils voient.
C'est précisément ce paradoxe qu'analyse l'étude « Seeing vs. Believing: Evaluating the Language Bias of Open-Source MLLMs in Counter-Intuitive Scenes » (arXiv:2601.07737, auteurs Chen Ling, Tongwei Zhang, Hanqian Li et Nai Ding). Les travaux ont été publiés en janvier 2026 et ont depuis été mis à jour à deux reprises — la dernière révision datant d'août. Formellement, il s'agit d'un article de vision par ordinateur, mais ses conclusions sont bien plus larges : elles frappent la logique même de la conception des assistants multimodaux modernes.
Ce qui a été testé exactement
Les modèles multimodaux résolvent depuis longtemps et avec assurance les tâches « grand public » : décrire une photographie, trouver un objet à partir d'une requête textuelle, répondre à une question à partir d'un schéma. Mais ces tests reposent presque toujours sur des scènes qui correspondent aux attentes du quotidien. Un chat sur un rebord de fenêtre, une personne avec un parapluie sous la pluie, une voiture sur la route — le modèle a vu tout cela des millions de fois dans les légendes de jeux de données.
Et que se passe-t-il si le monde visuel va à l'encontre du bon sens ? Pour le découvrir, l'équipe a constitué un benchmark CAIT — 400 scènes synthétiques de haute précision. Chacune représente une action qui contredit l'image habituelle du monde : ce fameux lapin poursuivant un tigre en est un exemple caractéristique. Les images sont synthétiques, donc contrôlées : on peut être certain que l'indice visuel est bien présent et qu'il est sans équivoque.
L'idée clé de la méthodologie réside dans le fait que la bonne réponse ne peut pas être déduite du texte de la question. On ne peut l'obtenir que d'une seule manière — regarder l'image et accepter ce qui y est dessiné.
Humains, modèles fermés et ouverts : l'écart en chiffres
Les résultats se répartissent sur trois niveaux très différents.
- Les humains résolvent la tâche presque parfaitement — une précision d'environ 0,95. Pour nous, il n'y a rien de difficile à voir une scène inhabituelle et à simplement l'enregistrer.
- Les modèles propriétaires — l'étude a impliqué les principales solutions, notamment Claude et Gemini — montrent une compréhension stable : la précision atteint 0,88. Pas parfait, mais le système regarde manifestement l'image au lieu de deviner.
- Les modèles ouverts affinés sur instructions — 14 représentants typiques — s'effondrent au niveau du hasard. Autrement dit, leurs réponses ne sont presque pas corrélées à ce qui est réellement dessiné.
C'est là le sujet principal : l'écart entre le « tigre » des solutions fermées et le « lapin » des solutions ouvertes s'est révélé non pas cosmétique, mais fondamental. Il ne s'agit pas du fait que les modèles ouverts s'en sortent un peu moins bien sur une tâche complexe — dans les scènes contre-intuitives, ils cessent d'être multimodaux en un sens tant soit peu significatif.
Le principal coupable — le prior linguistique
L'analyse des erreurs révèle la mécanique de la défaillance. Le problème n'est pas que le modèle n'a pas distingué le lapin. Le problème est qu'il a préféré ne pas croire ses yeux.
Lorsque le signal visuel contredit la statistique du texte, un puissant prior linguistique entre en jeu : le modèle substitue automatiquement à l'observation anormale la description textuelle la plus fréquente. Le tigre poursuit le lapin — cette expression apparaît constamment dans les corpus. L'ordre inverse — presque jamais. Et au carrefour entre « a vu » et « s'attendait à », le système choisit le second.
En substance, l'entrée visuelle ne sert à un tel modèle que d'indice pour savoir quelle phrase extraire de sa mémoire. Si l'image confirme le schéma — tout va bien. Si elle le contredit — le schéma l'emporte. D'où cette précision au niveau d'un tirage au sort : le modèle répond par inertie du langage, et non selon le contenu de l'image.
Le piège du raisonnement : « repenser » la scène
Une proposition logique consiste à ajouter au modèle une chaîne de raisonnement (Chain-of-Thought). Qu'il énonce les étapes, se vérifie, parvienne à une conclusion. Cela fonctionne en partie : la précision augmente effectivement.
Mais l'amélioration a un prix, et ce prix est double.
Premièrement, la réponse devient nettement plus lente — un raisonnement développé exige du temps et des calculs. Deuxièmement — et c'est plus intéressant — un nouveau mode de défaillance apparaît. Le modèle se met littéralement à repenser ce qu'il a vu. Il semble enregistrer la scène, puis la rejette : cela n'arrive pas, cela viole les lois physiques du monde réel, donc je me suis probablement trompé. En conséquence, le système refuse d'accepter le contenu visuel factuel précisément parce qu'il est impossible.
Il en résulte une ironie singulière : un outil censé rendre la conclusion plus solide se transforme parfois en machine à refouler les faits dérangeants.
Ce qui aide : le fine-tuning et le prompting structuré
La bonne nouvelle, c'est que le problème n'est pas fatal. Les auteurs décrivent deux approches qui atténuent nettement la dépendance aux priors linguistiques.
- Le fine-tuning ciblé. Un entraînement complémentaire sur des données appropriées réduit la tendance à substituer un schéma à l'observation et redonne du poids au canal visuel.
- Le prompting structuré. Si l'on impose au modèle un format de réponse où il doit d'abord enregistrer ce qu'il observe et seulement ensuite interpréter, la précision augmente sans réentraînement.
Dans les deux cas, les modèles ouverts commencent à fonder leur conclusion sur des preuves visuelles réelles, et non sur la statistique du texte. Autrement dit, l'écart avec les solutions fermées est une question d'architecture et d'entraînement, et non une impossibilité fondamentale.
Ce qu'il en découle en pratique
Pour un développeur qui construit un produit sur un modèle multimodal ouvert, les conclusions sont assez terre à terre.
Il convient de garder à l'esprit qu'une réponse assurée n'équivaut pas à ce qui a été vu. Là où la scène correspond aux attentes, le modèle fait preuve de fiabilité ; là où elle s'en écarte, il glisse en silence et sans se faire remarquer une invention plausible. Le plus dangereux, c'est que l'erreur n'a pas l'air d'une erreur : la description est fluide, logique et parfaitement fausse.
Il faut par ailleurs considérer le raisonnement comme un outil aux effets secondaires. Le Chain-of-Thought n'aide pas toujours et pas dans toutes les tâches — parfois il transforme le modèle en sceptique qui rejette sa propre conclusion correcte.
Et enfin, l'essentiel. « Le lapin poursuit le tigre » n'est pas une curiosité, mais un test pur de ce à quoi le modèle fait réellement confiance. Tant que la réponse à cette question ne penche pas en faveur de l'image, on ne peut qualifier le système de multimodal que sous conditions.


