
La réponse finale comme unique métrique — et ce qu'elle dissimule
La plupart des benchmarks pour les modèles de langage sont conçus comme une interro écrite à l'école : il y a une question, il y a une référence, il y a une vérification de correspondance. Calculer une telle métrique est pratique, comparer les modèles l'est aussi. Mais ce schéma comporte un défaut intégré : il évalue le résultat, pas le chemin pour y parvenir.
Imaginez une tâche où il faut relier quatre faits. Le modèle se trompe sur le deuxième, devine par hasard le quatrième — et obtient un point. Ou l'inverse : trois maillons sont parfaitement agencés, mais la réponse finale diffère d'une seule formulation — et il n'y a pas de point. Dans les deux cas, le chiffre final ment sur ce qui s'est réellement passé à l'intérieur. C'est particulièrement douloureux pour les questions à plusieurs étapes : là, ce n'est pas une seule compétence qui est testée, mais leur enchaînement — trouver les informations, les retenir, les relier aux suivantes, ne rien perdre en route.
Le diagnostic « où exactement cela a cassé » n'est pas une chicane académique. C'est de lui que dépend ce qu'il faut réparer : le corpus de données, la stratégie d'entraînement ou la formulation du prompt. La précision finale ne peut pas répondre à cette question par définition.
Qu'est-ce qu'Omanic
C'est précisément cette zone aveugle que comble le travail « Omanic: Towards Step-wise Evaluation of Multi-hop Reasoning in Large Language Models » (arXiv:2603.16654, relève de la section cs.CL, également rattaché à cs.AI et cs.LG, accepté à EMNLP 2026 Findings). L'équipe d'auteurs est large et internationale : Xiaojie Gu, Sherry T. Tong, Aosong Feng, Sophia Simeng Han, Jinghui Lu, Yingjian Chen, Yusuke Iwasawa, Yutaka Matsuo, Chanjun Park, Rex Ying, Irene Li. La première édition a été mise en ligne le 17 mars 2026, puis deux révisions ont suivi — en mai et en août.
Omanic est un benchmark open-domain à quatre étapes de raisonnement. Le mot « open-domain » est ici essentiel : le modèle ne choisit pas une option dans une liste prête et ne fouille pas dans un seul document préparé à l'avance. Les informations doivent être trouvées de manière autonome, et c'est seulement ensuite qu'on en construit une chaîne. Cette approche est plus proche des scénarios réels, où la réponse ne se trouve presque jamais dans un seul paragraphe.
Deux corpus au lieu d'un
À l'intérieur d'Omanic vivent deux ensembles de données différents, et il ne faut pas les confondre.
Le premier — OmanicSynth, 10 296 exemples générés par machine. C'est un matériel d'entraînement : on peut l'utiliser comme supervision, et c'est précisément sur lui que les auteurs ont vérifié si la capacité de raisonner étape par étape se transmettait.
Le second — OmanicBench, 967 exemples qui ont passé une vérification d'experts et sont dotés d'une annotation manuelle. C'est la partie évaluative, et elle est nettement plus petite — ce qui est logique, puisque l'annotation humaine au niveau des étapes coûte cher.
Cette séparation n'est pas une formalité. Elle permet de distinguer « le modèle a été entraîné » de « le modèle sait réellement faire » : le corpus d'entraînement est grand et machine, le corpus de vérification est compact et éprouvé.
Comment est structurée l'annotation par étapes
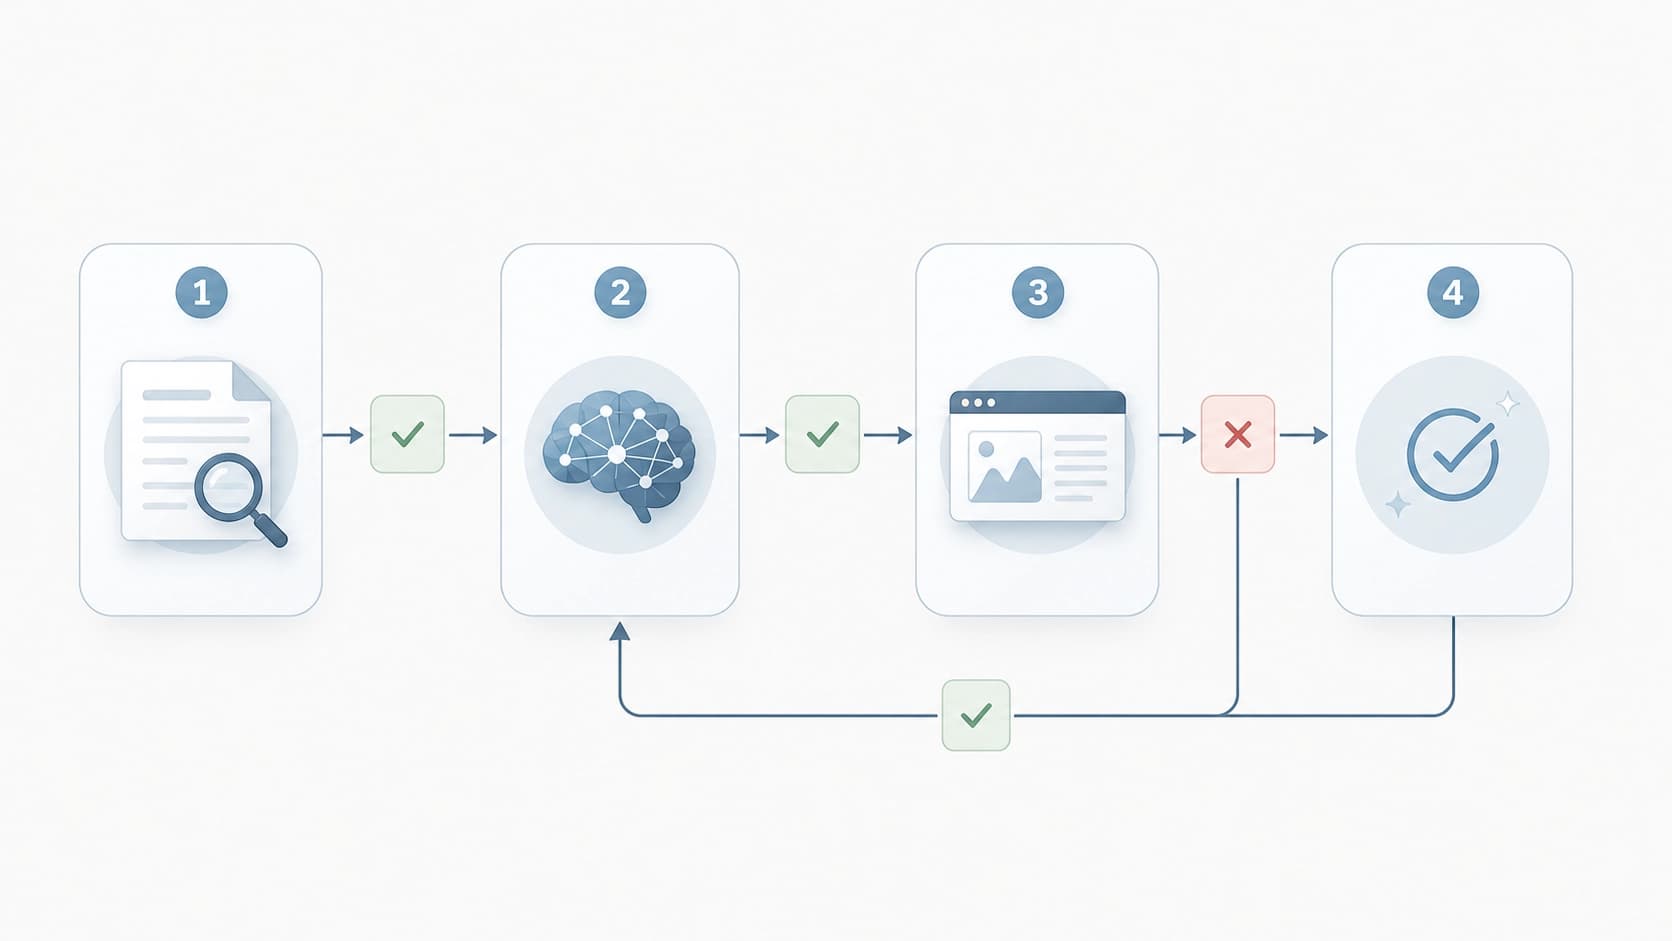
La principale différence d'Omanic avec les ensembles QA habituels réside dans le fait que chaque question est décomposée en ses composantes. Sous-questions à une étape, réponses intermédiaires, topologies de graphe structurées — c'est-à-dire le schéma de la manière dont les faits sont liés les uns aux autres.
Cela transforme l'évaluation d'un point unique en un ensemble de points de contrôle. On peut désormais examiner non seulement « le modèle a répondu correctement ou non », mais aussi « à quelle transition précise il a déraillé ». La structure de graphe est ici importante aussi parce que différents types de liens sont plus ou moins faciles pour les modèles : extraire une propriété d'un objet est une chose, suivre une chaîne de quatre dépendances successives en est une tout autre.
Trois diagnostics visibles uniquement au niveau des étapes
Les expériences avec des modèles fermés et ouverts ont donné trois observations que la métrique finale est simplement incapable de montrer.
Le goulot d'étranglement aux étapes tardives
La première conclusion est appelée par les auteurs later-hop bottleneck. Il s'agit du fait que les principales pertes s'accumulent non pas au début, mais vers la fin de la chaîne. Les première et deuxième transitions sont franchies par les modèles avec une relative assurance, mais c'est à la troisième et à la quatrième qu'ils commencent à s'effondrer.
L'explication vient d'elle-même : plus la chaîne est longue, plus il faut maintenir simultanément en état de fonctionnement d'entités intermédiaires. Aux étapes tardives, le modèle doit opérer non plus sur la question initiale, mais sur les résultats de ses propres déductions précédentes — et toute imprécision s'y multiplie. La conclusion pratique est désagréable pour ceux qui aiment construire de longs pipelines à plusieurs niveaux : l'ajout d'une cinquième et d'une sixième étape peut coûter plus cher qu'il n'y paraît.
Le « plancher » des connaissances factuelles
Le deuxième phénomène — factual knowledge floor, le « plancher » des connaissances factuelles. Une partie des erreurs n'est pas du tout liée à la logique : le modèle ne dispose simplement pas du fait nécessaire et, au lieu de s'arrêter honnêtement, continue à construire un raisonnement sur du vide.
C'est une distinction importante. Quand le modèle se trompe dans la déduction — la question porte sur le raisonnement. Quand il ne connaît pas le fait initial — la question porte sur les données et sur sa capacité à reconnaître son ignorance. Le second se soigne mal : ni le raisonnement étape par étape, ni un prompt plus intelligent n'aideront s'il n'y a tout simplement pas de support sous le premier maillon.
L'erreur qui se propage le long de la chaîne
Le troisième diagnostic — la propagation des erreurs le long de la chaîne. Une imprécision précoce ne reste pas locale : elle est reprise par les étapes suivantes et se transforme en une réponse finale assurée, formulée avec fluidité, mais erronée.
C'est là que se cache un piège pour l'évaluation. Un modèle qui s'est trompé une fois puis a raisonné de manière cohérente, et un modèle qui s'est effondré à toutes les étapes, apparaissent identiques dans la métrique finale — aucun des deux n'a trouvé la bonne réponse. L'analyse par étapes les distingue, et c'est exactement le cas où le diagnostic vaut plus que le score final.
Transfert d'apprentissage : 7,41 points sur six benchmarks
Une question distincte — peut-on utiliser cette annotation non seulement pour mesurer, mais aussi pour entraîner. Les auteurs ont vérifié : le fine-tuning sur OmanicSynth a donné une amélioration sur six benchmarks tiers consacrés au raisonnement et aux mathématiques, avec un gain moyen de 7,41 points.
Un chiffre qu'il faut lire correctement. Ce n'est pas « le modèle est devenu plus intelligent en tout » — c'est « une compétence travaillée sur des chaînes décomposées se transfère à d'autres tâches de type similaire ». Ce qui en soi dit quelque chose sur la nature du benchmark : il ne s'agit pas d'apprendre par cœur des questions concrètes, mais d'entraîner une procédure — comment décomposer une tâche en étapes et maintenir le lien entre elles.
Ce que cela signifie pour la pratique
Quelques conclusions qui découlent de ce qui précède.
Évaluer par étapes, pas par le résultat. Si votre système produit des réponses à plusieurs étapes, une seule métrique finale ne suffit pas — elle moyennerea des défaillances de nature différente en un seul chiffre confus.
Distinguer « je ne sais pas » et « j'ai mal déduit ». Ce sont deux défauts différents avec des modes de traitement différents, mais dans le reporting habituel ils se confondent.
Prudence avec les longues chaînes. Les étapes tardives sont le point le plus vulnérable. Il est parfois plus raisonnable de diviser une tâche en plusieurs sous-tâches indépendantes que de faire courir une seule longue chaîne jusqu'au bout.
La décomposition est aussi un signal d'apprentissage. Le résultat avec transfert sur six ensembles tiers montre que l'annotation par étapes fonctionne non seulement comme une règle de mesure, mais aussi comme un matériel d'entraînement.
Ce qu'Omanic n'est pas
Il est utile de délimiter les frontières. Omanic n'est pas une évaluation universelle de l'intelligence d'un modèle, ni un test qui porte sur tout à la fois. C'est un outil pour une tâche précise : montrer à quel maillon du raisonnement se produit la défaillance dans les questions à plusieurs étapes du domaine ouvert.
Le volume de la partie évaluative — 967 exemples — mérite aussi d'être gardé en tête : l'ensemble est éprouvé, mais pas gigantesque. La partie d'entraînement est d'un ordre de grandeur plus grande et créée par machine, ce qui donne de l'échelle, mais ne remplace pas la vérification manuelle.
Et surtout : le diagnostic en lui-même ne guérit rien. Savoir que le modèle trébuche aux étapes tardives est un point de départ, pas une solution. Ensuite commence le travail habituel : où ajouter des données, où simplifier la chaîne, où apprendre au modèle à s'arrêter et à dire « je ne sais pas cela ».
Les données et le code ont été mis en accès libre par les auteurs ; le travail est disponible via le DOI 10.48550/arXiv.2603.16654.


