Pourquoi le SFT après le RL menace le raisonnement
L’apprentissage par renforcement développe les capacités de raisonnement des grands modèles de langage. Cette approche est devenue efficace pour le post-entraînement des LLM. Le fine-tuning supervisé qui suit adapte le modèle post-RL à de nouveaux domaines de connaissances ou types de comportements. Ce SFT peut sérieusement écraser les capacités acquises.
Approches existantes pour réduire l’oubli :
- rejeu de l’expérience ;
- initialisation spécialisée ;
- optimisation contrainte avec projection du gradient.
Ces méthodes ne permettent soit qu’une préservation limitée des capacités, soit nécessitent des calculs supplémentaires importants. Critère pratique : pour un modèle post-RL, choisir une méthode qui réduit le risque d’écrasement du raisonnement.
Le sous-espace nul comme ressource d’adaptation
Les auteurs montrent que les activations liées au raisonnement sont concentrées dans des sous-espaces de faible dimension. Une capacité importante reste disponible dans le sous-espace nul pour l’adaptation. Les sous-espaces nuls approximatifs peuvent être estimés de manière fiable à partir d’un petit nombre d’exemples.
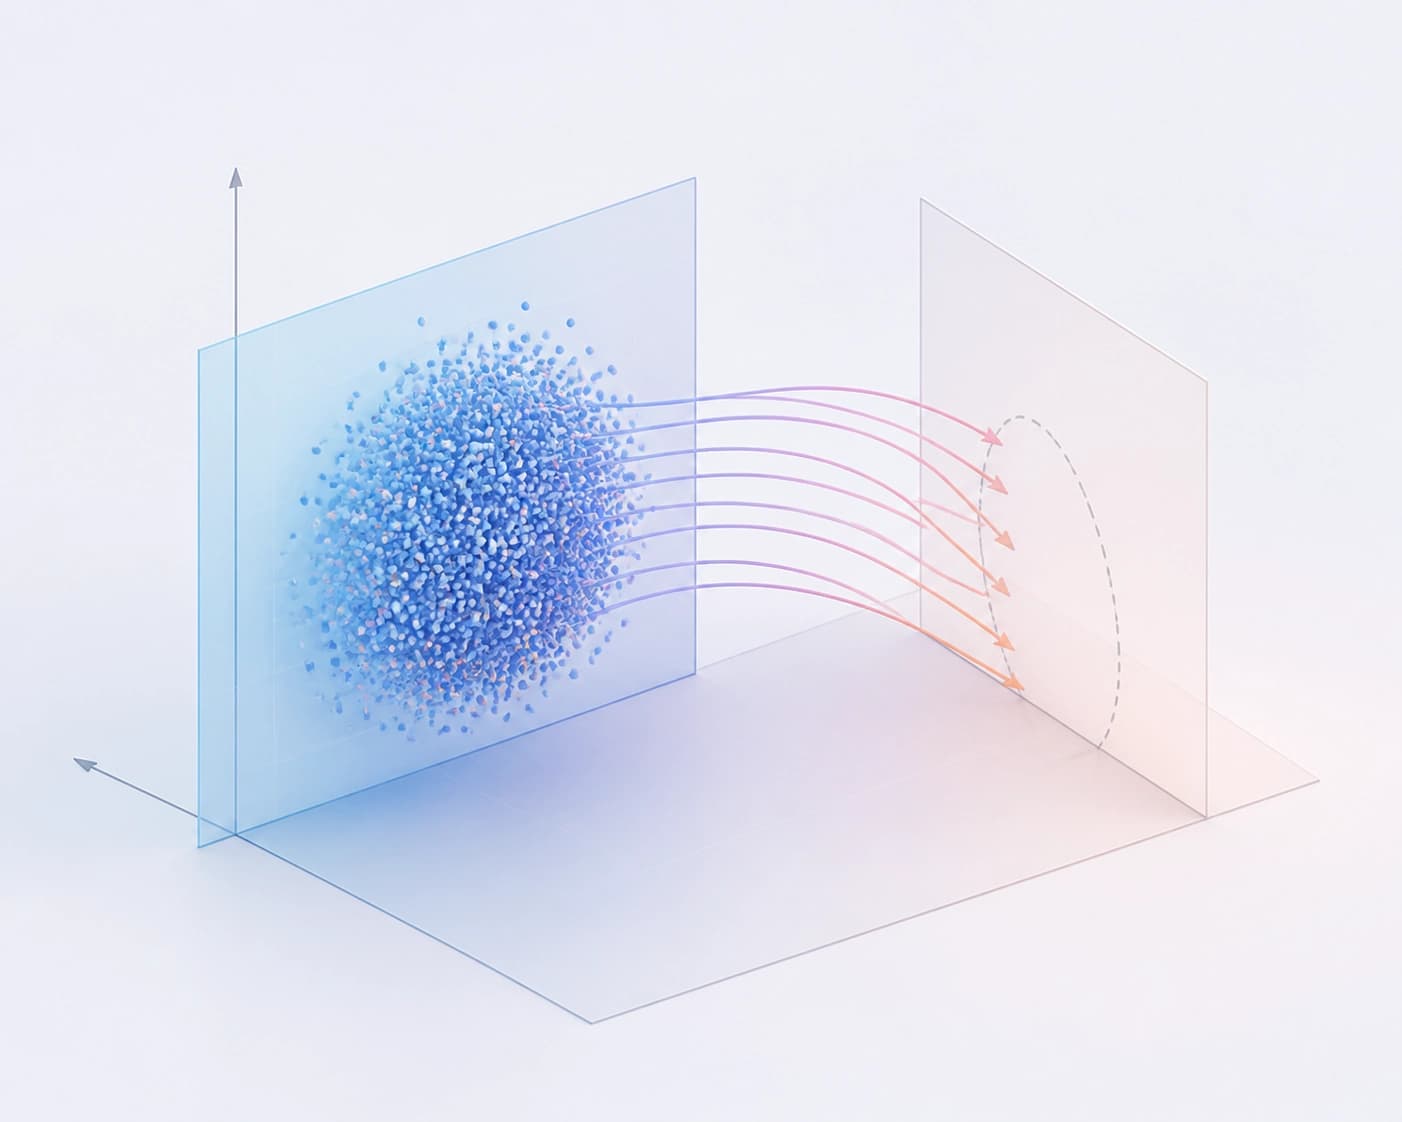
Critère pratique : une méthode qui construit des mises à jour dans le sous-espace nul exploite la capacité disponible. Elle ne touche pas aux activations du raisonnement.
Fonctionnement de NB-LoRA
Null-Basis Low-Rank Adaptation (NB-LoRA) est une méthode d’adaptation paramétriquement efficace des LLM post-RL. Elle a été proposée dans l’article arXiv:2609.25618. La méthode préserve les capacités de raisonnement acquises.
Étapes de fonctionnement :
- Construire une base nulle approximative fixe à partir des activations du raisonnement.
- Reparamétrer les mises à jour LoRA à l’aide de cette base.
- Formuler la préservation du raisonnement comme une contrainte de préservation des états cachés au niveau des couches.
- Respecter la contrainte tout au long du fine-tuning.
Critère pratique : choisir NB-LoRA lorsqu’il faut effectuer un SFT tout en préservant le raisonnement d’un modèle post-RL.
Comparaison avec les approches existantes
Le tableau compare les mécanismes et les caractéristiques.
| Critère | Approches existantes | NB-LoRA |
|---|---|---|
| Mécanisme | Rejeu de l’expérience, initialisation spécialisée, optimisation contrainte avec projection du gradient | Reparamétrisation de LoRA à l’aide d’une base nulle approximative fixe |
| Caractéristique | Préservation limitée des capacités ou calculs supplémentaires importants | Contrainte de préservation des états cachés au niveau des couches |
Critère pratique : si la priorité est de préserver le raisonnement, NB-LoRA offre une contrainte intégrée. Les approches existantes imposent de choisir entre une préservation limitée et des calculs supplémentaires.
Résultats expérimentaux et critères de sélection
Les expériences portent sur plusieurs LLM entraînés par RL et diverses tâches ultérieures. NB-LoRA affiche une qualité d’adaptation comparable à celle de LoRA standard. La méthode préserve la précision du raisonnement à un niveau proche de celui d’avant le fine-tuning. Cette préservation se retrouve sur des benchmarks de raisonnement mis de côté.
Critère pratique : pour les LLM post-RL dont le raisonnement est menacé par le SFT, NB-LoRA est une option à évaluer sur ses propres tâches.