
En bref : de quoi parle-t-on au juste
En août 2026, un article au titre presque banal est apparu sur arXiv — « Software Defined Dataflow System for Large-scale AI Acceleration ». Derrière ce titre se cache la description de l'accélérateur Maia 200, et il ne s'agit pas d'une énième itération du « toujours plus de flops par watt ». L'idée principale est ici architecturale : les auteurs proposent de déplacer les accents dans la façon même dont une puce d'IA est conçue.
Le document a été soumis le 25 août 2026 à la section cs.AR, par Torsten Hoefler, et la liste des auteurs compte 17 personnes au total (Sherry Xu et seize autres chercheurs). Le travail est classé dans plusieurs rubriques à la fois : architectures matérielles, intelligence artificielle, calcul distribué et parallèle, nouvelles technologies et apprentissage automatique. Autrement dit, il ne s'agit pas d'une simple note sur du « hardware », mais d'une conception qui touche à toute la pile.
Des données au lieu d'instructions : l'essence du renversement
Un accélérateur classique est structuré autour d'un flux d'instructions. Il y a des cœurs, un ordonnanceur, une hiérarchie de caches — et toute cette construction sert à exécuter des instructions. Dans ce modèle, la mémoire joue le rôle du personnel de service : fournissez les données à temps, on s'occupe du reste.
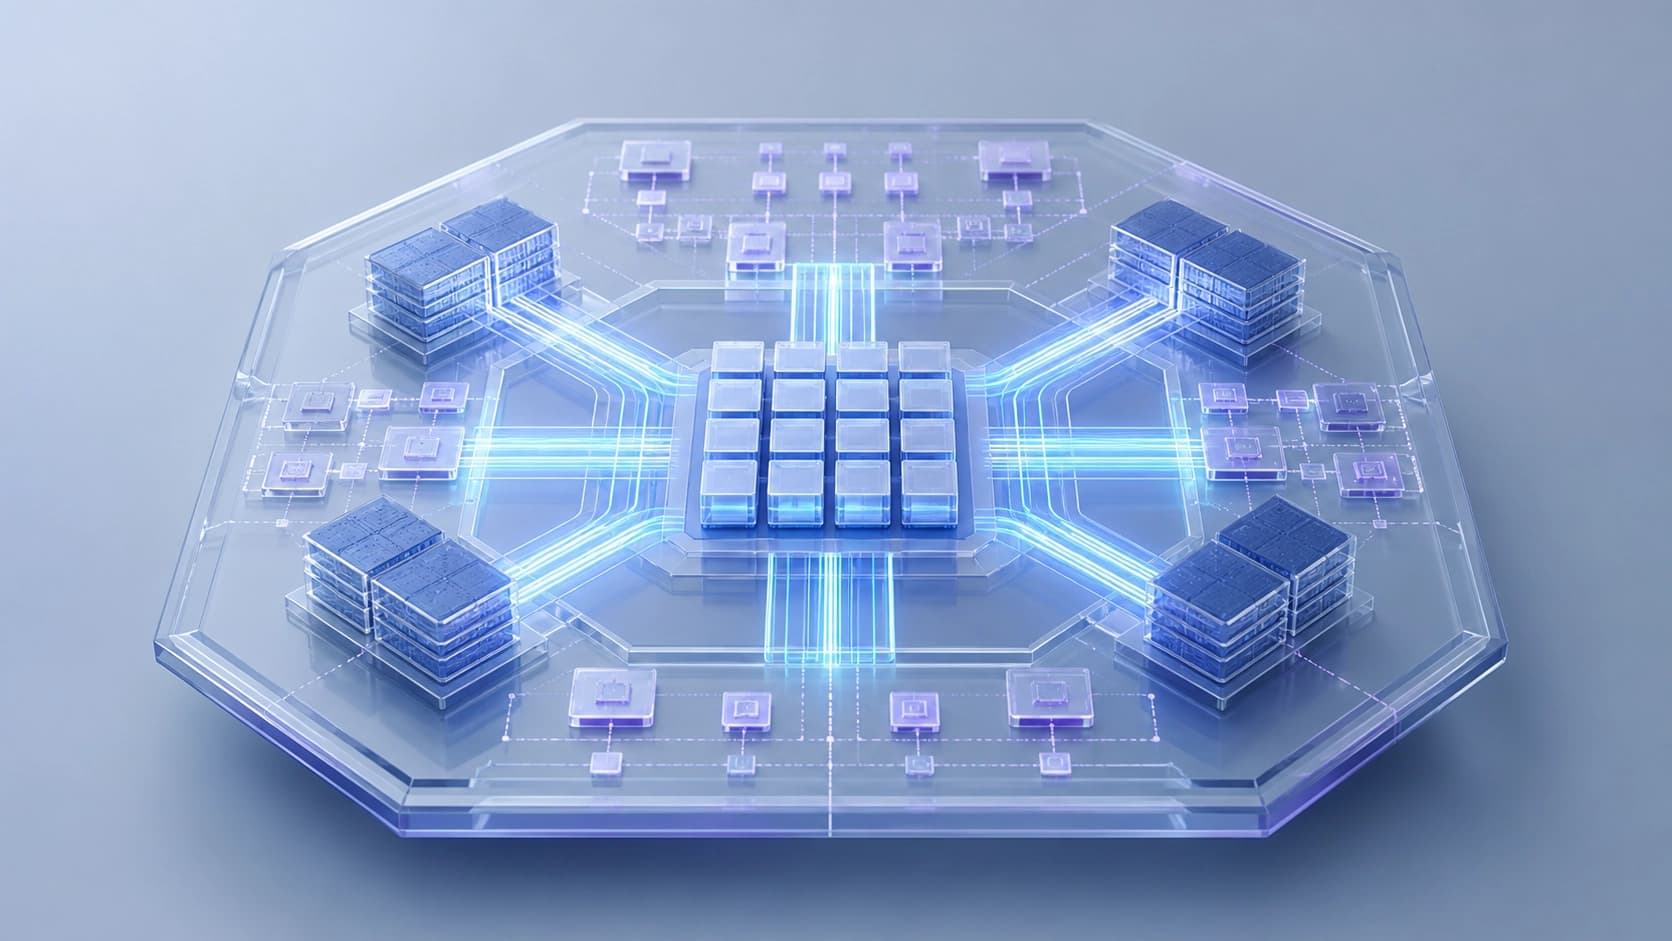
Dans le Maia 200, la logique s'inverse. Les auteurs rattachent la puce à une nouvelle classe — les Software Defined Locally Accessed Dataflow Architectures, en abrégé SDLA. Le mot clé ici est « software defined » : les moteurs dataflow n'existent pas simplement dans le silicium, ils sont explicitement programmés. Le programmeur décrit comment les blocs de mémoire spécialisés et les moteurs de déplacement de données doivent précisément être orchestrés. Le contrôle devient explicite, et non un effet secondaire du pipeline.
D'où ce déplacement du centre de gravité : non pas thread-centric, mais data-movement-centric. La question « combien d'instructions par cycle » cède le pas à la question « à quelle vitesse et sans pertes les données arrivent-elles là où elles seront calculées ». Pour les charges de travail modernes, ce sont des problématiques fondamentalement différentes.
Les chiffres
Les caractéristiques brutes tirées du résumé se présentent ainsi :
- 10 145 Tflop/s en format FP4 ;
- 5072 Tflop/s en FP8 ;
- bande passante mémoire HBM — 7 TB/s ;
- enveloppe thermique — 750 W.
Ce que ces chiffres signifient — et ce qu'ils ne signifient pas
La tentation de comparer immédiatement 10 145 Tflop/s en FP4 à quelque chose de familier est grande, mais il n'y a rien à quoi comparer correctement : les auteurs ne publient pas de mesures sur des modèles précis, et des formats de précision différents avec des méthodologies de mesure différentes donnent des chiffres incomparables. Il faut aussi garder à l'esprit qu'une précision très faible (FP4) est toujours un compromis sur la qualité, et qu'un gain en chiffres n'équivaut pas à un gain en travail utile.
Ce qui est bien plus intéressant ici, ce sont les 7 TB/s. C'est précisément cette caractéristique qui fait écho à l'idée principale de l'article : si l'architecture est construite autour du déplacement de données, alors la bande passante mémoire n'est pas un paramètre secondaire, mais une structure porteuse. Et 750 W rappelle qu'il s'agit d'une baie, pas d'une carte de bureau.
SDLA et une nouvelle taxonomie
Pour expliquer en quoi une telle puce diffère des puces habituelles, les auteurs construisent une taxonomie du contrôle des données. Le point de référence est l'ancienne classification de Flynn, qui répartissait les machines selon le nombre de flux d'instructions et de données. C'était un langage commode pour une époque où le goulot d'étranglement se situait dans l'exécution.
Aujourd'hui, selon les auteurs, il faut un autre langage — portant sur la manière dont le système gère les données. La classification ne porte plus sur le « combien », mais sur le « comment c'est organisé ». Et dans ce cadre, SDLA occupe une case à part : une architecture où la mémoire et le déplacement de données sont des citoyens de première classe, et non un simple arrière-plan.
Le sens pratique d'une telle taxonomie ne réside pas dans l'amour des schémas. Elle donne aux ingénieurs un vocabulaire : on peut débattre de manière sensée de la classe à laquelle appartient un matériel donné et des tâches qui lui conviennent, au lieu de tout mesurer avec un seul chiffre.
Pourquoi c'est important pour l'inférence
L'inférence consiste en grande partie à faire passer à travers la puce d'énormes volumes de poids et d'activations avec des latences minimales. Plus le modèle est grand, plus tout se heurte à la mémoire et aux liaisons entre les blocs, plutôt qu'à l'arithmétique. L'efficacité est ici déterminée par la capacité du système à bien déplacer les données.
Les auteurs affirment que le Maia 200 offre une économie notable en coûts et en énergie, en soutenant un parallélisme massif précisément sur les charges d'inférence. Si cela se confirme sur des tâches réelles, et non seulement sur du synthétique, il s'agira d'un autre équilibre : non pas « la puce la plus rapide », mais « la puce la moins chère à nourrir pour le même volume de requêtes ». Pour les centres de données, où l'on compte en mégawatts, c'est justement l'argument qui fait pencher la balance.
Ce qui reste dans l'ombre
La rigueur exige des réserves. Le travail est un préprint : arXiv:2608.24664, DOI 10.48550/arXiv.2608.24664, avec PDF, version HTML expérimentale et sources TeX disponibles. L'évaluation par les pairs, les mesures indépendantes et la reproduction des résultats restent à venir. Les promesses d'économie d'énergie et d'argent doivent se lire comme une déclaration des auteurs, et non comme un fait mesuré par un tiers.
La deuxième question est le coût de la transition. Un dataflow programmable exige une autre façon de penser : le développeur doit décrire explicitement les routes des données, et les compilateurs comme les frameworks doivent apprendre à en tirer parti. Tant que l'écosystème n'aura pas rattrapé son retard, les avantages du matériel ne seront pas visibles pour tous ni immédiatement. Il en a été ainsi de tout changement de paradigme architectural : d'abord le concept, puis les outils, puis l'adoption massive.
Et pourtant, l'essentiel dans cette histoire n'est pas le nombre de téraflops. Plus important est la formulation elle-même : le goulot d'étranglement du calcul d'IA s'est déplacé là où les données voyagent, et non là où les instructions s'exécutent. Si cette idée est juste, les puces des générations suivantes seront conçues autrement — et, peut-être, c'est à partir de ce travail que le compte à rebours commencera.


