
Nouvelle approche LSem2Vec : comment obtenir un vecteur de code en deux étapes et sans apprentissage coûteux
Les chercheurs ont proposé une méthode simple d'intégration de code source qui combine de grands modèles de langage et des modèles d'embedding de texte. La méthode LSem2Vec ne nécessite pas de réglage fin pour la tâche et, selon les résultats des expériences, surpasse cinq approches non supervisées modernes.
Qu'est-ce que les embeddings de code
La représentation vectorielle du code source est nécessaire pour de nombreuses tâches pratiques : de la recherche de fragments similaires au regroupement automatique de fonctions selon leur sens. Le programme se transforme en un ensemble de nombres que les algorithmes d'apprentissage automatique peuvent traiter. La qualité du vecteur dépend alors de la capacité du modèle à comprendre la sémantique du code, et pas seulement sa syntaxe.
En quoi c'est complexe
Les méthodes classiques exigent généralement un apprentissage dédié pour chaque tâche, ou au minimum un réglage fin sur des données de domaine. C'est coûteux et pas toujours justifié. Les approches fondées sur les grands modèles de langage (LLM) semblent plus universelles, mais elles ont leur inconvénient : les réponses des modèles contiennent souvent des informations superflues ou erronées, et cette « impureté » se retrouve dans les vecteurs.
L'idée de LSem2Vec
Les auteurs de l'étude ont proposé une approche en deux étapes au nom évocateur : LSem2Vec — LLM-extracted code Semantics to Vector embedding. Au lieu de tenter d'entraîner un autre modèle lourd, ils combinent des composants déjà prêts : le LLM extrait le sens du code, et un modèle d'embeddings de phrases transforme la description en vecteur. Aucun réglage fin pour une tâche spécifique n'est requis.
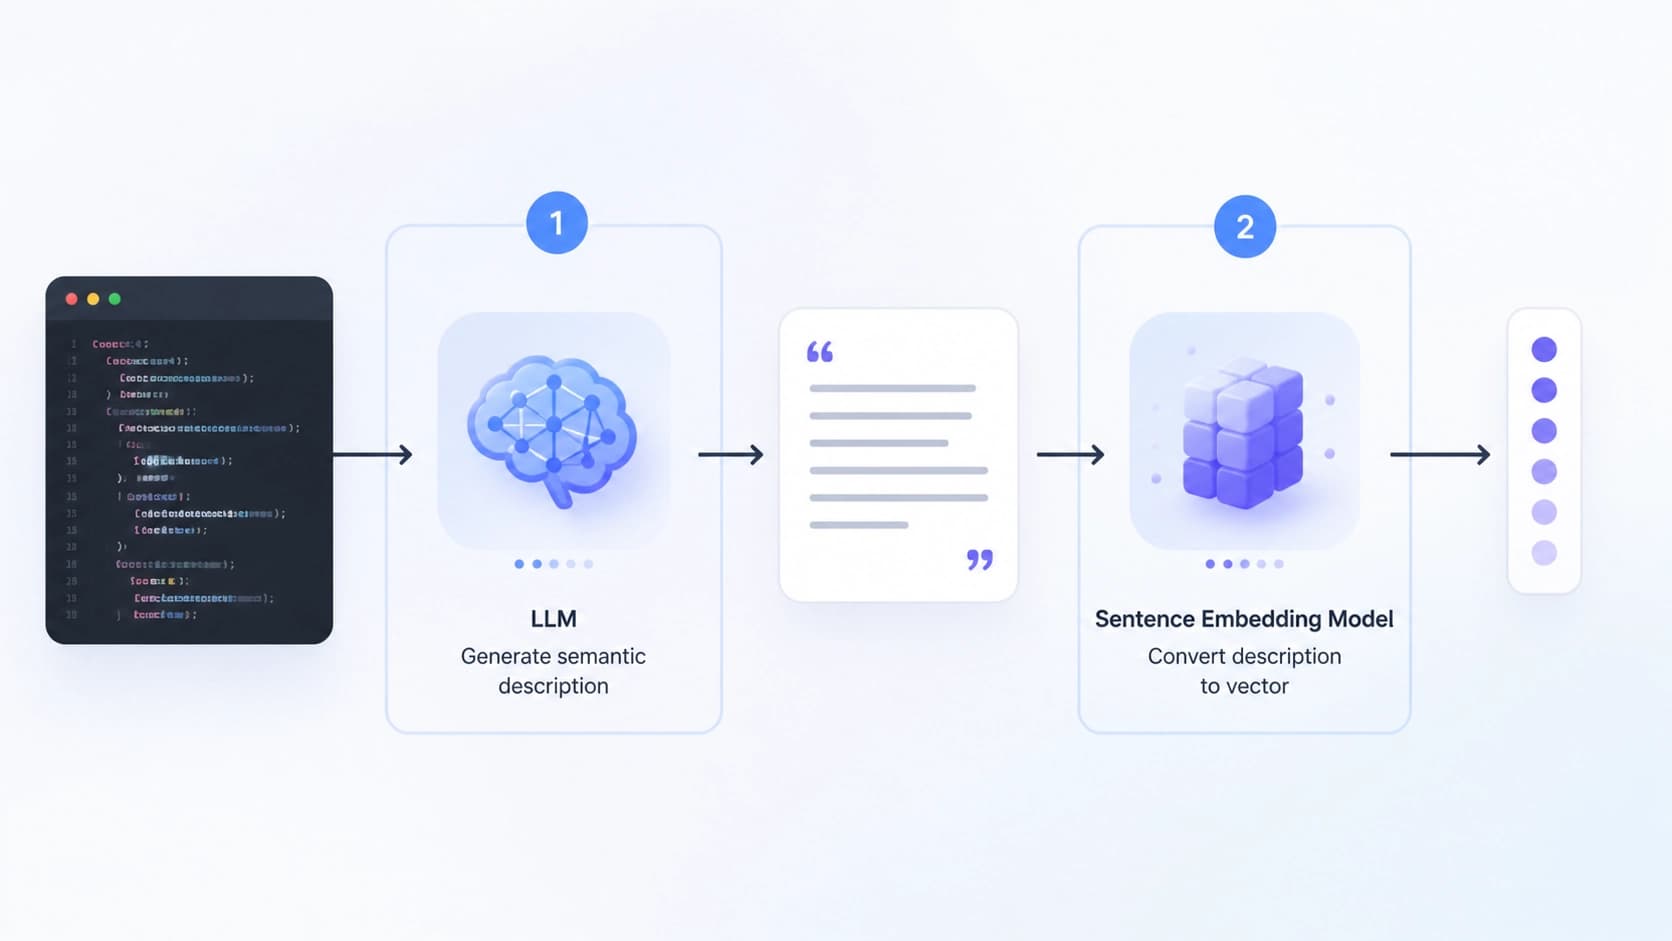
Décomposons le processus étape par étape. Dans un premier temps, le LLM reçoit le code et doit formuler ce qu'il fait précisément. Ce n'est pas une reformulation mécanique de la source, mais une extraction de l'essentiel : le modèle écarte les détails secondaires pour que la description ne contienne que ce qui compte pour le sens. Au passage, cette approche élimine aussi les éventuelles « hallucinations » des grands modèles — ces informations erronées qui apparaissent le plus souvent lorsqu'on tente d'encoder le code directement.
La deuxième étape est triviale aux standards de l'apprentissage automatique : la description obtenue du LLM est transmise à un modèle d'embeddings de phrases. Ce type de modèle est déjà entraîné à convertir le langage naturel en vecteurs pertinents, il n'est donc pas nécessaire de l'adapter à la syntaxe des langages de programmation.
Pourquoi cela fonctionne
La force de LSem2Vec réside dans une séparation claire des rôles. Un modèle est responsable de la compréhension de la logique, l'autre de la traduction du texte en vecteur. Chacun résout sa tâche de manière optimale, et ensemble ils produisent un vecteur fondé sur la sémantique, et non sur des caractéristiques formelles du code. L'absence d'étape d'apprentissage rend l'approche économique et facile à reproduire.
Comment cela a été testé et quels sont les résultats
Les expériences ont été menées sur trois ensembles de données composés dans différents langages de programmation. Les auteurs ont délibérément fait varier à la fois les LLM et les modèles d'embeddings afin de vérifier que le résultat ne dépend pas d'une paire d'outils particulière.
Dans toutes les configurations, LSem2Vec a obtenu de meilleurs résultats que cinq méthodes non supervisées modernes, généralement conçues pour des conditions spécifiques et nécessitant un réglage.
Statut des travaux
L'article a été mis en ligne sur arXiv en septembre 2024, la dernière version disponible étant la v5 d'août 2026. Selon les informations des auteurs, les travaux ont été acceptés par la revue Frontiers of Computer Science. L'approche dispose donc non seulement d'une page de prépublication, mais aussi d'une publication évaluée par les pairs. L'original est disponible via le DOI : 10.1007/s11704-026-61288-0.
Conclusion
Le principal enseignement de LSem2Vec est que les problèmes complexes ne nécessitent pas toujours des solutions complexes. Il suffit d'appliquer séquentiellement un LLM pour extraire le sens et un modèle d'embeddings de phrases pour créer le vecteur. C'est rapide, sans réglage fin dédié, et cela donne des résultats compétitifs.
Foire aux questions
Matériaux connexes
Tous matériaux
La validation des candidats coûte plus cher que leur génération : des leurres contre la recherche de vulnérabilités par les LLM
Cette étude analyse l’asymétrie des coûts de la recherche agentique de défauts : la génération de variantes est peu coûteuse, tandis que leur confirmation au moyen d’une analyse d’accessibilité, de l’exécution et d’un PoC mobilise l’essentiel du budget ; la vérification peut donc devenir une cible de défense à part entière. RedHerring, qui propose des leurres adaptés au dépôt et assortis d’un certificat secret, a réduit de 38,7 à 60,4 % le nombre de véritables vulnérabilités détectées, à coût égal, dans 33 projets OSS-Fuzz ; même après avoir averti l’agent, la baisse restait de 37,2 %.
9 novembre 2026
Vérification des hallucinations des LLM via une vue SQL des sources, sans réentraînement
Ce travail évalue si un LLM peut mobiliser une compétence symbolique élémentaire — la création d’une base SQL à partir des documents sources — afin d’ancrer les réponses dans leurs sources sans supervision pour détecter les hallucinations. Sur RAGTruth et DiaHalu, ce pipeline neuro-symbolique se révèle plus précis que la prédiction directe et comparable aux méthodes de pointe, sans nécessiter de réglage fin spécifique au domaine.
9 novembre 2026
MathAdv : ce que cache la précision finale des preuves automatiques
Un ensemble de tâches diagnostiques couvrant 13 domaines des mathématiques universitaires et de troisième cycle évalue les systèmes de démonstration automatique dans Lean 4 non seulement sur le résultat final, mais aussi sur leur maîtrise des sujets, la qualité de leurs raisonnements informels et leur robustesse face aux reformulations des énoncés. L’analyse par composante montre que la formalisation des problèmes reste le principal obstacle et que la réussite dépend fortement du domaine mathématique et de la manière dont le problème est formulé.
9 novembre 2026