Ce que change LocalProp
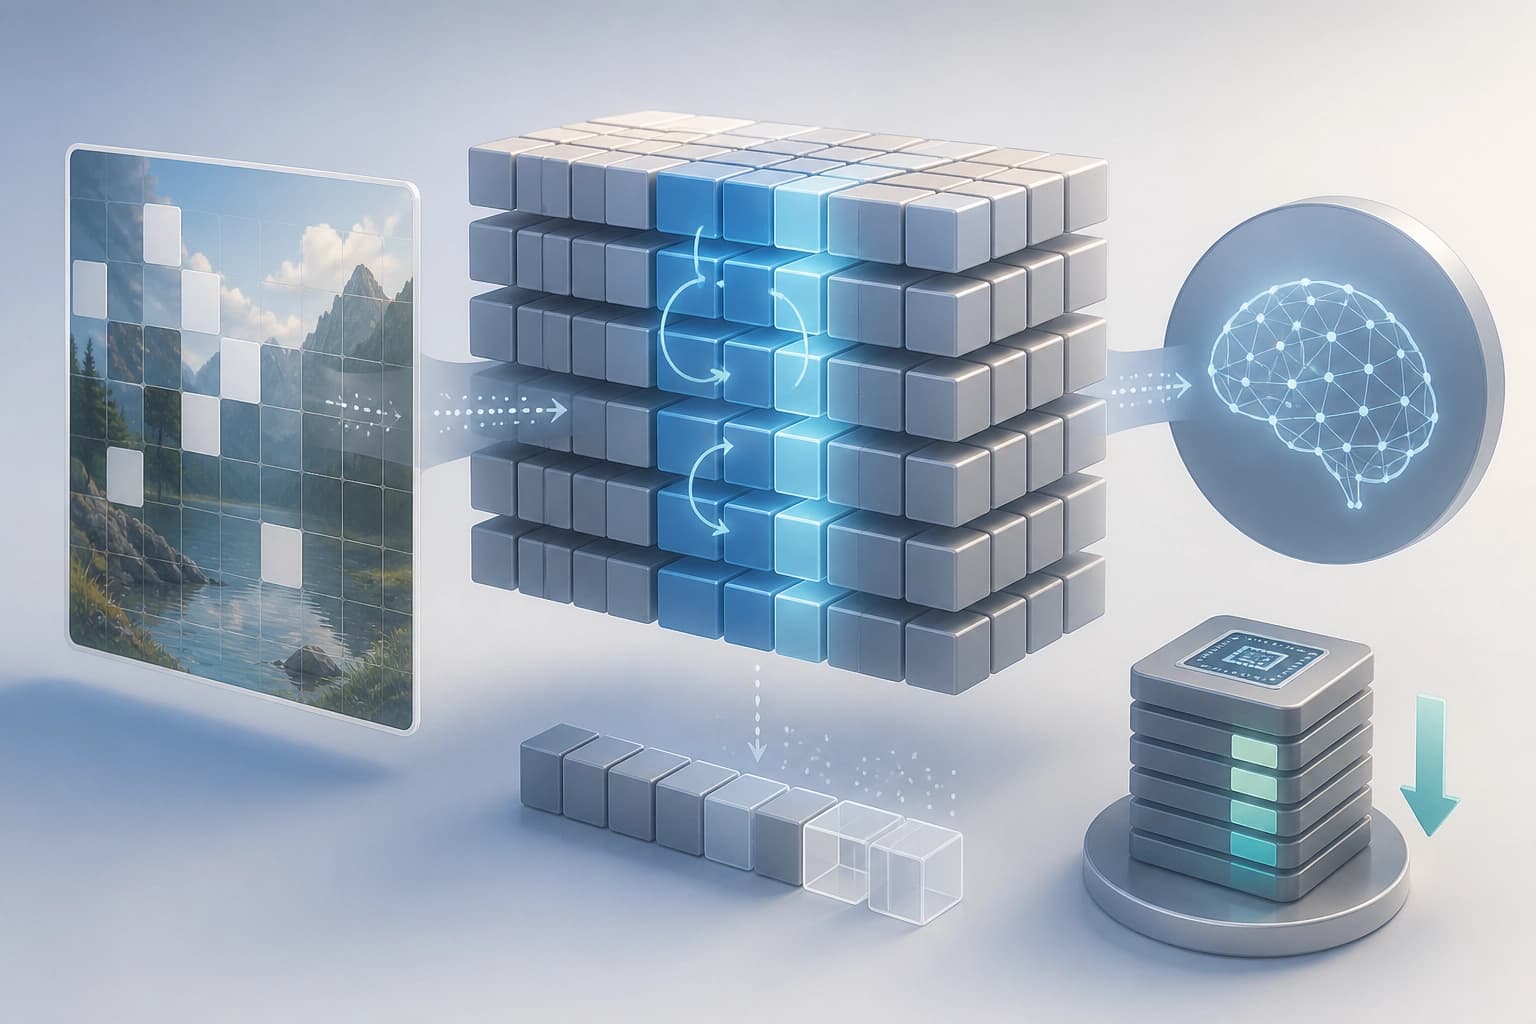
LocalProp est une procédure d’entraînement qui met à jour localement les poids du modèle. Les auteurs l’opposent à la rétropropagation du gradient à travers l’ensemble du modèle. Le passage de bout en bout ne correspond pas à un apprentissage biologiquement plausible. Il est également inefficace en termes de mémoire. Dans le cerveau, l’apprentissage est fortement localisé.
| Critère | Rétropropagation du gradient de bout en bout | LocalProp |
|---|---|---|
| Mise à jour des poids | Traverse l’ensemble du modèle | Locale |
| Plausibilité biologique | N’est pas conforme | S’appuie sur l’apprentissage localisé dans le cerveau |
| Mémoire | Inefficace | Seule une partie de la mémoire GPU maximale est utilisée |
| Contrôle | Pas de paramètre distinct | Nombre de blocs optimisés conjointement |
Conclusion : LocalProp remplace le passage de bout en bout par des mises à jour locales. Cela réduit la charge mémoire.
Étapes de l’entraînement
LocalProp suit un schéma « pré-entraînement puis réglage fin ». Les étapes s’enchaînent.
- Pré-entraînement sur I-JEPA.
- Mise à jour locale des poids.
- Élagage.
- Court réglage fin final.
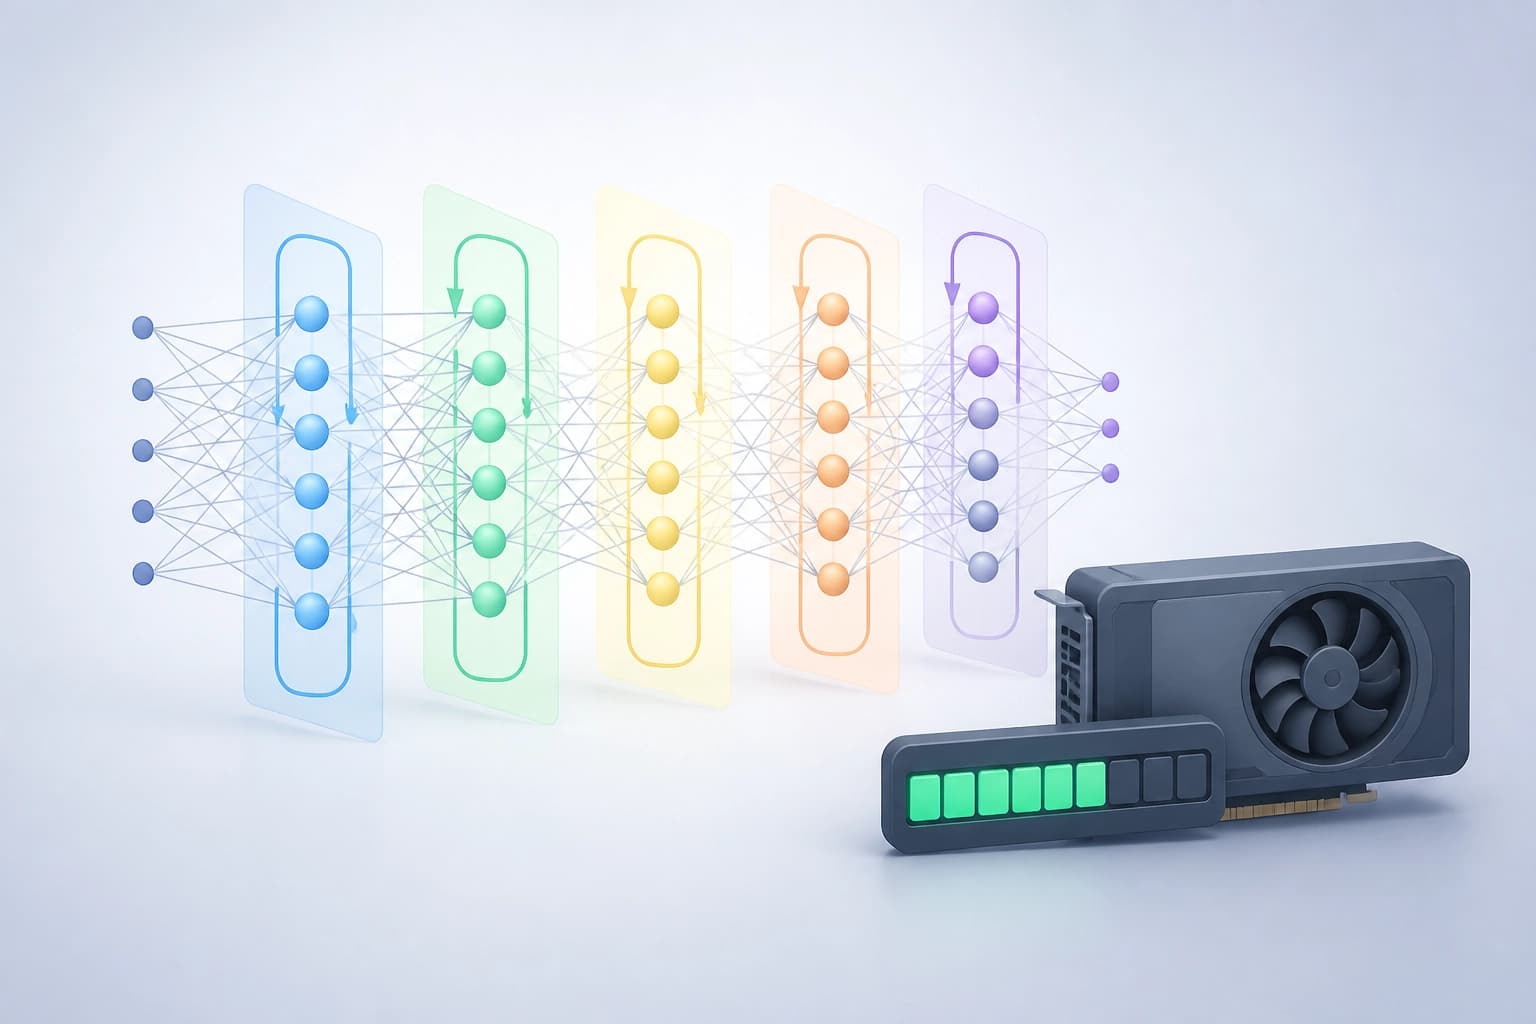
Conclusion : le schéma associe pré-entraînement, mises à jour locales, élagage et réglage final.
Rôle de l’élagage
L’élagage transmet le signal d’entraînement des blocs supérieurs aux blocs inférieurs. Cette étape ne se réduit pas à la compression du modèle. Elle relie les blocs supérieurs et inférieurs pendant l’entraînement. Conclusion : dans LocalProp, l’élagage joue le rôle de canal de transmission du signal entre les blocs.
Compromis entre précision et mémoire
Le nombre de blocs optimisés conjointement détermine la longueur de propagation du gradient. Les auteurs définissent cette longueur comme un paramètre pratique. Ce paramètre permet de gérer le compromis entre précision et utilisation de la mémoire.
- Ce qui change : la longueur de propagation du gradient.
- Ce que cela permet de gérer : l’équilibre entre précision et mémoire.
- Comment cela s’utilise : via le nombre de blocs optimisés conjointement.
Conclusion : le réglage du nombre de blocs permet de trouver un équilibre.
Résultats et critères de choix
Les auteurs ont mené des expériences sur plusieurs jeux de données, notamment des benchmarks à grande échelle comme ImageNet. LocalProp obtient de bons résultats en n’utilisant qu’une partie de la mémoire GPU maximale. La proportion exacte n’est pas indiquée dans le texte. Critère pratique : LocalProp convient lorsque la rétropropagation de bout en bout se heurte aux limites de mémoire GPU. Le nombre de blocs optimisés conjointement permet de régler l’équilibre.