
L'ourdou hors des radars : pourquoi les LLM laissent passer la haine dans une écriture méconnue
Cinq modèles bien connus — de GPT-4o à Llama-3.1 — rendent des verdicts différents sur un même texte lorsqu'il est écrit en ourdou plutôt qu'en traduction anglaise : les divergences atteignent un tiers des cas, et une partie du contenu manifestement hostile reste sans signalement. L'analyse de neuf années de publications de WOAH a montré qu'aucun travail distinct ne lui a été consacré.
En bref : le problème n'est pas la langue, mais l'écriture
On a coutume d'évaluer les filtres de sécurité des grands modèles de langage en anglais. D'où une illusion commode : si le modèle repère avec assurance les insultes et les appels à la violence dans un texte anglais, il fera à peu près aussi bien dans d'autres langues. L'ourdou — langue comptant environ 246 millions de locuteurs, dixième au monde à ce titre — n'entre presque jamais dans ce type de vérification. Et ce vide a, semble-t-il, un coût mesurable.
C'est l'objet d'un travail récent portant l'identifiant arXiv:2608.24191. Le titre « Ghaib in Translation » joue sur le mot ghaib, qui en ourdou signifie « caché, invisible » : il s'agit des préjudices qui passent inaperçus. Les autrices et auteur sont Fawzia Zehra (Fuzzy) Kara-Isitt, Sonal Khosla et Stephen Swift. La première version est parue le 25 août 2026, la révision actualisée le 9 septembre de la même année ; l'article relève des domaines cs.CL et cs.AI, DOI — 10.48550/arXiv.2608.24191.
Comment l'expérience est conçue
Modèles et données
L'équipe a fait passer cinq modèles populaires par un même scénario de classification : GPT-4o, Claude Sonnet 4.5, Gemini 2.5 Flash, Qwen-2.5 et Llama-3.1. Le jeu de données comprend six corpus couvrant quatre formes d'existence différentes de la langue : l'ourdou en écriture nastaliq, l'ourdou en caractères latins (roman), l'anglais et des textes mixtes ourdou-anglais, où les langues alternent au sein d'un même message.
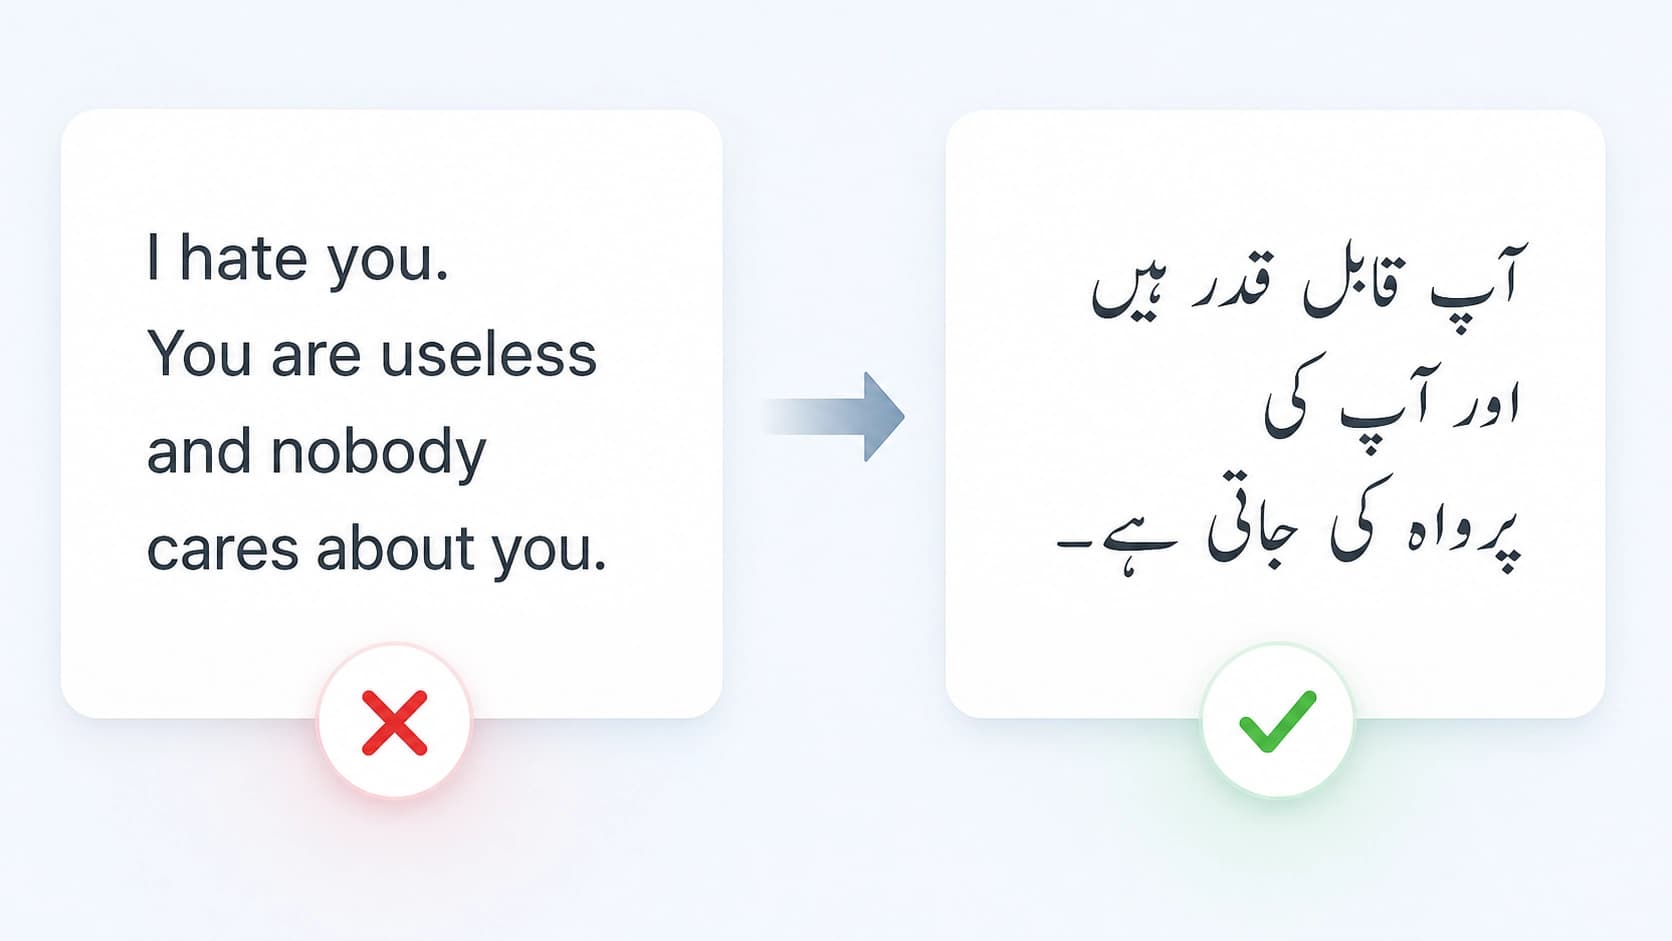
Détail important : ce n'est pas tant la qualité en soi qui était testée que la stabilité de la décision. Un même sens était soumis au modèle deux fois — dans l'écriture d'origine et dans sa traduction anglaise. Si le filtre ne se déclenche que dans le second cas, c'est que la protection est liée non pas au contenu, mais aux lettres avec lesquelles il est écrit.
Deux métriques
Les auteurs s'appuient sur deux indicateurs simples. Le premier est la part de divergences : à quelle fréquence l'étiquette change entre l'original et la traduction. Le second a été baptisé « Missed-in-Urdu » : il s'agit des contenus jugés nuisibles dans la version anglaise, mais passés pour inoffensifs dans l'écriture d'origine. En substance, c'est un oubli pur et simple — précisément ce contre quoi la modération existe.
Ce que montrent les chiffres
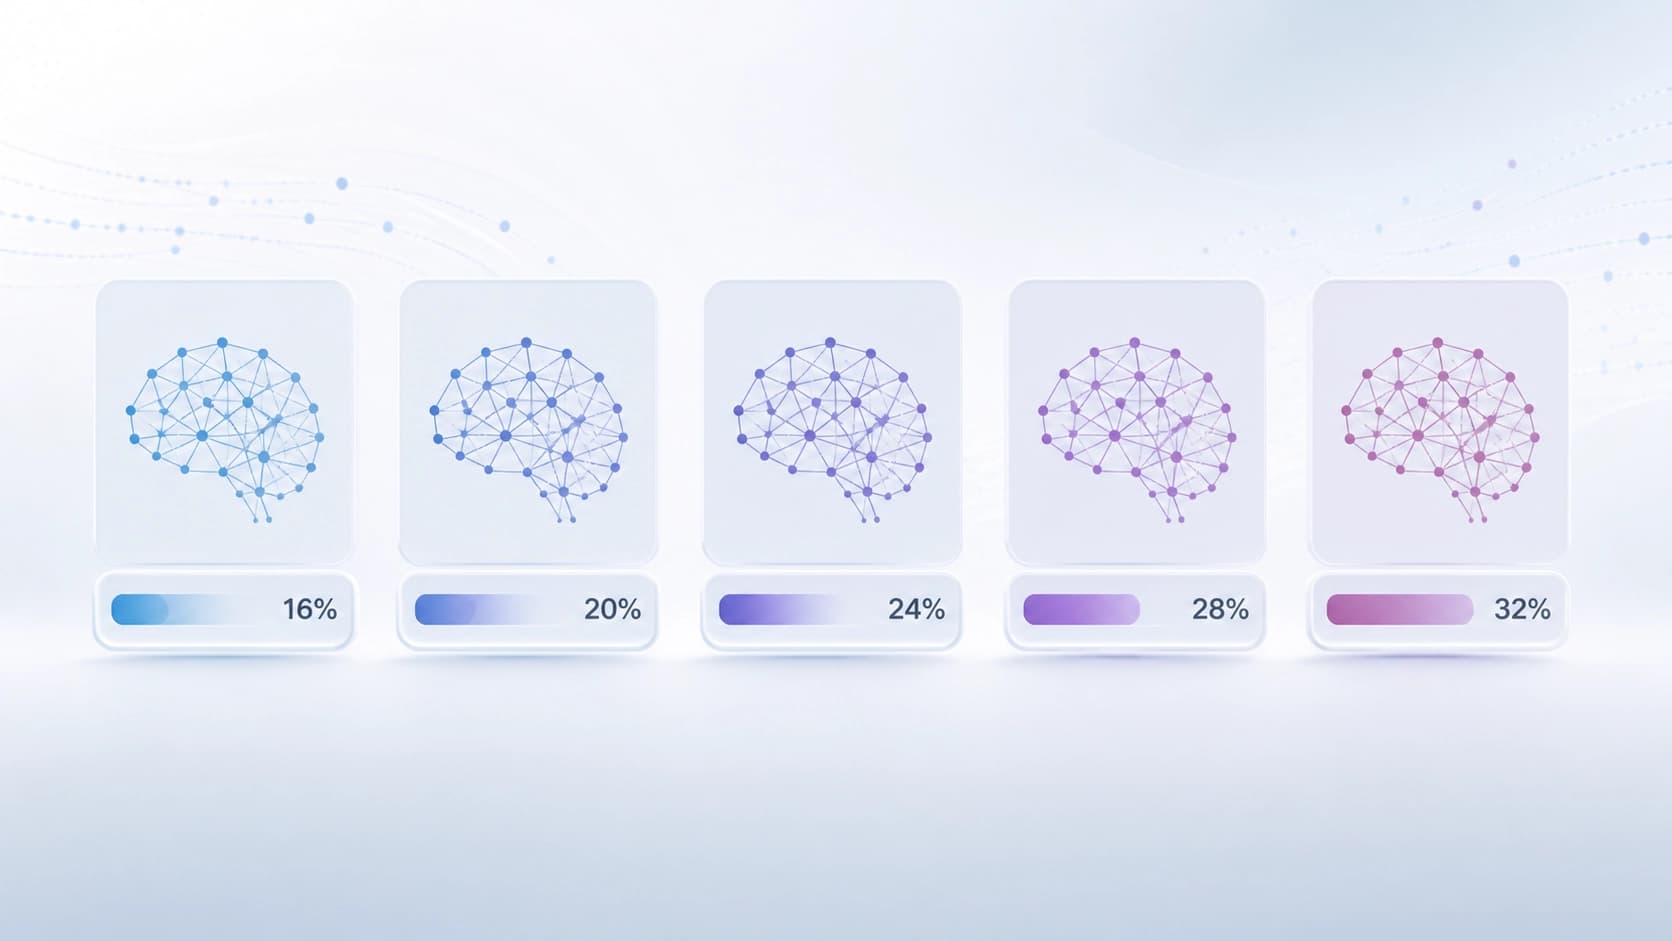
Sur les cinq corpus où le texte était bien écrit en ourdou, l'écart des résultats entre la classification sur l'original et sur la traduction allait de 15,9 % à 31,6 %. Le meilleur résultat est celui de Gemini 2.5 Flash, le moins bon celui de Qwen-2.5. Autrement dit, dans le cas le plus défavorable, environ une décision de filtre sur trois dépendait de l'alphabet dans lequel le même texte était soumis.
La part de préjudices manqués va de 2,4 % à 9,9 %, avec une médiane de 4,3 %. À première vue, peu de chose, mais il faut le traduire à l'échelle humaine : si une plateforme dont l'audience se compte en millions d'utilisateurs traite des dizaines de milliers de messages par jour, même 4 % représentent des centaines d'unités de contenu toxique qui passent chaque jour. Et il ne s'agit pas de cas limites comme le sarcasme, mais de contenus que le même modèle étiquette avec assurance comme nuisibles dès qu'on les traduit.
La tendance générale que relèvent les auteurs : plus le modèle est petit et ouvert, plus les deux métriques chutent nettement. Les systèmes fermés phares tiennent mieux la distance, mais leur écart n'est pas nul non plus.
Neuf ans de littérature — et pas un seul travail
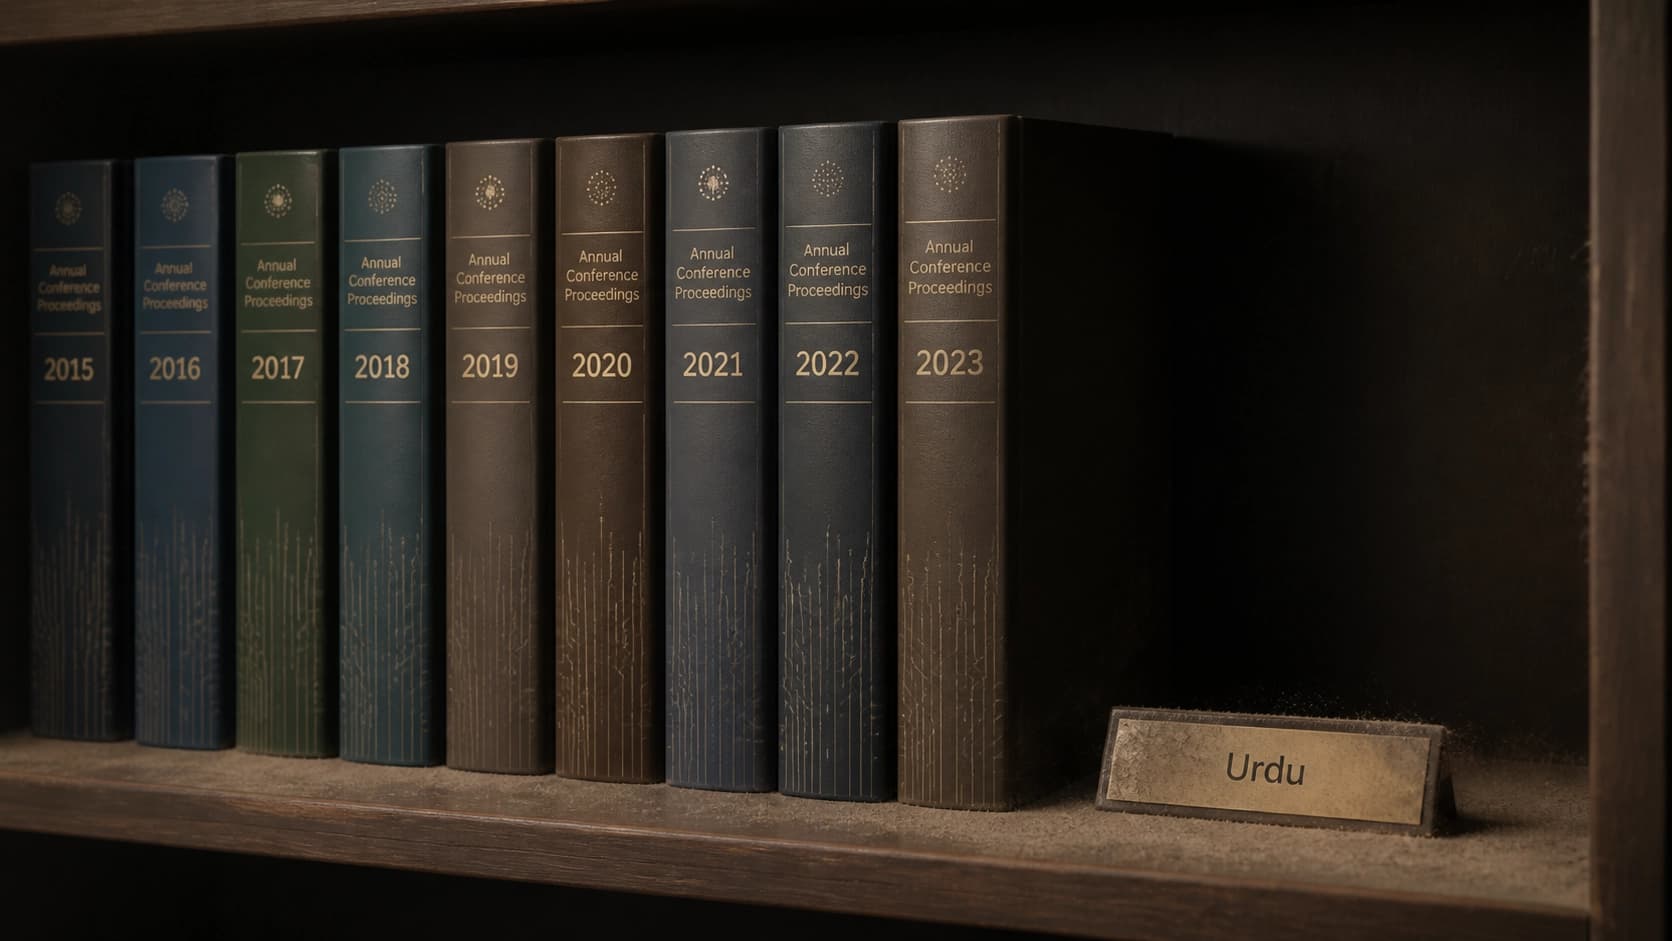
Une ligne de recherche à part est bibliographique. Les auteurs ont passé en revue, via l'API ACL Anthology, les 205 articles des neuf éditions d'ALW/WOAH et n'en ont trouvé aucun consacré spécifiquement à l'ourdou. Cela ne signifie pas que le sujet n'a jamais été étudié — mais dans le corpus des travaux du principal atelier d'évaluation des préjudices, il n'existe pas comme axe à part entière. D'où un cercle vicieux : pas de benchmarks — pas de publications — pas de pression sur les développeurs — de nouveau pas de benchmarks.
Pourquoi cela se produit
L'article n'apporte pas de réponse exacte, mais la mécanique se comprend par des considérations générales. Le nastaliq est une écriture cursive, où la forme de la lettre dépend de sa position dans le mot ; les tokeniseurs réglés sur l'alphabet latin découpent donc un tel texte en fragments peu avantageux. Les données en ourdou dans les corpus d'entraînement sont des ordres de grandeur moins nombreuses qu'en anglais. L'annotation pour l'apprentissage par renforcement (y compris en matière de sécurité) est elle aussi majoritairement collectée par des locuteurs natifs de l'anglais. S'y ajoute un compromis commode : traduire l'entrée en anglais, lancer la vérification, renvoyer la réponse. Cela économise des ressources, mais ajoute un intermédiaire, et c'est lui qui produit la divergence.
Que faire de tout cela dans les équipes produit
- Ne pas se fier à la traduction comme approximation. Si le filtre décide sur la version anglaise, il faut mesurer l'écart, pas le passer sous silence.
- Faire de la divergence une métrique. Il est utile de calculer régulièrement combien de décisions changent lorsqu'on change d'écriture : c'est un moyen peu coûteux de repérer les angles morts sans nouvelle annotation.
- Tester sur l'écriture d'origine. Nastaliq, roman et code-switching sont trois modes distincts, et de bons résultats dans l'un ne garantissent rien dans les deux autres.
- Ne pas aligner les seuils à l'aveugle. Augmenter la sensibilité sur une écriture se transforme facilement en flux de faux positifs sur une autre.
- Tenir compte de l'audience. 246 millions de locuteurs, ce n'est pas une langue de niche, mais une part notable des utilisateurs de toute grande plateforme.
La conclusion vers laquelle mènent les auteurs est sèche, mais pertinente : les garanties de sécurité sont aujourd'hui réparties de manière inégale entre les écritures. Tant qu'il en est ainsi, « le modèle a passé les tests de sécurité » est une affirmation qu'il convient toujours de préciser : dans quelle langue et avec quelles lettres ces tests ont été écrits.
Foire aux questions
Matériaux connexes
Tous matériaux
Toollery : sélection d’outils pour agents LLM parmi des dizaines de milliers d’options sans réentraînement
Toollery construit un index de recherche à partir des descriptions des compétences et des outils, puis ne transmet au modèle qu’un nombre limité de candidats pour chaque requête. Lors d’expériences menées sur des bibliothèques comptant jusqu’à plusieurs dizaines de milliers de fonctions, cette approche permet de maintenir la qualité de sélection avec un top-K fixe, même si l’effet final dépend du profil de charge et de la mise en cache côté fournisseur.
11 novembre 2026
Diagnostic étape par étape des agents GUI lors de l’analyse de tableaux de bord : benchmark DashAct
Découvrez DashAct, un benchmark de 348 trajectoires vérifiées par des humains, qui décompose le travail des agents GUI avec des panneaux interactifs en trois étapes et quatre conditions visuelles. Les résultats révèlent des difficultés persistantes à prédire les actions et à les ancrer sur des cibles visuelles, ainsi que la dépendance des réactions des agents à l’égard du soutien contextuel et spatial.
11 novembre 2026
WILSON : regroupement des grossissements et des lames du patient pour l’analyse pathomorphologique et la rédaction de comptes rendus
La prépublication présente WILSON, un modèle vision-langage qui encode des images de lames entières ainsi que des séries de prélèvements d’un même patient à différents grossissements, plutôt qu’une seule lame « optimale ». Sans entraînement supplémentaire pour une tâche donnée, il surpasse des modèles spécialisés et de plus grande taille dans plusieurs métriques, tout en nécessitant beaucoup moins de ressources de calcul, et ses descriptions diagnostiques ont obtenu de meilleures évaluations de la part des pathologistes.
11 novembre 2026