
Données imbriquées et vieux problème de l'inférence causale
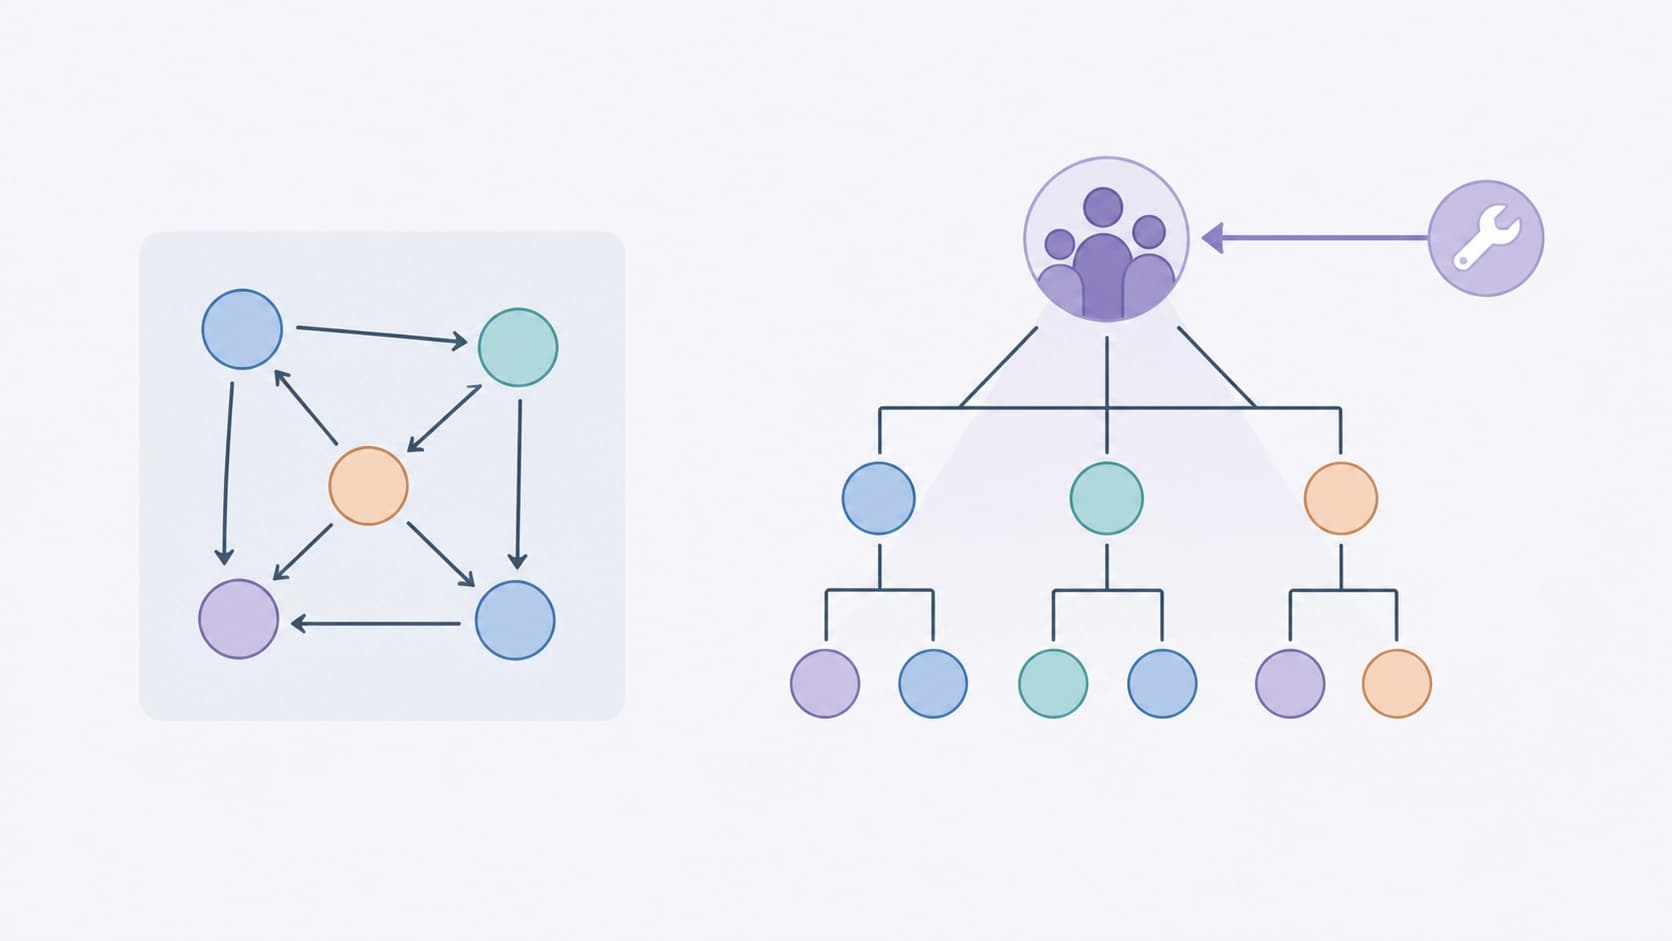
Les méthodes classiques d'inférence causale fonctionnent bien lorsque les observations sont indépendantes les unes des autres. Mais dès que les données acquièrent une hiérarchie — élèves au sein de classes, patients au sein de cliniques, employés au sein de services — le schéma naïf commence à tromper. Le groupe commun crée une corrélation entre les objets, que le modèle prend à tort pour un signal, et les interventions qui se produisent au niveau supérieur (par exemple, un changement de conditions dans une classe entière) n'ont tout simplement nulle part où se « brancher ».
C'est précisément le sujet du nouvel article arXiv:2608.24500 dans la section stat.ML — « Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR ». Le travail a été publié le 25 août 2026 par un groupe de neuf auteurs — Janis Aiad, Aghiles Drali, Aymen El Ouadrhiri, Anass Ettahiri, Yasser Oufqir, Simon Patry, David Cortes, Marianne Clausel et Emilie Devijver. Le PDF, la version HTML et les sources TeX sont disponibles ; la thématique porte sur l'apprentissage automatique et l'intelligence artificielle.
Le matériel est intéressant moins pour un nouveau modèle que pour sa tentative de construire un pipeline complet et reproductible : de l'écriture formelle du graphe jusqu'à un chiffre concret, défendable dans un article ou un rapport devant un client.
Ce que proposent les auteurs
Il s'agit d'un pipeline pour les modèles causaux structurels hiérarchiques (HSCM). Il est ouvert et conçu pour être scalable : la même logique doit tenir aussi bien pour un petit exemple pédagogique que pour des données comportant un grand nombre de groupes.
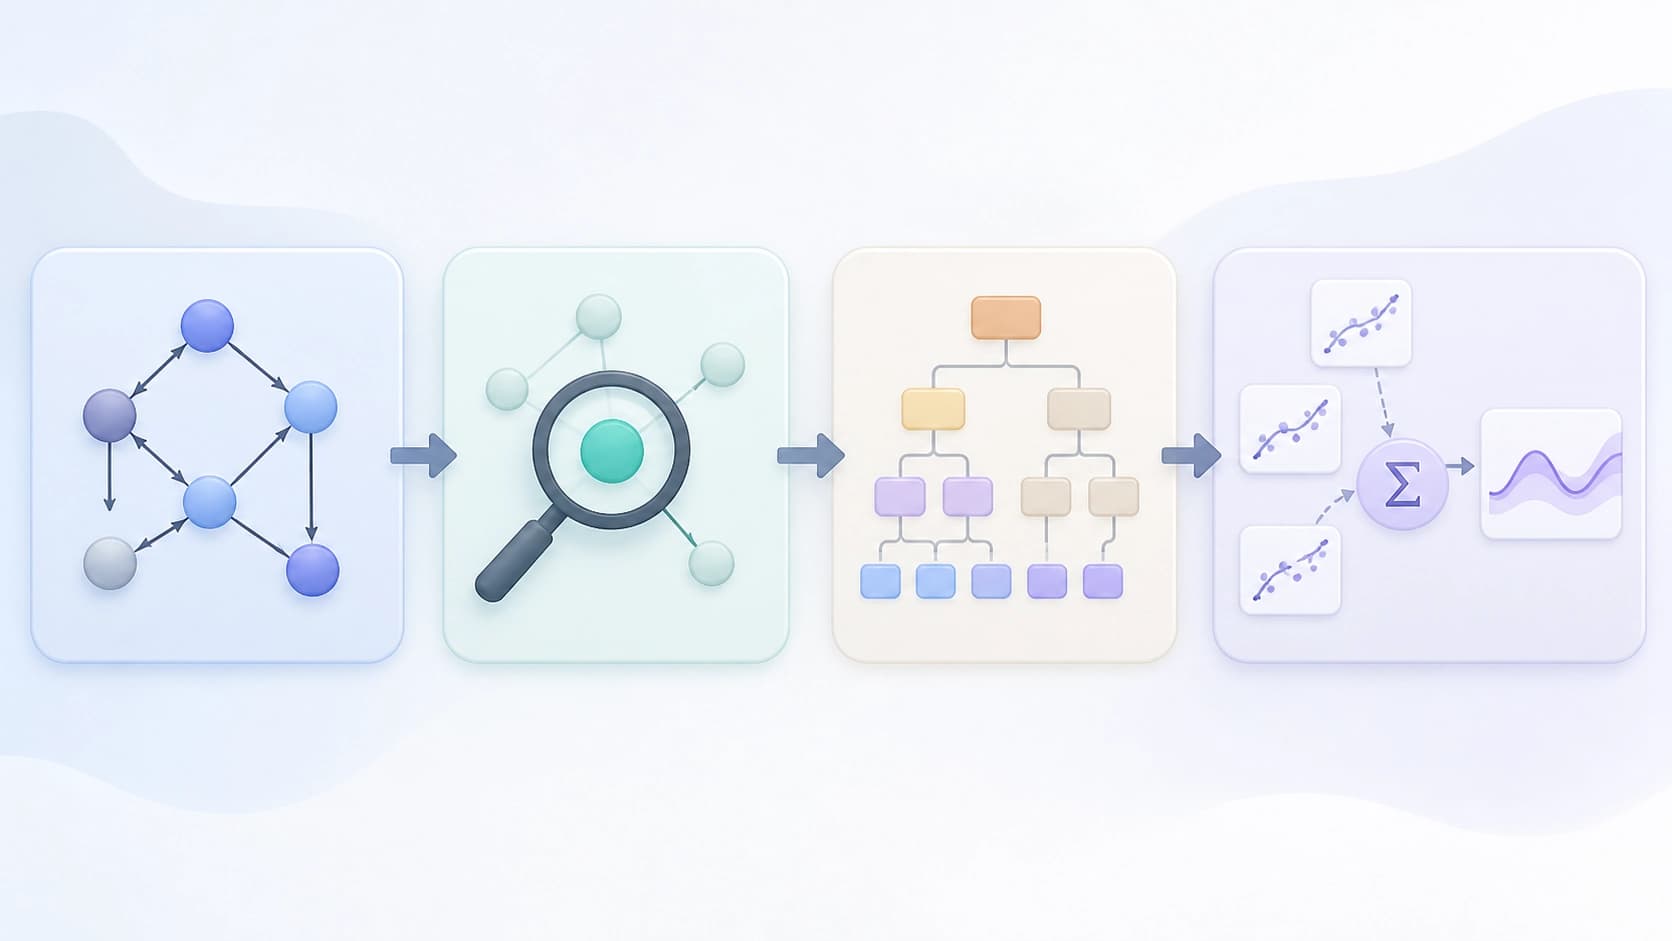
La construction s'articule en quatre couches :
- transformations de graphes — préparation de la structure décrivant les dépendances entre niveaux ;
- identification symbolique via le do-calculus dans la bibliothèque pyAgrum — la machine détermine elle-même quels effets sont déductibles des données disponibles et produit l'expression correspondante ;
- traduction de cette expression en formules fermées HSCM — le résultat symbolique est transformé en quelque chose de calculable dans le cadre du modèle hiérarchique ;
- estimation numérique à partir de modèles probabilistes locaux déjà ajustés.
La logique est ici fondamentalement en deux étapes. On détermine d'abord si l'effet est identifiable en principe — c'est une question de mathématiques, pas de données. Et seulement ensuite la statistique entre en jeu : estimation, erreur, robustesse.
L'arbre syntaxique abstrait comme clé de l'échelle
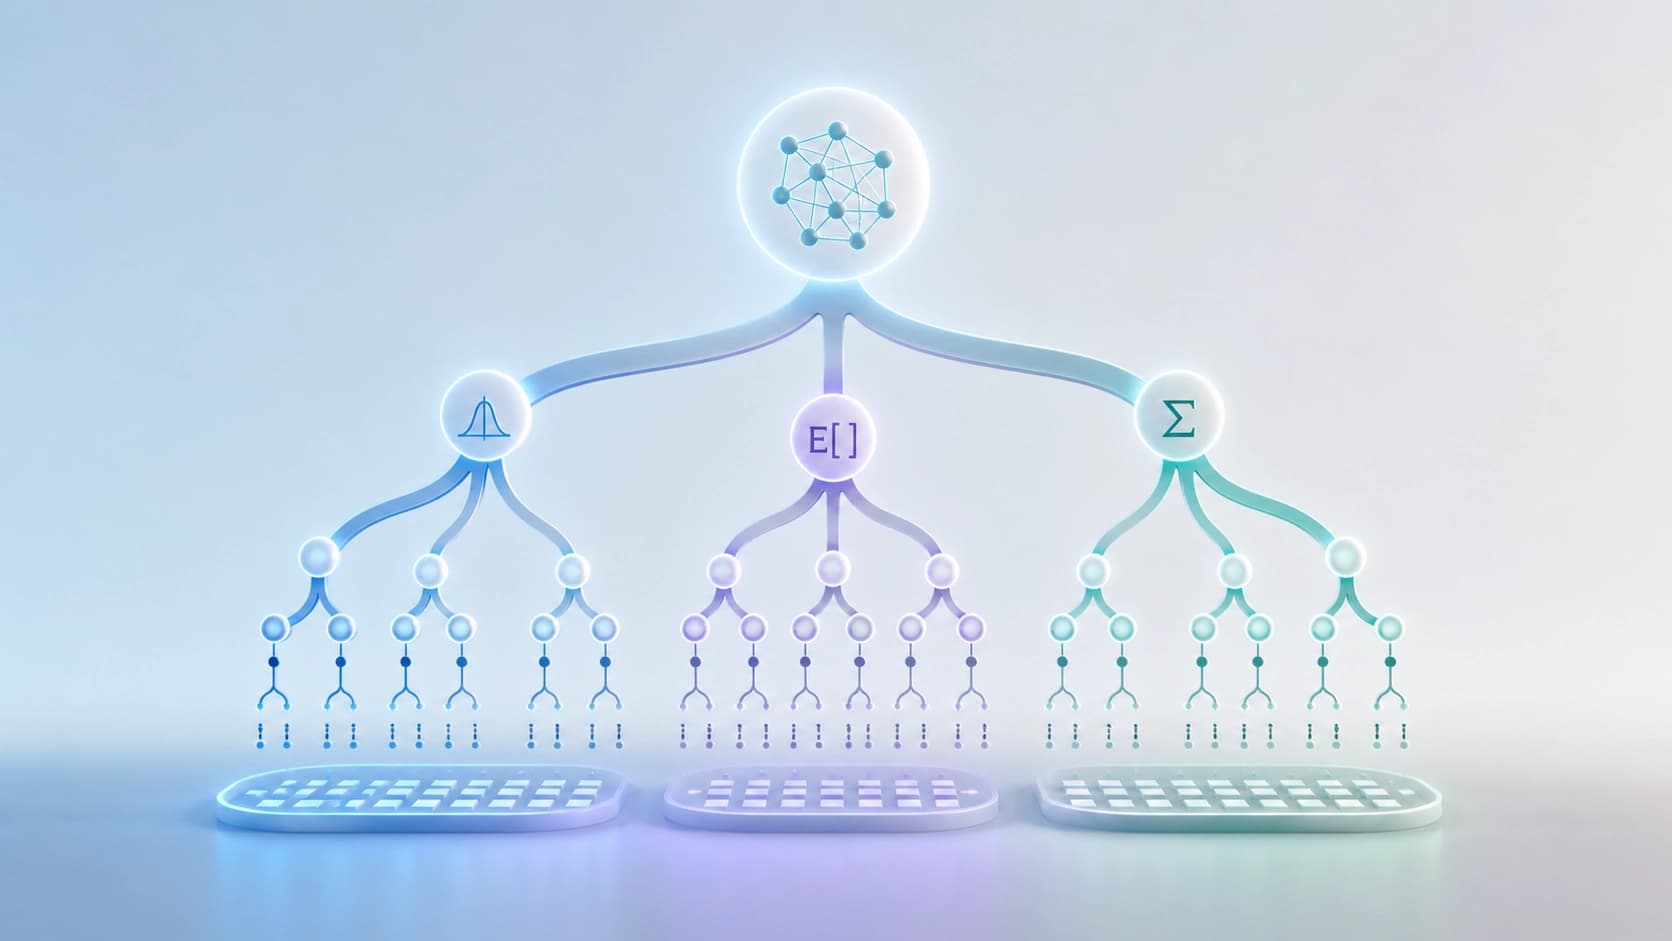
La principale trouvaille technique du travail est un arbre syntaxique abstrait (AST) adapté. La formule identifiée issue de pyAgrum n'est pas calculée « de front » : elle est décomposée en un arbre, et les feuilles de cet arbre deviennent des sous-tâches indépendantes de trois types — calcul de densité, calcul d'espérance mathématique et marginalisation.
Pourquoi est-ce important ? Les sous-tâches obtenues peuvent être calculées en parallèle et les résultats intermédiaires mis en cache. Au lieu d'une seule expression lourde, où une erreur à une étape précoce gâche tout ce qui suit, on obtient un ensemble de morceaux indépendants, chacun vérifiable séparément. En substance, les auteurs transforment un problème de puissance de calcul en un problème d'organisation des calculs.
Vérification sur Project STAR
Comme exemple concret, l'expérience STAR (Student-Teacher Achievement Ratio), menée en 1985 dans l'État du Tennessee, aux États-Unis, est utilisée. C'est un jeu de données hiérarchique de référence : il a été créé pour évaluer l'influence de la taille des classes sur les résultats scolaires, et les observations y sont imbriquées dans des classes. Une telle structure est un terrain d'essai idéal pour les HSCM, car l'intervention s'y produit naturellement au niveau de la classe, et non de l'enfant individuel.
Avant de passer aux données réelles, les auteurs testent le pipeline sur des motifs canoniques de HSCM et des scénarios de référence où la réponse correcte est connue à l'avance. C'est un ordre raisonnable : s'assurer d'abord que la méthode trouve la bonne réponse là où on la connaît, et seulement ensuite l'appliquer à des données où il n'y a rien à vérifier. L'application finale porte sur les résultats en mathématiques à l'école maternelle dans le cadre de STAR.
Ce qu'ont montré les résultats
Les conclusions se sont révélées sobres, et c'est là leur valeur.
Premièrement, les modèles de base à plat, ignorant la hiérarchie, reconstituent bien les associations — mais sont incapables de coder une intervention au niveau de la classe. La corrélation « classe plus petite — notes plus élevées » et l'effet causal d'une réduction de la taille des classes sont deux choses différentes, et la première ne remplace pas la seconde.
Deuxièmement, une identification symbolique seule ne suffit pas. Même si la formule est correctement déduite, une couche numérique fonctionnelle est nécessaire pour une inférence hiérarchique pratique.
D'où la troisième thèse : l'estimation scalable et les contrôles de stabilité numérique ne sont pas un complément à la méthode, mais sa partie centrale. Une belle expression, impossible à calculer ou qui s'effondre à la moindre variation des données, n'a aucune valeur scientifique. C'est pourquoi le pipeline accorde autant d'attention à la décomposition des calculs et au contrôle de la robustesse.
Pourquoi c'est utile au-delà de STAR
Les données hiérarchiques sont bien plus fréquentes qu'on ne le pense. Éducation, médecine, tests A/B avec clustering, sondages par régions, mesures industrielles par lots — partout il y a de l'imbrication, et partout il y a la tentation de l'ignorer par souci de simplicité.
La valeur du travail réside dans le fait qu'il propose non pas une astuce isolée, mais une procédure reproductible. Code ouvert, identification automatique via pyAgrum, passage formel à des formules calculables, sous-tâches indépendantes — tout cela ensemble abaisse le seuil d'entrée : le chercheur n'a pas besoin de déduire lui-même les formules pour chaque nouvelle structure de graphe.
Limites et bon sens
Il faut garder à l'esprit qu'il s'agit d'un preprint, et non d'une publication ayant fait l'objet d'une relecture par les pairs : arXiv:2608.24500 en version v1, DOI 10.48550/arXiv.2608.24500. Les résultats sur des motifs canoniques et un seul jeu de données constituent un bon test, mais pas une preuve universelle.
En outre, toute inférence causale repose sur des hypothèses concernant la structure du graphe. Le pipeline automatise les calculs et les rend plus transparents, mais il ne supprime pas la question « avons-nous bien décrit le monde ». Si le graphe est erroné, un effet soigneusement calculé restera malgré tout une erreur soigneusement calculée.
C'est précisément pourquoi la conclusion pratique principale de l'article est terre à terre : l'identification sans estimation est inutile, l'estimation sans robustesse est risquée, et les données imbriquées exigent un niveau distinct dans le modèle, faute de quoi les interventions au niveau des groupes n'ont tout simplement rien à quoi être rattachées.


