
Récompense vérifiable et son angle mort
L'apprentissage par renforcement fondé sur des récompenses vérifiables est devenu une recette familière pour les modèles de langage : il y a une tâche dont la réponse est vérifiable sans ambiguïté — mathématiques, code, questions à réponse courte — et il y a un signal « résolu / non résolu ». Le schéma fonctionne, mais il présente une faiblesse connue. La récompense finale évalue le résultat dans son ensemble, et non le chemin qui y mène. Le modèle peut obtenir un point pour une conclusion correcte bâtie sur des prémisses inventées, et tout aussi bien perdre un point pour un raisonnement correct avec une formulation finale malheureuse.
C'est précisément là que réside le risque d'hallucinations. Si la récompense ne dépend que de la correspondance finale, la politique n'a aucune incitation à être rigoureuse en chemin — il suffit de deviner la réponse. L'un des moyens d'y remédier consiste à ajouter un contrôle factuel au niveau du processus : vérifier les affirmations intermédiaires, et pas seulement le résultat.
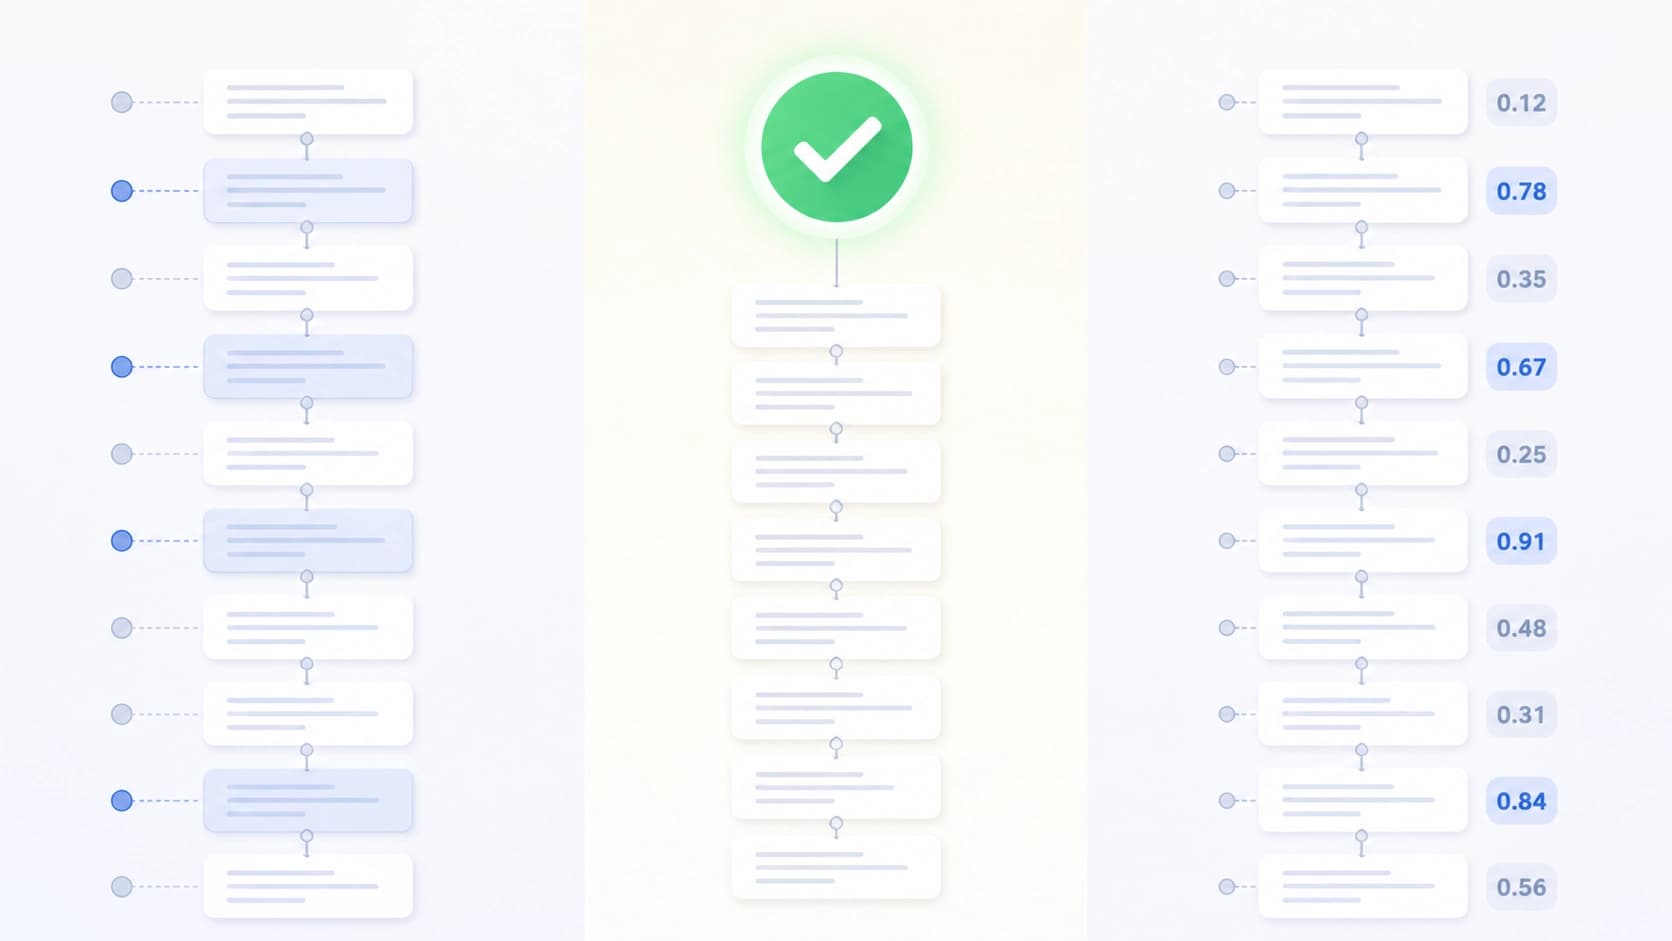
Mais l'approche au niveau du processus révèle son propre problème. Les vérifications de faits sont collectées et moyennées de manière agrégée : le signal arrive en bloc pour tout le fragment, et la fiabilité des vérifications elles-mêmes n'est évaluée par personne. Il en résulte un écart entre ce qui a réellement été vérifié et ce qui a réellement été mis à jour dans la politique.
Deux ambiguïtés au lieu d'un seul problème
Les auteurs du travail arXiv:2608.24350 (Qiming Xie, Wenjie Zheng, Xiangqing Shen, Rui Xia) donnent un nom à cet écart — « attribution de crédit factuel bruitée » (noisy factual credit assignment) — et le décomposent en deux aspects indépendants.
- Ambiguïté de localisation du crédit. On ne sait pas à quel token ou fragment précis attribuer le mérite ou le blâme. Le fait a été vérifié au niveau de la phrase, mais la mise à jour se fait au niveau du token — les granularités ne coïncident pas, et le signal se dilue.
- Ambiguïté de fiabilité du crédit. On ne sait pas dans quelle mesure la vérification elle-même est digne de confiance. Certains jugements factuels sont fiables et reproductibles, d'autres sont fragiles, dépendent du contexte ou d'une formulation particulière. Sans poids de confiance, ils entrent dans l'apprentissage à égalité de droits.
Le second aspect est le plus sous-estimé. Les schémas habituels de traitement des signaux factuels se comportent comme si toutes les vérifications étaient de qualité égale. En pratique, ce n'est pas le cas, et les vérifications faibles se mettent à corrompre l'optimisation au même titre que les fortes.
Comment FARCA est structuré
FARCA signifie Fact-Aligned Reliability-Aware Credit Assignment — attribution de crédit alignée sur les faits et tenant compte de leur fiabilité. Ce n'est ni un nouveau modèle ni un jeu de données, mais un cadre d'optimisation de politique : il reconfigure la manière dont le contrôle factuel se transforme en signal d'apprentissage.
Aligner les granularités
La première étape est une localisation fine du crédit. L'idée est simple à énoncer et non triviale à mettre en œuvre : la granularité de la vérification des faits doit être mise en correspondance avec la granularité des mises à jour de la politique. Ainsi, le signal factuel n'arrive plus « en moyenne sur toute la réponse », mais est rattaché aux tokens précis qui sont réellement responsables de cette affirmation. Au lieu d'un moyennage diffus, la politique reçoit des indications ponctuelles.
Évaluer dans quelle mesure la vérification est digne de confiance
La deuxième étape est celle des poids de fiabilité. Pour les calculer, les auteurs introduisent une attribution contrefactuelle des preuves (counterfactual evidence attribution) : ils observent dans quelle mesure le jugement factuel dépend du fragment de preuve clé. Si l'on retire ou remplace cette preuve et que le verdict change — alors la vérification s'appuie réellement sur elle, et un tel signal mérite une plus grande confiance. Si le verdict reste le même indépendamment de la preuve, le jugement ne porte probablement pas sur ce que nous croyons — et son poids diminue.
Les poids obtenus modulent ensuite les récompenses factuelles et les avantages locaux de la politique. Le sens pratique : les signaux potentiellement peu fiables obtiennent une voix plus faible lors de la mise à jour, plutôt que d'être bloqués complètement. C'est un filtrage doux plutôt qu'une élimination stricte — la politique ne perd pas d'information, mais cesse de la suivre aveuglément.
Ce que montrent les expériences
Les auteurs ont testé l'approche sur différents modèles et plusieurs benchmarks évaluant le raisonnement factuel. Le résultat annoncé est une croissance notable de la factualité tout en préservant les capacités générales de raisonnement. Cette dernière partie n'est pas moins importante que la première : les améliorations de la factualité se paient souvent par une dégradation d'autres compétences, lorsque le modèle devient plus prudent et simultanément plus faible. Ici, selon les données des auteurs, cela ne se produit pas.
Il convient de noter en particulier que la méthode reste dans le paradigme du RL à récompenses vérifiables — elle n'exige pas de renoncer au pipeline existant et ne le remplace pas par quelque chose de fondamentalement différent. Elle s'intègre comme une couche entre la vérification des faits et la mise à jour de la politique.
Ce qu'il faut en retenir
L'idée principale du travail est plus large qu'une seule architecture. La discussion sur la factualité des modèles se déroule généralement dans la logique « vérifier ou ne pas vérifier ». Mais lorsque les vérifications existent déjà, la question clé se déplace : comment précisément leur résultat se transforme en apprentissage. Une erreur à cette jonction ne ressemble pas à une erreur, elle ressemble à un bruit d'apprentissage ordinaire — et passe donc facilement inaperçue.
Reconnaître que l'on ne fait pas également confiance à toutes les sources semble presque trivial au niveau du bon sens. Mais dans les schémas d'apprentissage par renforcement, c'est encore rare : les signaux sont réunis dans un pot commun, et la différence entre une preuve fiable et une supposition aléatoire s'efface. FARCA est une tentative de réintroduire cette différence dans la formule. Dans quelle mesure l'approche sera transférable au-delà des tâches à réponse vérifiable, où un fait ne peut pas être si facilement confirmé ou infirmé, c'est une question ouverte — et c'est aussi la direction la plus intéressante pour les travaux à venir.


