
OnzeLabs à partir de zéro: enregistrement, configuration et premières étapes de text-to-speech
Étape par étape, nous traversons la création d'un compte, le choix d'un plan et le choix d'une voix dans la bibliothèque. Ensuite, nous montrons comment générer des voix off, ajuster l'expression émotionnelle et utiliser des fonctionnalités comme le clonage vocal et le doublage pour des projets.
Inscription et connexion
Pour commencer à travailler avec ElevenLabs, ouvrez le site officiel du service et cliquez sur "Essayez gratuitement" ou "S'inscrire" sur la page d'accueil. La façon la plus simple de s'enregistrer est via Google OAuth — alors vous n'aurez pas à vous souvenir d'un autre mot de passe. Si vous préférez la méthode classique, entrez votre adresse e-mail et créez un mot de passe; le système enverra un courriel avec un lien de confirmation vers votre boîte de réception. Suivez ce lien — et alors seulement votre compte est considéré actif.
Après confirmation, vous arriverez à votre tableau de bord personnel. Vous pouvez immédiatement explorer les principales sections : génération de voix, projets, doublage et autres fonctionnalités intégrées. À ce stade, vous n'avez rien à configurer — le service offrira une courte visite d'introduction seule.
Choisir un plan de tarification et une configuration initiale
Juste après s'être connecté, ça vaut la peine de décider d'un plan. ElevenLabs dispose d'un plan gratuit qui est adapté pour tester la voix off, ainsi que des abonnements payants à partir de Starter et allant jusqu'à Enterprise. Sur le plan gratuit, la limite de caractère mensuelle et l'accès à certaines fonctionnalités sont habituellement restreints, de sorte que pour un travail régulier il est préférable de passer à un niveau rémunéré approprié.
Puis allez à la bibliothèque vocale, une bibliothèque de voix prêtes à être créées par la communauté et l'entreprise elle-même. Là vous pouvez choisir une voix par sexe, âge , accent ou style de parole. Faites attention aux filtres : ils aident à restreindre la recherche si vous cherchez, par exemple, une voix masculine calme pour des instructions ou une voix féminine énergique pour une publicité.
À ce stade, il est également utile de vérifier les paramètres de synthèse de la parole. Le paramètre clé est la stabilité — le curseur de stabilité. Si vous le mettez haut, la voix sera stable et prévisible, mais elle perdra une certaine flexibilité émotionnelle. Une faible valeur ajoute vivacité et intonation variété, mais parfois conduit à des changements de timbre inattendus. La valeur optimale dépend de la tâche : les livres audio ont généralement besoin de stabilité, tandis que les dialogues ont besoin du contraire.
Créer votre première voix off
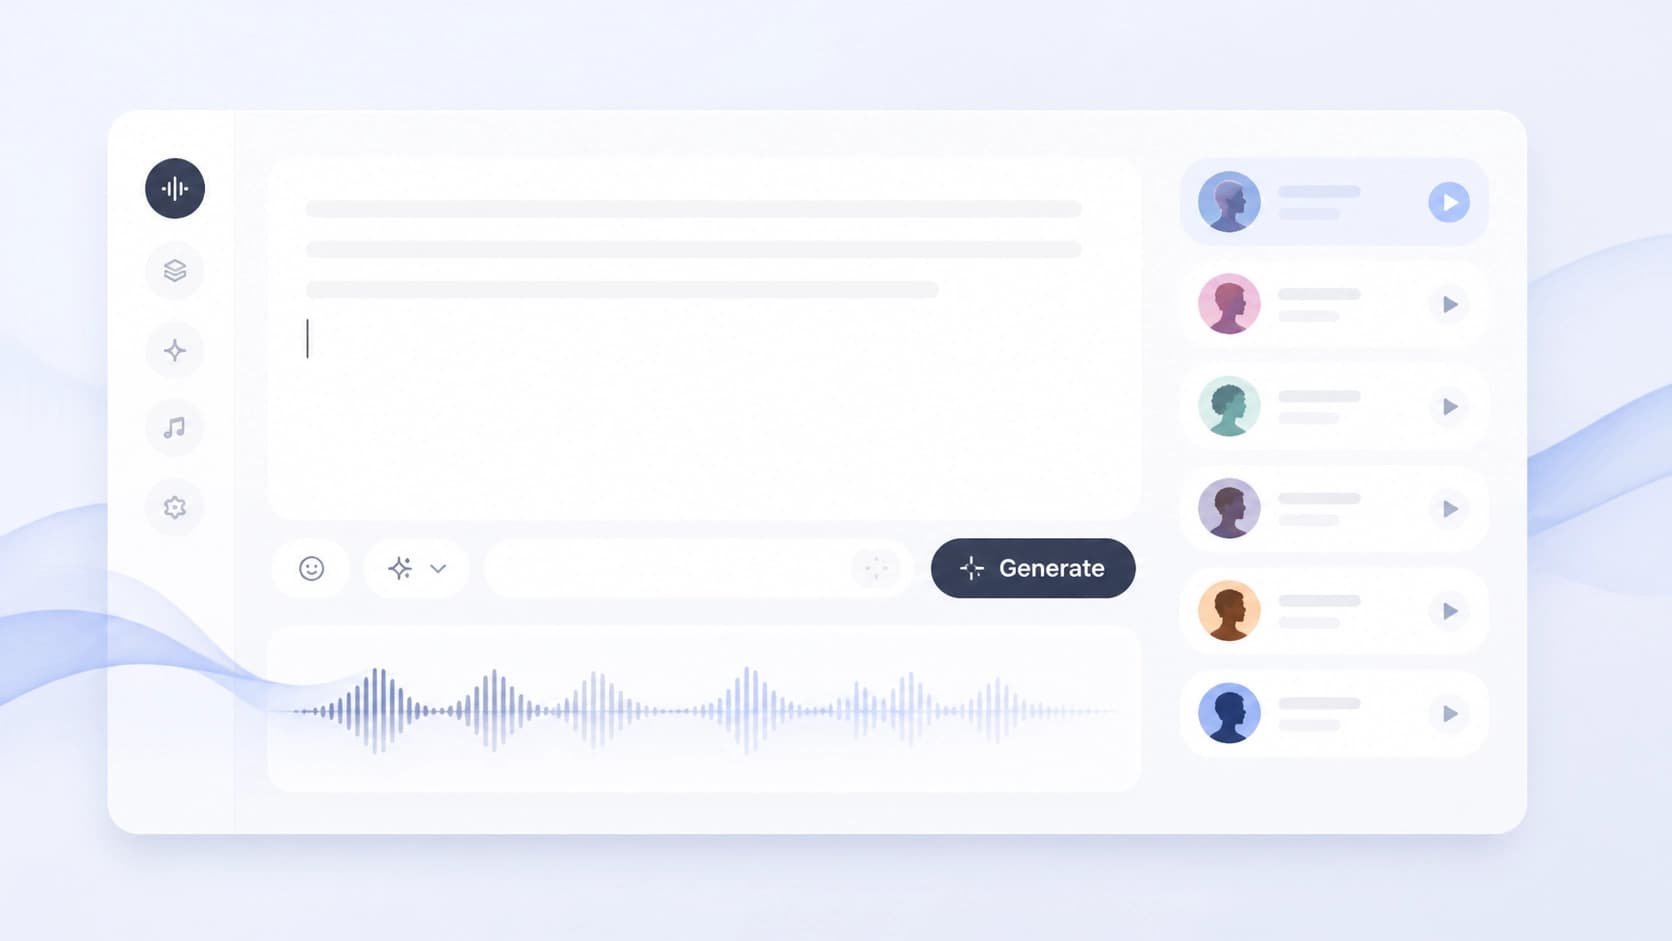
Une fois votre compte configuré et une voix sélectionnée, vous pouvez passer à à la chose principale — générer la parole à partir du texte. Dans ElevenLabs éditeur, collez votre texte dans le champ dédié, choisissez une voix que vous aimez dans la bibliothèque, et cliquez sur Générer. Dans quelques secondes, le système retournera un fichier audio fini que vous pouvez écouter directement dans le navigateur ou télécharger.
Si vous voulez obtenir un caractère unique, utilisez l'outil de conception vocale intégré. Il vous permet de configurer les caractéristiques vocales "à partir de zéro" : le sexe, l'âge, le timbre et même les caractéristiques de prononciation. Ceci est pratique pour les créateurs de contenu qui ont besoin d'une voix cohérente pour une série, podcast, ou blog vidéo.
Les utilisateurs avancés devraient prêter attention à Dubing Studio. Cette fonctionnalité est conçue pour des projets multilingues : elle traduit et voix vidéos dans d'autres langues, en essayant de préserver l'intonation originale et le ton émotionnel. Le service a également Audio Native — un plugin pour les sites Web qui lit automatiquement une version audio d'articles texte.
Conseils pratiques pour un départ confiant
Les débutants ont souvent des questions sur les quotas et la qualité. Pour éviter que votre travail ne soit interrompu au pire moment possible, gardez un œil sur le compteur de personnages dans votre tableau de bord personnel. Dans ElevenLabs, les limites de free-tier sont assez modestes, donc pour de longs projets il est préférable de passer à un plan payé à l'avance ou de répartir la génération sur des jours.
N'ayez pas peur d'expérimenter différents modèles de voix. Le même texte peut sembler complètement différent selon le modèle et les paramètres choisis. Exécutez quelques générations de tests avec le même texte et comparez les résultats — c'est la façon la plus rapide de comprendre quel son convient à votre projet.
Si quelque chose tourne mal — la voix semble déformée, le texte est lu trop vite ou trop lentement — regardez dans le Centre d'aide. Vous y trouverez des instructions pour résoudre les problèmes courants, des recommandations pour optimiser les paramètres et des réponses aux questions fréquemment posées. Il est également utile d'étudier des exemples d'autres utilisateurs dans la bibliothèque vocale : le travail d'autres personnes montre quels paramètres définir pour atteindre l'effet désiré.
Foire aux questions
Matériaux connexes
Tous matériaux
Annotation hybride des images : l’automatisation accélère l’entraînement des modèles de vision par ordinateur
L’article décrit comment le pré-étiquetage par des algorithmes réduit le travail manuel et améliore la qualité des jeux de données d’entraînement, ainsi que les raisons pour lesquelles une vérification humaine par échantillonnage reste nécessaire. Il examine les limites de cette méthode dans des conditions de prise de vue difficiles et pour les types d’objets rarement rencontrés.
5 novembre 2026
Méthode GoldiMask pour l’ajustement fin des modèles de langage à diffusion : sélection du contexte et pondération des objectifs
Cet article présente GoldiMask, une approche de fine-tuning supervisé pour les modèles de langage à diffusion discrète, qui sélectionne les tokens visibles par maximisation approximative d’une fonction sous-modulaire et attribue des poids aux objectifs restants en fonction de leur utilité pour l’entraînement. Des expériences menées sur plusieurs modèles et jeux de données montrent une hausse de la précision moyenne, des gains sur les tâches de raisonnement logique et de programmation, ainsi qu’une réduction du nombre d’itérations de décodage parallèle sur GSM8K et MATH-500 à qualité comparable.
30 octobre 2026
Transformers a ajouté la prise en charge de l’exécution de modèles GGUF quantifiés sur Apple Silicon
L’article décrit l’intégration du format GGUF de llama.cpp dans Transformers : l’inférence locale sur Mac, le chargement de modèles via l’API de la bibliothèque et le lancement d’un serveur compatible avec OpenAI. À l’exemple de Qwen3.5-4B, il montre comment le choix du niveau de quantification influe sur la taille des poids et les besoins en mémoire.
18 octobre 2026