Le réentraînement complet n'est plus une option raisonnable
Les modèles fondamentaux pour l'électroencéphalographie sont entraînés sans annotation — sur des tâches contrastives ou sur la reconstruction de fragments de signal masqués. La logique est la suivante : le modèle acquiert les régularités générales des rythmes, des artéfacts et des transitions entre états, puis il est réentraîné pour une tâche précise comme la détection de décharges épileptiques. En théorie, cela produit des représentations qui se transfèrent entre cliniques et appareils. En pratique, c'est plus complexe : les archives cliniques d'enregistrements sont trop dissemblables les unes des autres, et la qualité du transfert chute sensiblement.
Le deuxième problème est économique. Le fine-tuning classique met à jour tous les poids, ce qui exige des ressources de calcul considérables pour chaque nouvelle tâche. Dans un service sans cluster GPU, un tel scénario n'est tout simplement pas envisageable. D'où la question autour de laquelle s'articule le travail arXiv:2608.24727 : peut-on se contenter d'une faible fraction des paramètres sans perdre en qualité ?
Neuf pour cent : ce qui est précisément ajusté
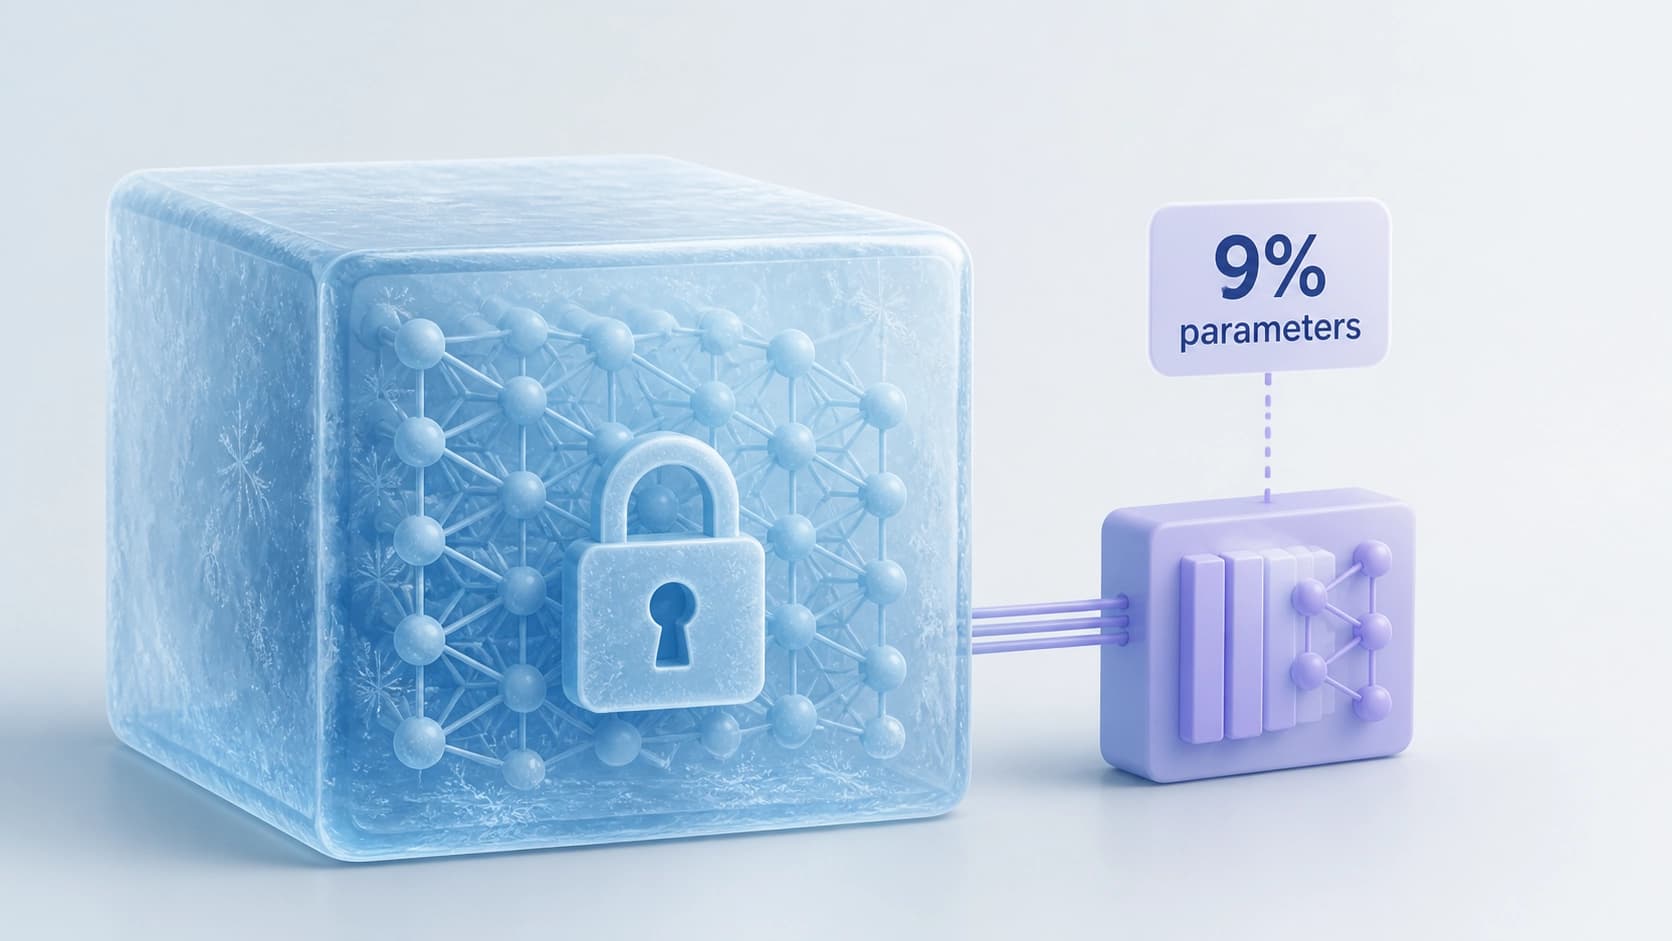
Les auteurs du preprint sont Meghal Dani et Stefanie Liebe. Ils testent un régime dans lequel environ 9 % des poids restent entraînables, le reste du modèle étant gelé. L'adaptation se fait de manière auto-supervisée : le modèle n'est pas simplement ajusté aux étiquettes de classe, mais ses représentations internes sont alignées sur la tâche cible. Le texte a été mis en ligne le 25 août 2026 (version v1), classé dans les sections cs.LG et cs.AI, DOI — 10.48550/arXiv.2608.24727. Le code est ouvert pour reproduction.
L'intérêt ne réside pas dans le fait d'obtenir un modèle « réduit ». C'est un autre mode d'exploitation : le lourd encodeur préentraîné reste inchangé, et une surcouche compacte est ajustée pour chaque nouvelle tâche. Pour une clinique, cette séparation est fondamentale — le préentraînement coûteux est réalisé une fois, l'adaptation peu coûteuse est répétée autant de fois que nécessaire.
Deux modèles avec des objectifs de préentraînement différents
Pour que le résultat ne dépende pas d'une seule architecture réussie, deux modèles SOTA participent à l'expérience : BIOT avec un objectif contrastif et CBraMod, entraîné à la reconstruction de segments masqués. Si la méthode fonctionne dans les deux cas, il ne s'agit pas d'une coïncidence, mais d'une propriété de l'approche.
Trois jeux de données cliniques et deux modes de validation
L'évaluation est menée sur TUAB (détection d'anomalies), TUEV (classification d'événements) et CHB-MIT (détection de crises). Les mesures sont effectuées deux fois — in-distribution et out-of-distribution, c'est-à-dire non seulement sur des données « familières », mais aussi sur une distribution décalée.
Ce que les résultats ont montré
- Par rapport au sondage linéaire, l'adaptation auto-supervisée apporte un gain constant — jusqu'à un facteur 20 en AUCPR. Ce n'est pas « un peu mieux », mais une différence d'un ordre de grandeur, et elle est particulièrement marquée là où une classe rare importe plus que l'accuracy globale.
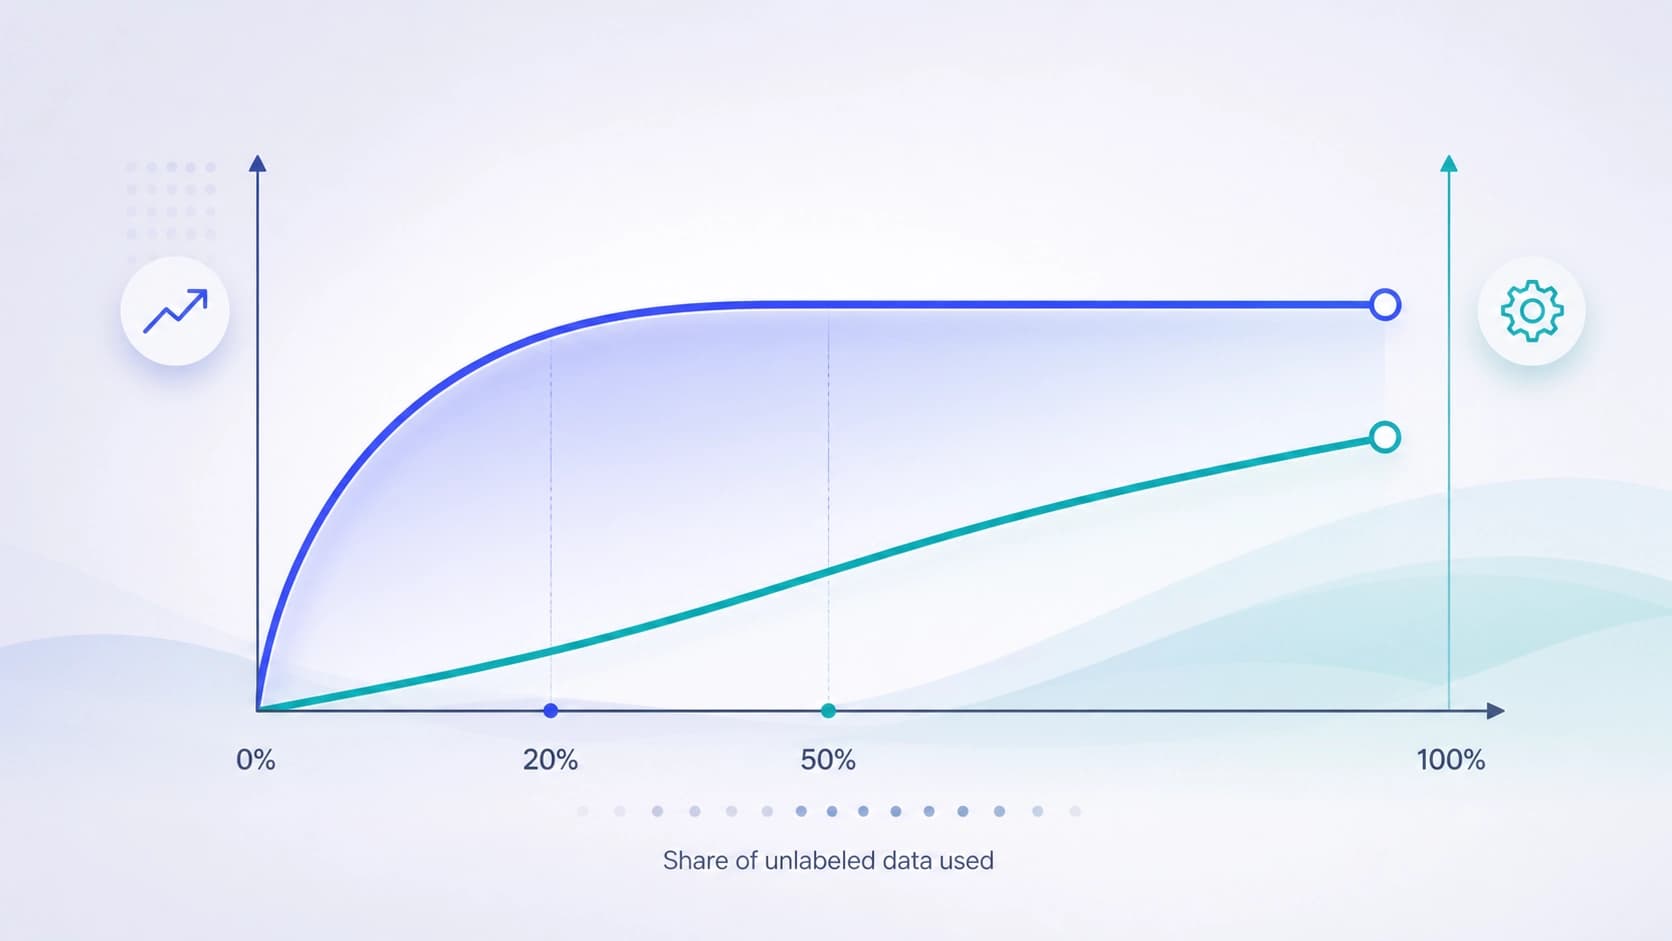
- À budget de calcul fixe, le pic est atteint avec seulement 20 à 50 % des enregistrements non annotés disponibles. Le reste du corpus n'apporte plus de gain.
- Si le nombre total de fenêtres de signal est fixé, le résultat ne dépend pas du nombre de patients inclus. Cela signifie que ce n'est pas « l'unicité des personnes » qui agit, mais la diversité temporelle des fragments : différents états, régimes et artéfacts au sein d'un enregistrement.
Ce dernier point renverse la logique habituelle de collecte de données. Intuitivement, on pense que plus il y a de patients différents, plus c'est fiable. Ici, il ressort qu'avec une limite stricte sur le nombre de fenêtres, on peut collecter des données auprès d'un moins grand nombre de personnes — il suffit de veiller à la diversité de leur signal dans le temps.
Pourquoi cela change la donne pour la clinique
Jusqu'à présent, l'adoption des modèles fondamentaux d'EEG ne butait pas sur la qualité des représentations, mais sur le budget : pour tirer profit d'un modèle, il fallait pouvoir se permettre un réentraînement complet et un grand corpus annoté. Le travail montre que cette barrière peut être abaissée des deux côtés à la fois — en calcul et en données. Neuf pour cent des poids et la moitié de l'archive non annotée au lieu de cent pour cent et de la totalité du volume.
Pour un hôpital, cela signifie un scénario plus réaliste : le modèle est préentraîné de manière centralisée, puis ajusté sur place pour une tâche précise sur un équipement modeste. Moins de dépendance à celui qui a collecté le plus d'enregistrements, et moins de coûts de stockage et de traitement d'heures de signal superflues.
Ce qu'il faut garder à l'esprit
Il ne faut pas lire ce résultat comme « neuf pour cent suffisent toujours ». C'est un régime précis issu d'une expérience précise, et non une recette universelle pour n'importe quelle architecture et n'importe quel jeu de données. Les auteurs eux-mêmes le précisent : la généralisation des modèles d'EEG reste limitée, en particulier sur des corpus cliniques hétérogènes. L'adaptation paramétrique efficace ne supprime pas le problème du transfert — elle en réduit seulement le coût d'entrée.
La conclusion pratique est plus simple qu'il n'y paraît : le débat se déplace de la question « faut-il vraiment s'engager dans les modèles fondamentaux pour l'EEG » vers celle de « comment les déployer dans un service ». Et cela relève désormais de l'ingénierie et de l'organisation des processus, pas seulement de l'apprentissage automatique.