
DiSCO : protection text-to-image contre les contenus nuisibles sans accès aux entrailles du modèle
Nouvelle méthode DiSCO fonctionne comme un module externe : elle sélectionne des invites sûres et réduit le taux de réussite des attaques red-team de 37,7 % pour les modèles non protégés et de 25,13 % pour les systèmes déjà protégés. La précision sémantique est préservée, et la cohérence des images s’améliore même.
Menace cachée dans des invites anodines
Les réseaux de neurones modernes qui génèrent des images à partir de descriptions textuelles savent créer des images impressionnantes, mais ils « produisent » parfois du contenu indésirable. Habituellement, la protection de ces systèmes repose sur une intervention dans leur fonctionnement interne : réentraînement de l'encodeur textuel, ajustement des poids ou traitement spécial lors de l'inférence. Cette approche est efficace tant que vous avez accès au modèle lui-même, mais elle est totalement inadaptée aux services propriétaires fermés fonctionnant en « boîte noire ».
En alternative, certains tentent d'utiliser de grands modèles de langage pour réécrire automatiquement les requêtes sous une forme sûre. Mais là encore, il y a un point faible : l'invite devient linguistiquement totalement anodine, mais en raison de la façon dont le modèle a distribué les données lors de l'apprentissage, la génération bascule quand même dans une zone nuisible. Les auteurs appellent ce mode « benign adversarial » — lorsque le texte est formellement sûr, mais que le résultat ne l'est pas.
Ce que propose DiSCO
La méthode DiSCO (Distribution-guided contrastive prompt optimization), développée par un groupe de chercheurs, propose une voie complètement différente : protéger la génération au niveau des invites, sans regarder à l'intérieur du modèle. C'est une solution strictement black-box qui fonctionne comme un module externe plug-and-play. Elle ne nécessite ni fine-tuning, ni réentraînement, ni aucune information sur les paramètres ou l'architecture du système cible.
L'idée est de modifier automatiquement le suffixe — c'est-à-dire la partie finale de l'invite — de manière à orienter la génération vers un terrain sûr. La recherche du suffixe approprié est effectuée à l'aide d'une recherche par faisceau (beam search), et la qualité des candidats est évaluée par un scoring contrastif. Pour cela, le module génère à l'avance, à l'aide du modèle cible lui-même, deux pools d'images : des images sûres et des images non sûres. En comparant les résultats de génération avec les pools de référence, DiSCO comprend dans quelle direction « pousser » le suffixe.
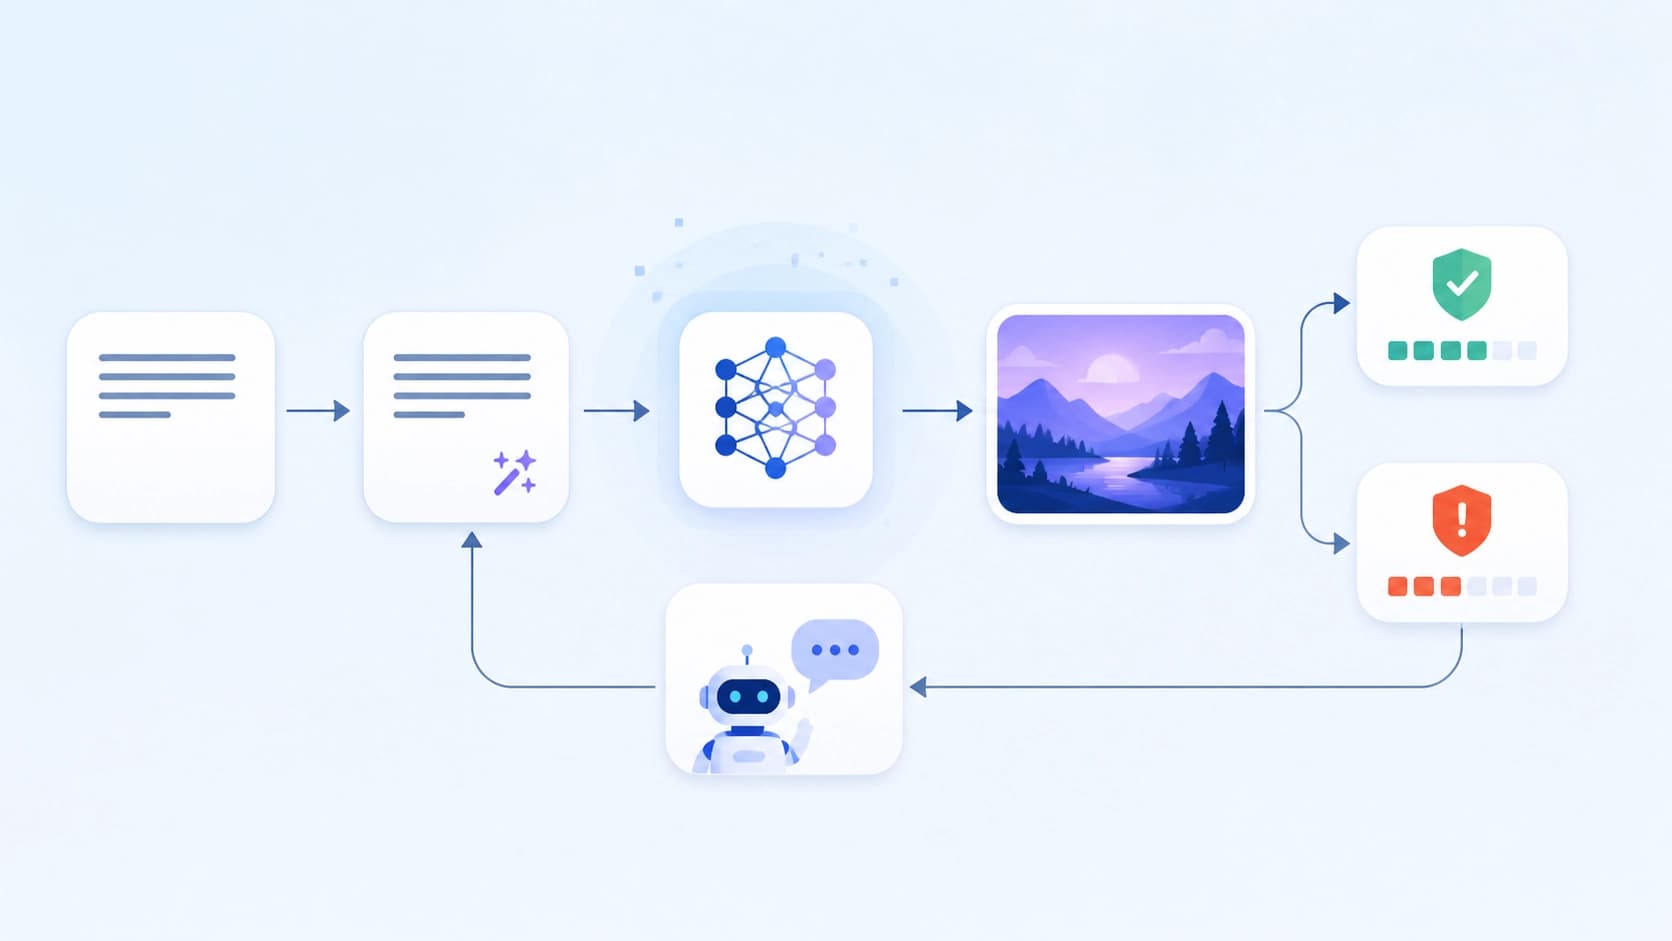
Le processus est itératif : après chaque étape, le module évalue l'image obtenue et, si elle contient encore des éléments indésirables, ajuste à nouveau le suffixe. Cela continue jusqu'à ce que la génération corresponde au pool sûr. Aucune étape ne nécessite de révéler les entrailles du modèle — toute l'interaction se fait uniquement par l'envoi d'invites et la réception d'images.
Dans quelle mesure c'est efficace
Les chercheurs ont testé DiSCO sur le benchmark I2P (Inappropriate Image Prompts) dans des scénarios d'attaques red-teaming multiples. Le résultat montre que le taux d'attaques réussies diminue de 37,7 % pour les modèles sans aucune protection et de 25,13 % pour les modèles déjà protégés par d'autres méthodes. Cela signifie que DiSCO ne se contente pas de combler les failles là où il n'y a pas de protection, mais renforce également les barrières existantes.
Il est significatif que la précision sémantique n'en souffre pas : les images générées restent pertinentes par rapport à l'invite d'origine, et la cohérence s'améliore même. En d'autres termes, le module ne dégrade pas la qualité de la génération, il l'éloigne simplement des interprétations potentiellement dangereuses.
Comme DiSCO est architecturalement agnostique, il peut être connecté à n'importe quel système text-to-image sans modifier le modèle lui-même. C'est particulièrement précieux pour les API commerciales fermées où l'accès est limité, et pour les utilisateurs qui souhaitent renforcer la sécurité de services tiers — par exemple, avant de les utiliser dans des applications publiques.
Malgré des résultats impressionnants, il faut garder à l'esprit que la méthode n'est pas une « solution miracle », mais l'une des couches de protection. Éliminer complètement les risques sera sans doute difficile, mais déplacer l'approche d'une sécurité « interne » vers une sécurité « externe » et adaptative est une étape importante vers la résilience des systèmes génératifs face aux requêtes malveillantes.
Foire aux questions
Matériaux connexes
Tous matériaux
Invariants polynomiaux canoniques pour le diagnostic des défaillances des simulateurs RL : où sont-ils vraiment utiles
Ce travail évalue la pertinence d’intégrer les lois physiques dans des modèles de dynamique entraînables : les invariants extraits des trajectoires et mis sous forme canonique à l’aide de bases de Gröbner n’apportent qu’un gain modeste en matière de prédiction, mais se révèlent très utiles pour le diagnostic — ils permettent de localiser la contrainte violée et d’identifier le paramètre erroné.
10 novembre 2026
AURA-Eval : comment vérifier qu’un agent LLM a reconnu le risque et modifié l’étape suivante
Le framework évalue le comportement des agents LLM non pas d’après leur verdict final, mais selon leur réaction au risque aux étapes clés : les trajectoires d’appels aux outils sont interrompues, puis le modèle doit poursuivre son raisonnement et son action, tandis qu’un panel de juges LLM examine la détection du risque, sa nature et la sécurité de l’étape. Sur 1 249 tâches issues de 157 trajectoires R-Judge, les actions dangereuses deviennent plus fréquentes chez 20 modèles en l’absence de voie sûre, et la levée de la supervision avant l’exécution fait basculer 52,3 % des cas initialement sûrs dans la catégorie des cas dangereux.
10 novembre 2026
Mémoire du réservoir de Chern-Simons : dynamique autonome de la connectivité et transfert de densité
L’article explique comment un réservoir conserve l’historique des signaux d’entrée à la fois dans la distribution de densité et dans les degrés de liberté géométriques. La comparaison de quatre mécanismes montre que le courant crée une composante de connectivité distincte, qui modifie la réponse ultérieure de la densité, tandis que la prise en compte de toutes les caractéristiques mesurées apporte un léger gain dans le décodage de l’ordre des impulsions.
10 novembre 2026