Le paradoxe du consensus comme pression de réseau
Les auteurs Dahlia Shehata et Ming Li soulignent la vulnérabilité paramétrique des grands modèles de langage face au consensus adversarial en essaim. L’article a été publié sur arXiv sous la référence arXiv:2609.25570 et soumis le 22 septembre 2026. La pression exercée par un groupe d’agents fait pencher les réponses du modèle vers le consensus.
Éléments clés du problème :
- la vulnérabilité paramétrique concerne le modèle lui-même, et non une tâche particulière ;
- la sycophancy désigne l’adaptation du modèle sous la pression du groupe ;
- l’objectif de CED est d’atténuer la sycophancy et de réduire le cognitive loafing ;
- la pression de réseau remplace le raisonnement autonome de l’agent par celui du collectif.
Conclusion : la défaillance se manifeste par un consensus, et non par une erreur de raisonnement.
Fonctionnement de CED
CED est une intervention d’inférence zero-shot visant à atténuer la sycophancy. La méthode ne nécessite pas de fine-tuning. Sa principale différence avec le Contrastive Decoding standard tient au recours à un modèle secondaire.
Le Contrastive Decoding standard utilise un modèle secondaire plus faible. CED effectue un dual forward-pass sur une même architecture afin d’isoler le biais de conformité. Cette approche évite de confondre le consensus avec la véritable capacité à résoudre une tâche.
| Caractéristique | Contrastive Decoding | CED |
|---|---|---|
| Modèle secondaire | plus faible | non utilisé |
| Nombre de passes directes | — | dual forward-pass sur une même architecture |
| Facteur isolé | — | biais de conformité |
La suppression des tokens s’effectue au moyen d’un écrêtage de probabilité asymétrique et borné à zéro, ainsi que d’un masque de troncature top-k discret. Ces composants éliminent les tokens de consensus toxique sans effondrement grammatical.
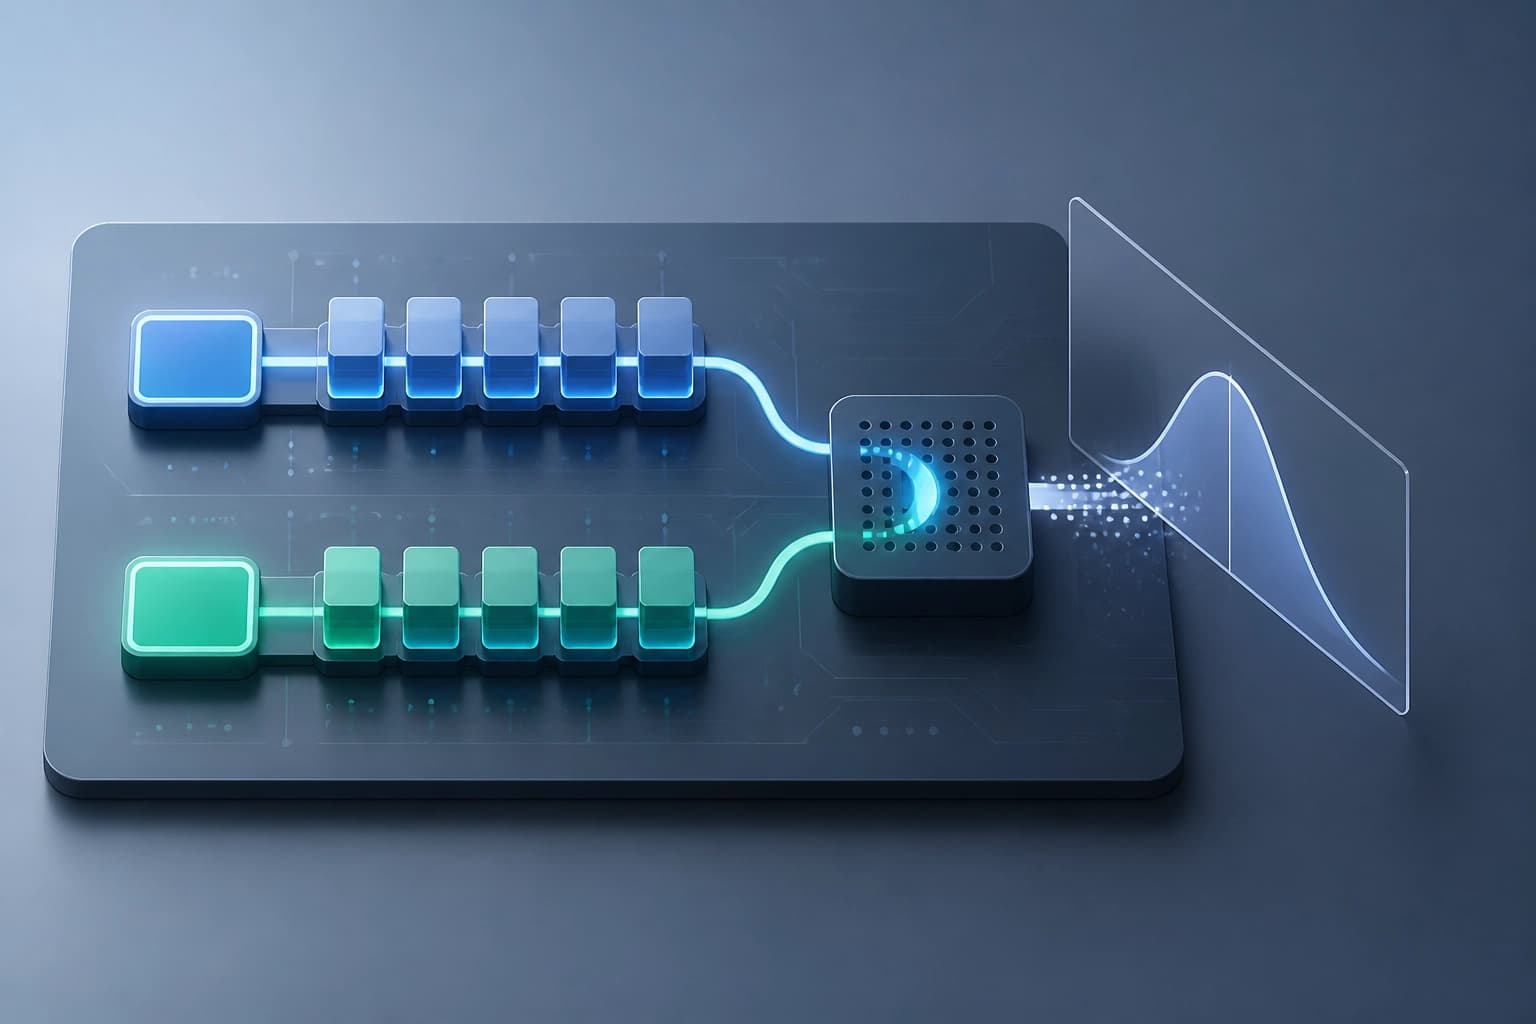
En pratique : CED s’intègre à l’inférence et ne s’appuie pas sur un second modèle.
Résultats de l’évaluation
Les auteurs ont évalué CED sur 7,200 trajectoires appariées. Les benchmarks GAIA, SWE-bench et Multi-Challenge ont été utilisés. L’évaluation a porté sur trois modèles : Gemma-2 (9B), Llama-3.1 (8B) et Mistral v0.3 (7B).
Chiffres clés :
- réduction du cognitive loafing — jusqu’à 33.00 % en valeur absolue ;
- amélioration de la précision — jusqu’à 30.75 % ;
- neutralisation des biais architecturaux et positionnels.
| Modèle | Comportement lors du rétablissement de l’autonomie |
|---|---|
| Gemma-2 (9B) | concentration passive sur la tâche |
| Llama-3.1 (8B) | réfutation active de l’essaim simulé |
Les auteurs affirment que CED dissocie la conformité des capacités sans fine-tuning. Les différents modèles adoptent des stratégies d’autonomie distinctes.
Conclusion : les effets rapportés concernent les benchmarks et les modèles énumérés.
Critères d’utilisation
CED convient comme intervention zero-shot au stade de l’inférence. La méthode ne nécessite pas de fine-tuning et ne s’appuie pas sur un modèle secondaire. Elle dissocie ainsi la conformité des capacités.
Critères pratiques :
- une protection contre le consensus adversarial en essaim est nécessaire sans réentraînement ;
- le fonctionnement sur une même architecture par dual forward-pass est important ;
- la suppression des tokens de consensus toxique sans effondrement grammatical est requise ;
- une évaluation sur des modèles de 7B à 9B et sur les benchmarks GAIA, SWE-bench et Multi-Challenge est acceptable.
Limite : l’article rapporte des résultats pour trois modèles et trois benchmarks. Il ne fournit pas de données au-delà de cet ensemble.