
Apprentissage aveugle contre décalage géographique : le pré-entraînement et l'augmentation font passer les détecteurs de trafic au niveau supérieur
Une équipe de chercheurs a assemblé un pipeline modulaire pour la reconnaissance d'objets sur les routes, qui fonctionne sans une seule image de la ville cible et sans réglage d'hyperparamètres sensibles. Deux piliers orthogonaux — le pré-entraînement avec class-agnostic objectness distillation et l'augmentation Grayworld, qui dissuade les têtes d'attention de s'accrocher aux indices de couleur, — ont permis au détecteur RF-DETR de gagner +24,29 et de décrocher la première place (47,53 mAP) dans le track de l'AI City Challenge.
La ville comme domaine à part entière
Un détecteur de voitures, de feux de circulation et de piétons, entraîné sur des enregistrements de caméras d'une seule ville, perd en précision de manière notable et prévisible lorsqu'il est transféré dans une autre ville. La cause ne réside pas dans le modèle lui-même, mais dans le fait que absolument tout change en même temps : l'éclairage et la balance des blancs des caméras, la densité du trafic, le marquage routier, les couleurs habituelles des carrosseries et même l'apparence des modèles de véhicules typiques. Formellement, on appelle cela un décalage de domaine géographique, et en pratique, c'est un casse-tête récurrent pour ceux qui déploient des systèmes de surveillance routière dans plusieurs régions à la fois.
La solution classique est l'adaptation de domaine. Mais elle a un inconvénient désagréable : elle exige presque toujours soit un réglage fin de l'architecture, qui s'effondre au moindre changement d'hyperparamètres, soit un accès direct aux données de la ville cible — leur profilage, l'ajustement des seuils en fonction de celles-ci, l'analyse des statistiques. Et c'est là que commencent des contraintes qui ne sont pas du tout de nature technique.
Ce que signifie un cycle d'apprentissage « aveugle »
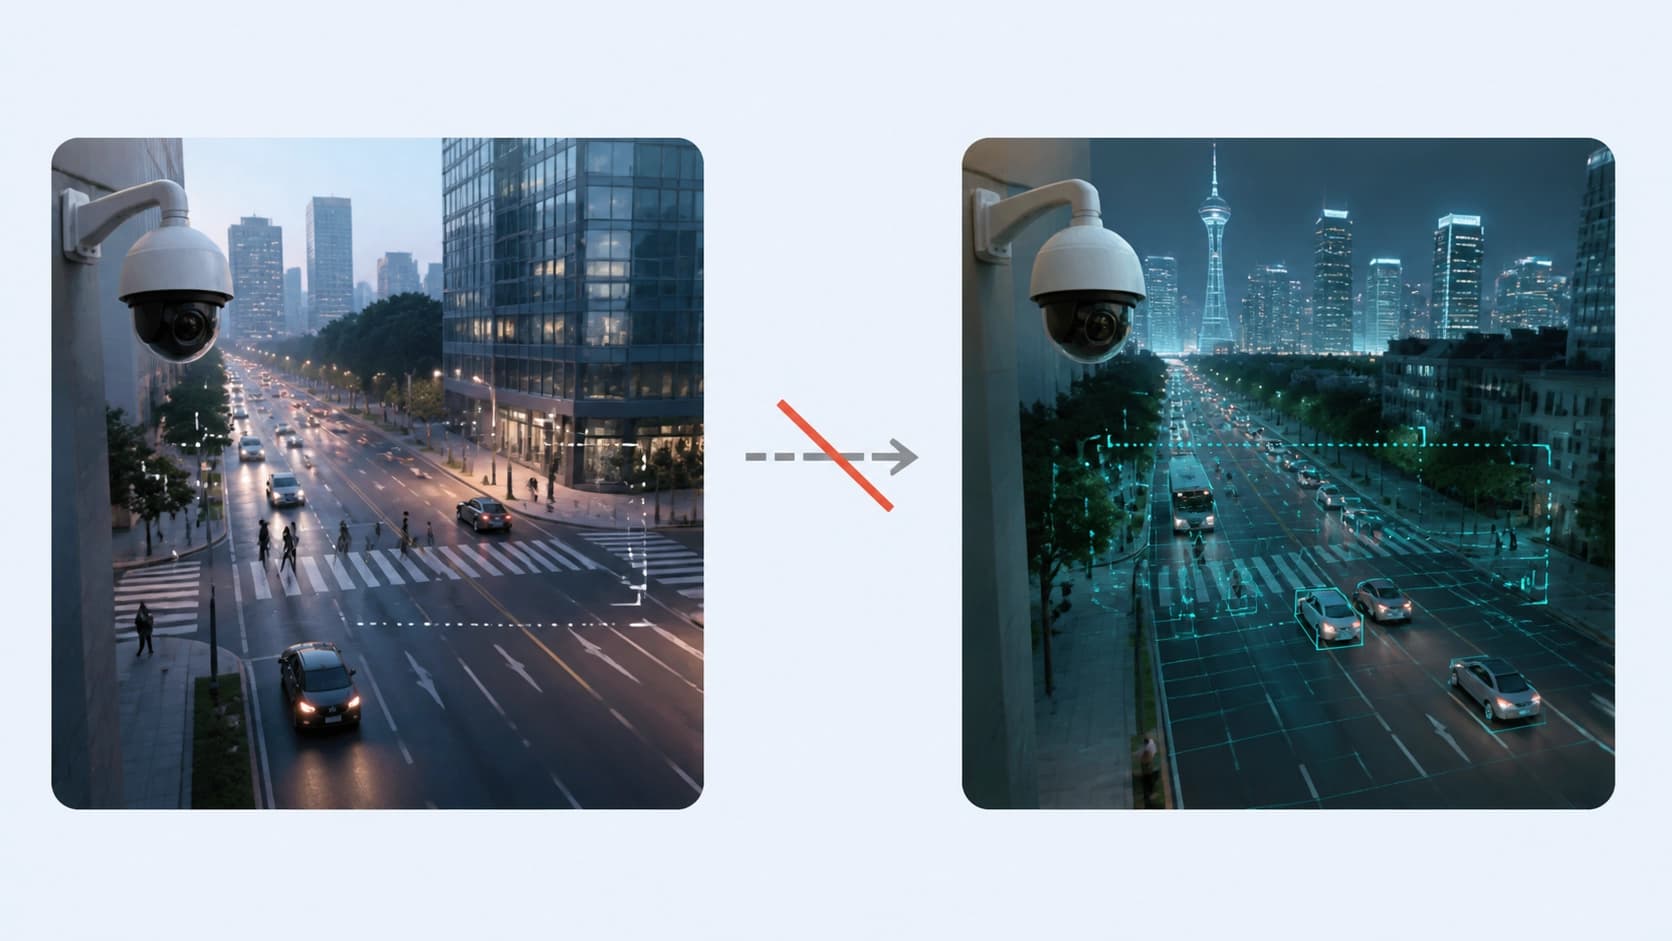
Dans les écosystèmes où les données sont considérées comme des informations sensibles, les deux voies habituelles sont fermées par définition. On ne peut pas exporter des images de la ville cible vers un banc de recherche, on ne peut pas établir de statistiques à partir de celles-ci, on ne peut pas ajuster le modèle sur celles-ci. Il ne reste qu'un mode entièrement « aveugle » : l'entraînement et l'évaluation se déroulent sans un seul exemple cible, et la vérification de la qualité n'est possible que là où l'annotation existe déjà et n'a pas quitté le périmètre sécurisé.
C'est précisément dans ce cadre que les auteurs d'un nouveau travail ont posé leur problématique. Ce qui les intéresse, ce n'est pas une énième couche d'adaptation astucieuse, mais une question plus simple et plus intéressante : combien peut-on tirer de ce qui existe déjà — du pré-entraînement et de l'augmentation — si l'on renonce à toute manipulation des données cibles.
Deux piliers orthogonaux
Le schéma d'apprentissage proposé pour la détection d'objets repose sur deux mécanismes indépendants. Le mot « orthogonaux » est ici essentiel : ils ne se dupliquent pas et attaquent différentes sources d'erreur — l'un travaille sur la sémantique et la structure de l'objet, le second sur ce à quoi s'accroche l'attention du modèle.
Pré-entraînement sur plusieurs jeux de données avec objectness distillation
Le premier pilier est une stratégie de pré-entraînement sur plusieurs ensembles de données à la fois, avec ce que l'on appelle la class-agnostic objectness distillation. L'idée est de dissocier deux choses qui sont collées dans l'apprentissage habituel : la géométrie structurelle du véhicule et les taxonomies sémantiques.
En termes simples, le modèle apprend d'abord à répondre à la question « y a-t-il ici un objet de forme caractéristique ? », sans se soucier de la manière dont cet objet est nommé dans un jeu de données particulier. C'est important, car les taxonomies divergent entre les ensembles de données et entre les villes : ici une classe distincte pour les fourgons, là tout est regroupé dans « vehicle », et les frontières entre voitures particulières et camions sont définies différemment. Si le modèle s'appuie sur une géométrie stable plutôt que sur des conventions locales d'étiquetage, le changement de ville l'affecte moins.
Grayworld : forcer l'attention à renoncer à la couleur
Le second pilier est un flux d'augmentation robuste au domaine, auquel s'ajoute une nouvelle transformation appelée Grayworld. Sa tâche est de couper le sol sous les pieds du modèle là où il a l'habitude de tricher.
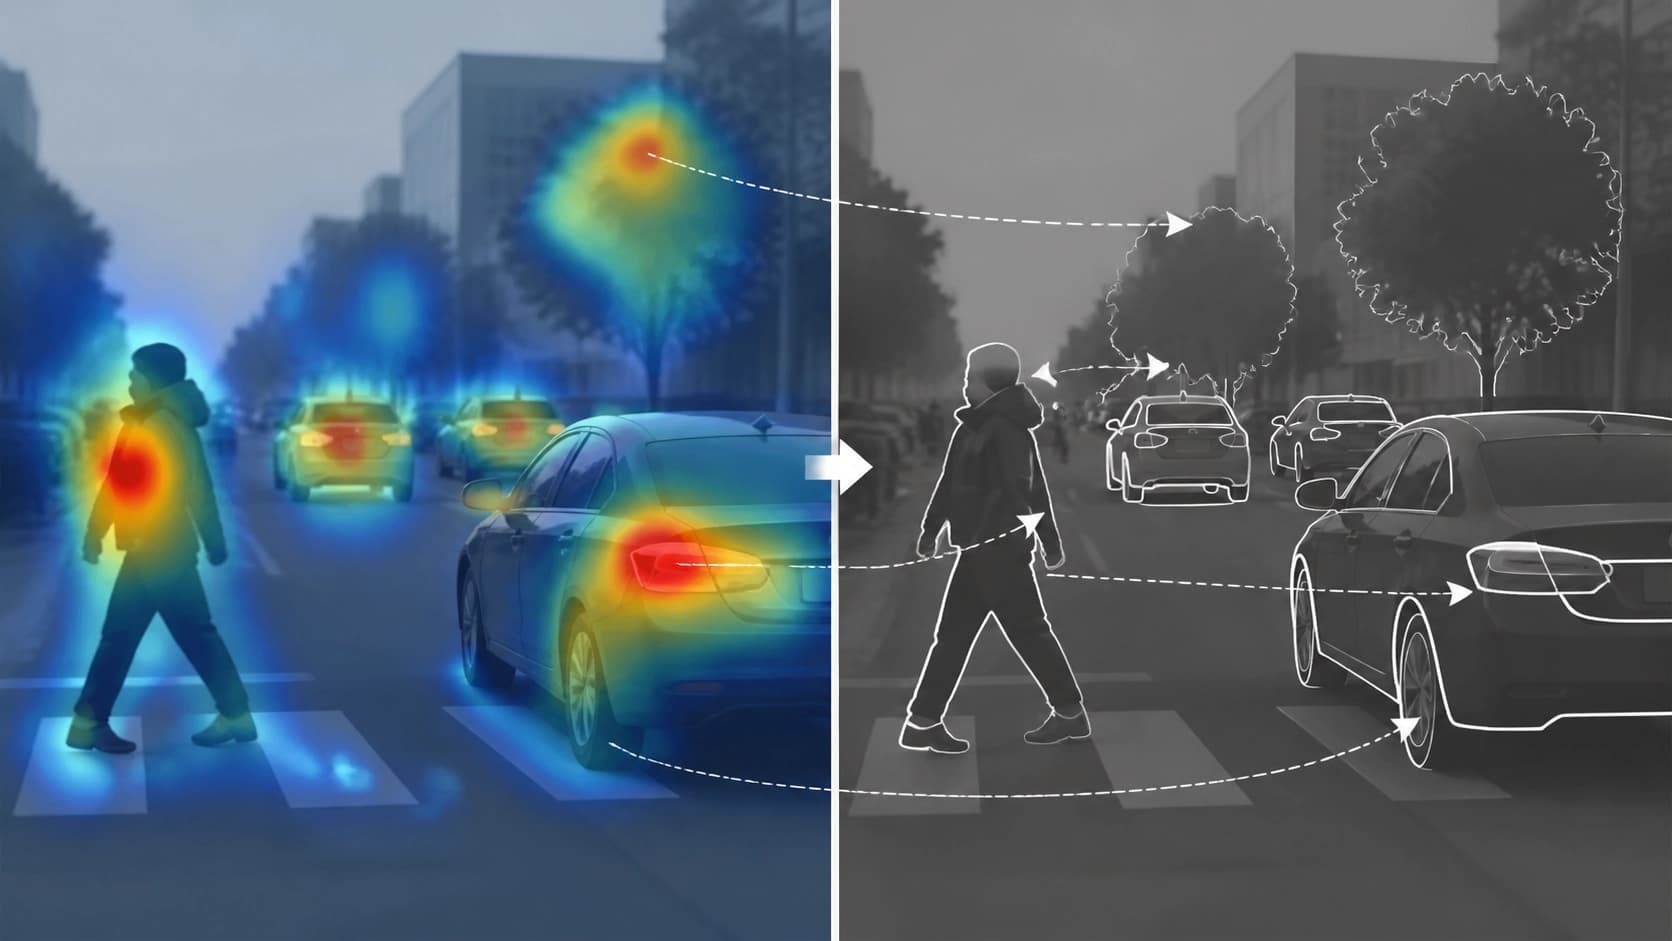
Les détecteurs empruntent souvent des « raccourcis » : ils associent la classe d'un objet à sa couleur. Une voiture jaune — un taxi, une silhouette rouge — un type de transport particulier, une teinte spécifique du ciel ou de l'asphalte — le signe d'une caméra ou d'un moment de la journée précis. Au sein d'une même ville, ces indices fonctionnent, mais lors du transfert vers une autre région, ils s'effondrent, car le rendu des couleurs, la lumière et les couleurs usuelles y sont différents. Grayworld écrase précisément ces étiquettes chromatiques, forçant les têtes d'attention globales à s'appuyer sur des représentations a priori stables de la forme. La couleur cesse d'être une preuve, la géométrie — demeure.
Expériences et résultat
L'évaluation a été menée sur le détecteur transformer temps réel RF-DETR. Les auteurs soulignent particulièrement que toute la construction tient dans un budget mémoire GPU modeste — 16 Go, c'est-à-dire reproductible sur une station de travail ordinaire, et non uniquement sur un cluster.
Les variantes optimisées RF-DETR-HR et RF-DETR-Grayworld ont apporté un gain de +24.29 par rapport au niveau de base et ont pris la première place du classement de l'AI City Challenge Track 6 avec un score de 47.53 mAP. Ce n'est plus « un peu mieux que la baseline » — c'est la différence entre un détecteur presque inutile dans une nouvelle ville et un détecteur qui y fonctionne.
Le travail a été accepté au workshop AI City Challenge dans le cadre de la conférence ECCV 2026 ; le préprint est disponible sous la référence arXiv:2608.24154 (cs.CV, cs.AI), et le code ainsi que les données sont publiés dans le dépôt SKKUAutoLab/aic26_cross_city.
Ce que les praticiens devraient en retenir
Quelques conclusions utiles au-delà du benchmark spécifique.
- L'augmentation n'est pas de la cosmétique. Elle peut délibérément briser des corrélations indésirables si l'on comprend à quoi le modèle s'accroche précisément. Grayworld est un exemple d'outil étroit mais précis contre les raccourcis chromatiques.
- Le pré-entraînement peut être conçu pour le transfert. L'objectness class-agnostic et la dissociation de la géométrie et de la taxonomie sont une approche utile partout où les classes sont décrites différemment selon les jeux de données.
- Le protocole « aveugle » est une formulation honnête, pas une limitation. Si la méthode ne regarde pas les données cibles, son résultat témoigne d'une robustesse réelle et non de la qualité d'un ajustement.
- Le budget mémoire fait partie du résultat. L'exigence de 16 Go rend l'approche applicable en pratique d'ingénierie, où l'on ne dispose pas toujours d'un matériel haut de gamme.
La prudence reste de mise : les conclusions ont été obtenues sur une seule famille de détecteurs et un seul track de compétition, et Grayworld reste une heuristique, pas une garantie. Le décalage géographique demeure un problème sans solution universelle unique, mais il est désormais clair qu'une part significative du progrès s'obtient avant même que le modèle ne voie pour la première fois une nouvelle ville.
Foire aux questions
Matériaux connexes
Tous matériaux
Toollery : sélection d’outils pour agents LLM parmi des dizaines de milliers d’options sans réentraînement
Toollery construit un index de recherche à partir des descriptions des compétences et des outils, puis ne transmet au modèle qu’un nombre limité de candidats pour chaque requête. Lors d’expériences menées sur des bibliothèques comptant jusqu’à plusieurs dizaines de milliers de fonctions, cette approche permet de maintenir la qualité de sélection avec un top-K fixe, même si l’effet final dépend du profil de charge et de la mise en cache côté fournisseur.
11 novembre 2026
Diagnostic étape par étape des agents GUI lors de l’analyse de tableaux de bord : benchmark DashAct
Découvrez DashAct, un benchmark de 348 trajectoires vérifiées par des humains, qui décompose le travail des agents GUI avec des panneaux interactifs en trois étapes et quatre conditions visuelles. Les résultats révèlent des difficultés persistantes à prédire les actions et à les ancrer sur des cibles visuelles, ainsi que la dépendance des réactions des agents à l’égard du soutien contextuel et spatial.
11 novembre 2026
WILSON : regroupement des grossissements et des lames du patient pour l’analyse pathomorphologique et la rédaction de comptes rendus
La prépublication présente WILSON, un modèle vision-langage qui encode des images de lames entières ainsi que des séries de prélèvements d’un même patient à différents grossissements, plutôt qu’une seule lame « optimale ». Sans entraînement supplémentaire pour une tâche donnée, il surpasse des modèles spécialisés et de plus grande taille dans plusieurs métriques, tout en nécessitant beaucoup moins de ressources de calcul, et ses descriptions diagnostiques ont obtenu de meilleures évaluations de la part des pathologistes.
11 novembre 2026