
Les agents IA peuvent-ils vraiment créer quelque chose de nouveau : une revue de la recherche sur les solutions algorithmiques
Les auteurs de l'étude ont examiné comment les méthodes créées par des agents LLM se comparent aux développements humains : dans de rares cas, les agents atteignent ou dépassent le niveau humain, mais presque toutes leurs solutions restent dans le cadre d'approches algorithmiques déjà connues et reprennent souvent des méthodes existantes.
О чём исследование
Un agent IA peut-il inventer de lui-même une nouvelle méthode pour résoudre un problème complexe — ou se contente-t-il de réarranger des fragments de solutions déjà connues ? C'est à cette question qu'est consacré le récent travail « When AI Designs AI: Innovation or Imitation? » (arXiv:2608.17471), dont les auteurs sont Yikang Yang, Zhengxin Yang, Luzhou Peng et leurs collègues. L'équipe scientifique a soumis l'article le 18 août 2026 ; il touche à deux sections à la fois : cs.AI et cs.LG.
Les auteurs partent d'une idée simple mais importante : il ne suffit pas de montrer que l'agent a réussi la tâche. Encore faut-il comprendre à quel point son approche était originale. C'est pourquoi le travail formule deux questions :
- les méthodes proposées par les agents fonctionnent-elles réellement aussi bien que les méthodes humaines ;
- ces méthodes se distinguent-elles par leur structure algorithmique de ce que les humains créent habituellement.
Comment l'analyse est structurée
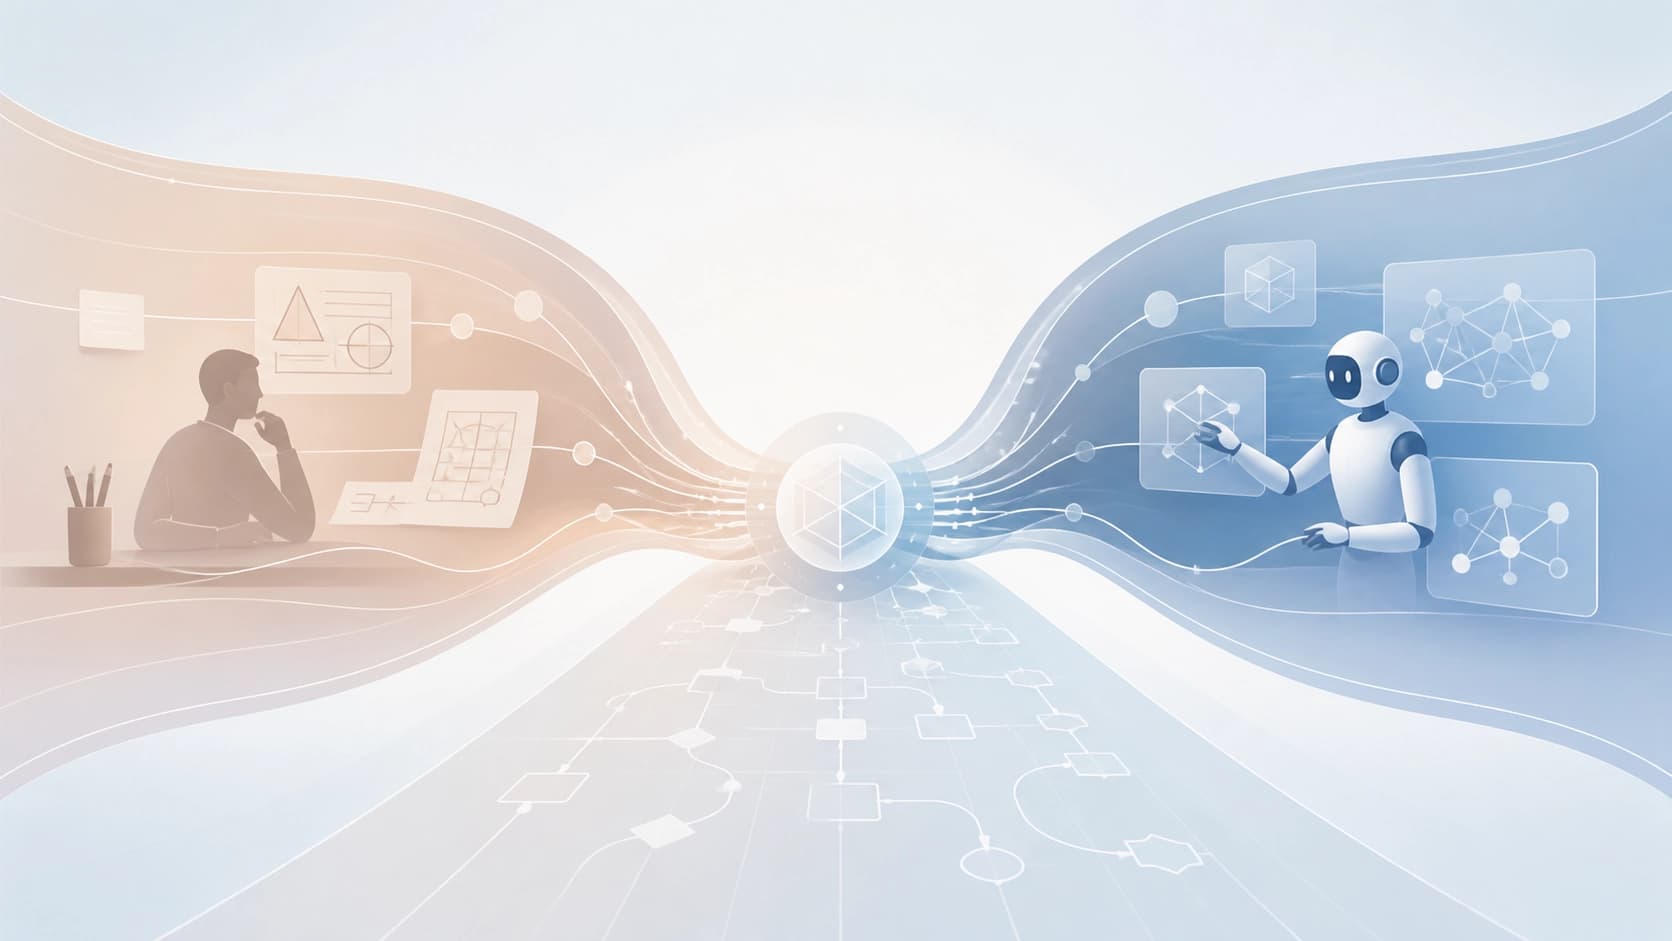
Pour répondre à ces questions, les chercheurs ont construit un cadre spécial. D'abord, à partir d'un ensemble de méthodes humaines pour une tâche donnée, sont dérivés ce qu'on appelle des espaces de conceptions algorithmiques — c'est-à-dire l'ensemble des modules typiques et des liens entre eux, caractéristiques des solutions imaginées par les humains. Dans ces espaces sont ensuite projetées les méthodes humaines comme celles des agents. La différence entre elles est mesurée au niveau des modules individuels — ce qui permet de voir quelles parties de la solution coïncident et lesquelles émergent de nouveau.
L'expérience a été menée sur plusieurs agents LLM largement utilisés et sur une sélection de tâches d'IA ouvertes, couvrant différentes modalités : texte, images, etc. Pour chaque méthode générée par les agents, deux paramètres ont été évalués : la qualité de résolution de la tâche et le degré de différence algorithmique par rapport aux équivalents humains.
Ce que cela apporte en pratique
Une telle approche ne permet pas seulement de dire « l'agent a gagné » ou « l'agent a perdu », mais de séparer la réussite de la nouveauté. Un système peut produire un excellent résultat tout en copiant intégralement un schéma connu. Et inversement — proposer une conception inhabituelle qui fonctionne moins bien. C'est précisément cette dualité que les auteurs ont cherché à saisir.
Ce que les résultats ont montré
La première partie des résultats est encourageante : dans certains cas, les agents modernes atteignent le niveau du state-of-the-art humain et le dépassent même. Dix configurations réussies de ce type ont été trouvées sur 72. Cependant, il n'y a pas de stabilité : le succès ne se transpose de manière fiable ni à d'autres tâches, ni à d'autres agents. En d'autres termes, un agent qui a brillamment réussi une tâche peut totalement échouer sur une tâche voisine — on ne voit pas encore de régularité permettant de prédire le succès.
La deuxième partie s'est révélée bien plus révélatrice. Presque toutes les méthodes créées par les agents — 96,8 % — tombent dans ces espaces de conceptions algorithmiques dérivés des solutions humaines. Les agents ne sortent pas de ce que les humains ont déjà imaginé ; ils combinent et réarrangent principalement des blocs algorithmiques familiers. De plus, environ la moitié des méthodes générées coïncide même exactement avec des conceptions humaines déjà existantes.
Conclusions
Les auteurs de l'étude arrivent à une conclusion double. D'un côté, les agents LLM modernes sont déjà capables de créer des solutions comparables aux meilleures réalisations humaines, et parfois même supérieures. De l'autre, il est encore trop tôt pour parler de leur « véritable » nouveauté. Presque tout ce qu'ils font consiste en une réutilisation prudente et une recombinaison d'idées algorithmiques déjà découvertes. Une véritable percée au-delà de l'espace de conception humain est une exception rare, et non la règle.
Cela ne signifie pas que les agents sont inutiles : la capacité à trouver rapidement une combinaison fonctionnelle parmi des méthodes connues est en soi précieuse. Mais si l'objectif est d'obtenir un algorithme fondamentalement nouveau, s'appuyer uniquement sur la génération actuelle d'agents, selon les résultats, n'est pas recommandé. Peut-être que la prochaine étape ne sera pas simplement un agent « plus intelligent », mais un agent entraîné à sortir consciemment des schémas connus.
Foire aux questions
Matériaux connexes
Tous matériaux
Invariants polynomiaux canoniques pour le diagnostic des défaillances des simulateurs RL : où sont-ils vraiment utiles
Ce travail évalue la pertinence d’intégrer les lois physiques dans des modèles de dynamique entraînables : les invariants extraits des trajectoires et mis sous forme canonique à l’aide de bases de Gröbner n’apportent qu’un gain modeste en matière de prédiction, mais se révèlent très utiles pour le diagnostic — ils permettent de localiser la contrainte violée et d’identifier le paramètre erroné.
10 novembre 2026
AURA-Eval : comment vérifier qu’un agent LLM a reconnu le risque et modifié l’étape suivante
Le framework évalue le comportement des agents LLM non pas d’après leur verdict final, mais selon leur réaction au risque aux étapes clés : les trajectoires d’appels aux outils sont interrompues, puis le modèle doit poursuivre son raisonnement et son action, tandis qu’un panel de juges LLM examine la détection du risque, sa nature et la sécurité de l’étape. Sur 1 249 tâches issues de 157 trajectoires R-Judge, les actions dangereuses deviennent plus fréquentes chez 20 modèles en l’absence de voie sûre, et la levée de la supervision avant l’exécution fait basculer 52,3 % des cas initialement sûrs dans la catégorie des cas dangereux.
10 novembre 2026
Mémoire du réservoir de Chern-Simons : dynamique autonome de la connectivité et transfert de densité
L’article explique comment un réservoir conserve l’historique des signaux d’entrée à la fois dans la distribution de densité et dans les degrés de liberté géométriques. La comparaison de quatre mécanismes montre que le courant crée une composante de connectivité distincte, qui modifie la réponse ultérieure de la densité, tandis que la prise en compte de toutes les caractéristiques mesurées apporte un léger gain dans le décodage de l’ordre des impulsions.
10 novembre 2026