
Cómo entrenar la segmentación del lenguaje en ecografías cuando casi no hay datos etiquetados
Los investigadores propusieron un método para adaptar el modelo a un nuevo conjunto de imágenes de ultrasonido sin acceso a los datos originales: combina el refinamiento de pseudoetiquetas, el control de calidad de los contornos y la generación sintética de imágenes en el estilo del dominio objetivo. El enfoque mejora notablemente la precisión de la segmentación incluso al comenzar con solo cinco fotogramas etiquetados.
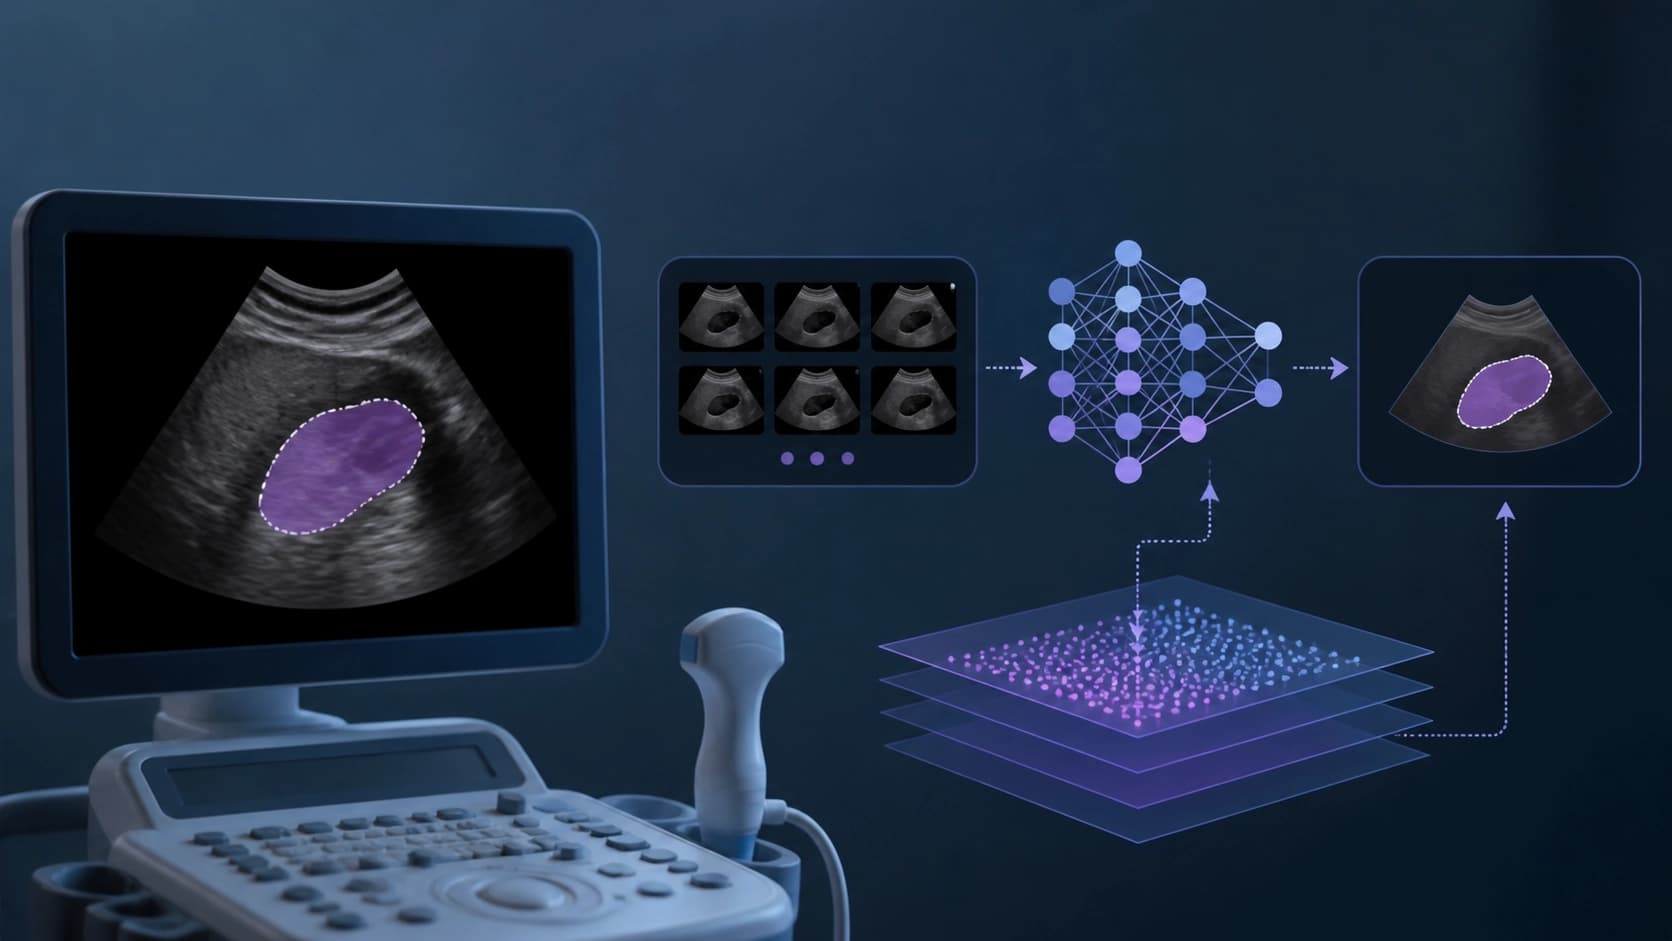
La segmentación del lenguaje en imágenes de ultrasonido es necesaria para analizar la articulación y diagnosticar trastornos del habla, pero reunir datos etiquetados es difícil: se necesitan expertos, y las propias imágenes varían mucho de un equipo a otro. Cuando hay muy poco material etiquetado, el entrenamiento estándar de una red neuronal no funciona: el modelo memoriza las características de una fuente concreta y no se generaliza a nuevas condiciones.
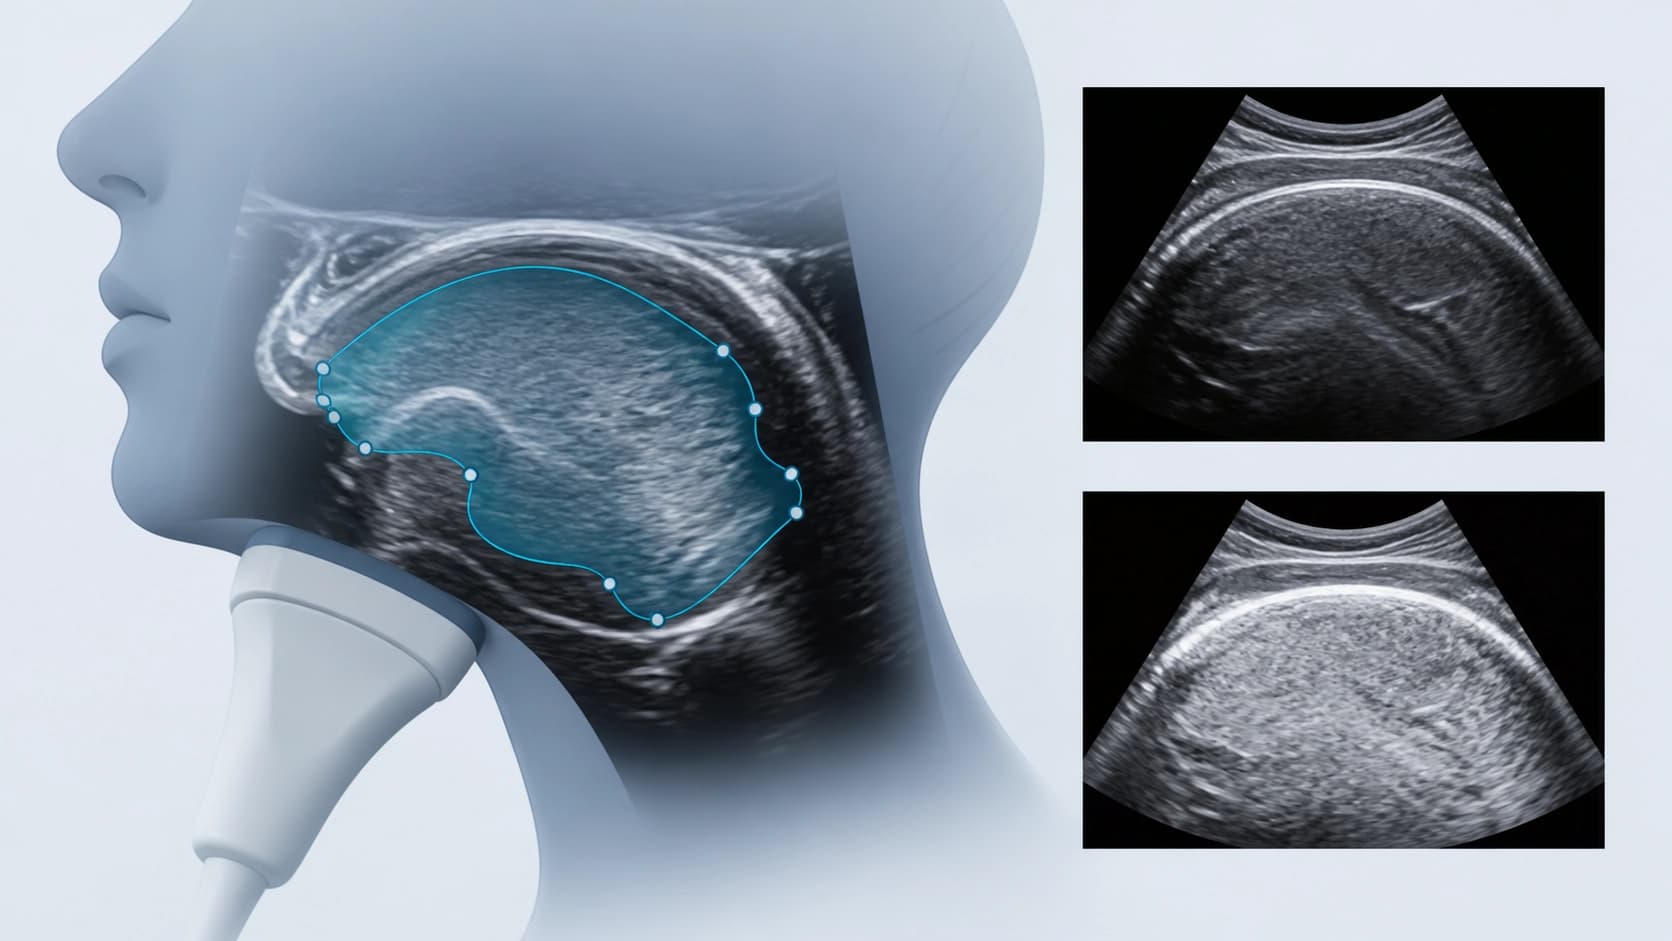
Por qué es difícil
El problema no es solo la escasez de anotaciones. Los datos de ultrasonido del lenguaje se recopilan con diferentes sensores, con distintos ajustes y en diferentes personas, por lo que la distribución de las imágenes en cada nuevo conjunto es propia. Esto se denomina domain shift. Si se entrena un modelo en un conjunto y se aplica a otro, la calidad de la segmentación cae drásticamente. Los métodos clásicos de adaptación requieren acceso a datos etiquetados del dominio de origen, pero en un problema real a menudo solo se dispone de un modelo preentrenado e imágenes sin etiquetar del nuevo dominio.
Idea: adaptación sin fuente (source-free)
Los autores de una investigación reciente proponen un marco que adapta el modelo a un nuevo dominio sin datos etiquetados y sin acceso a las imágenes originales. Como base se utiliza un backbone ligero, UltraUNet, preentrenado con solo cinco imágenes etiquetadas. Este es un punto de partida deliberadamente débil: simula una situación en la que el modelo está subentrenado por falta de datos. Luego se realiza la adaptación al dominio objetivo, donde no hay ejemplos etiquetados en absoluto.
Pseudoetiquetas con filtrado
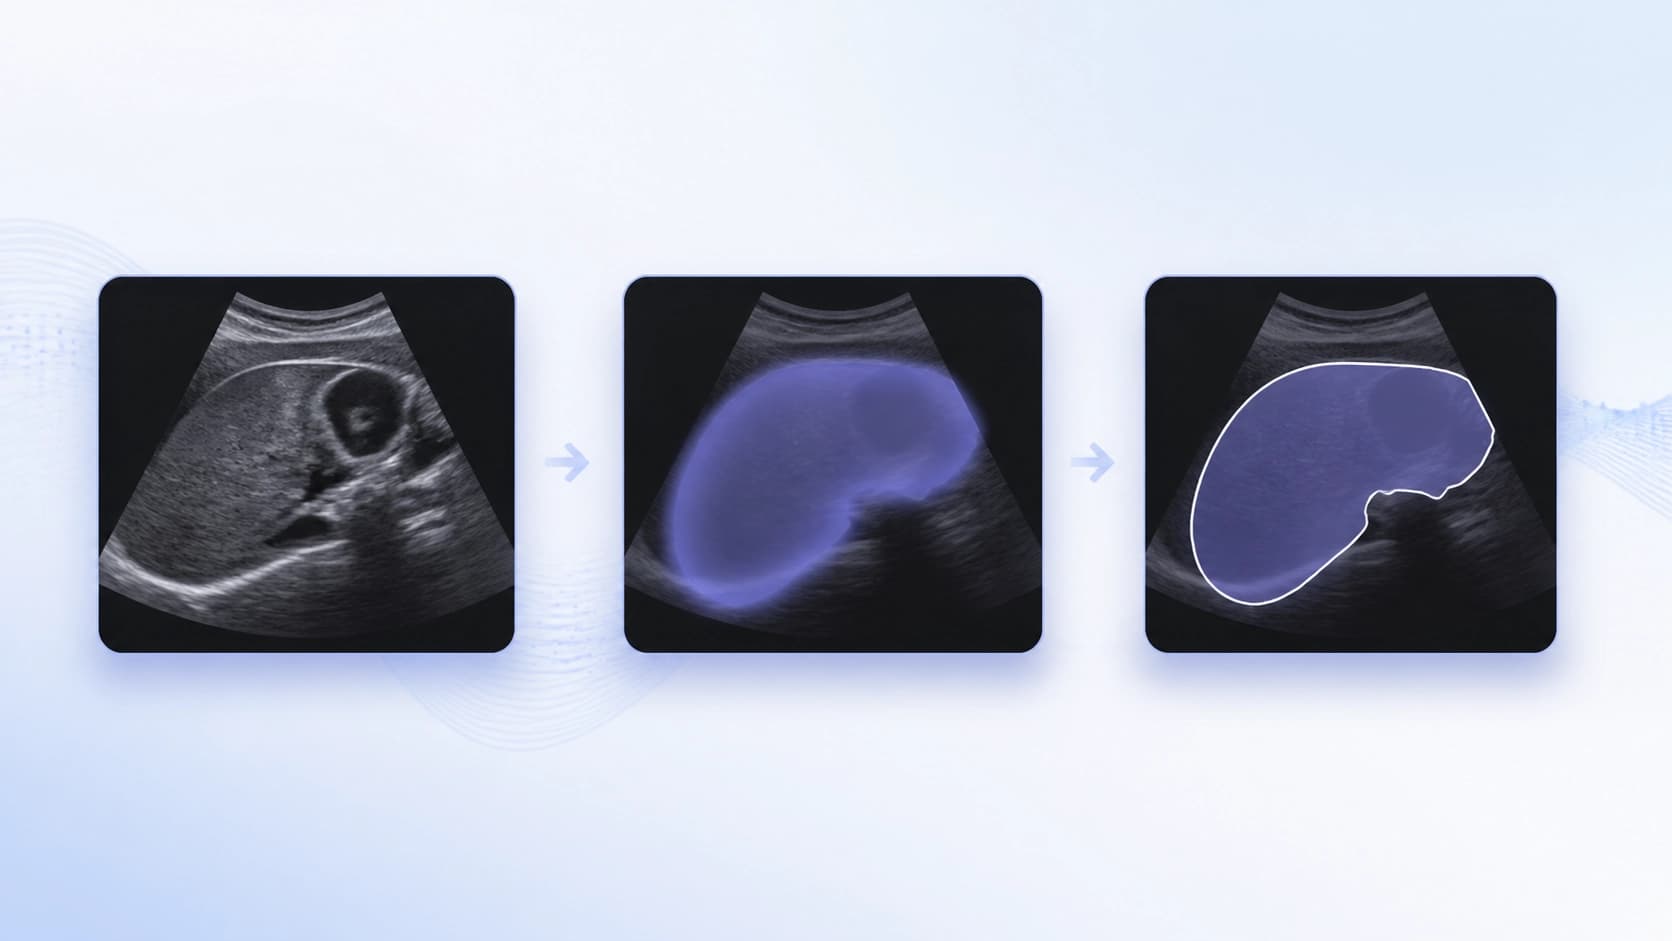
Primero, el modelo hace predicciones sobre las imágenes objetivo. Estas máscaras aproximadas se denominan pseudoetiquetas. Pero no se puede confiar en todas: parte de los contornos será imprecisa o incluso errónea. Por eso, el marco utiliza un módulo especial de control de calidad de contornos que descarta las máscaras poco fiables. Las pseudoetiquetas limpias restantes se utilizan para el entrenamiento. El proceso se repite de forma iterativa: con cada ciclo, la calidad de las etiquetas mejora y el modelo se adapta mejor al dominio objetivo.
Datos sintéticos en el estilo objetivo
Además, se utiliza una GAN condicional guiada por segmentación que genera pares sintéticos «imagen-máscara» en el estilo del dominio objetivo. Esto es similar a la aumentación, pero los datos no se crean mediante transformaciones aleatorias, sino específicamente para el estilo del nuevo dominio. El modelo estudiante se entrena con una mezcla de tres fuentes: imágenes objetivo con pseudoetiquetas limpias, pseudoetiquetas ruidosas con regularización de consistencia y muestras sintéticas generadas. Esta mezcla hace que el modelo sea robusto a los errores y ayuda a evitar el sobreajuste al ruido.
Resultados
El método se probó en 12 pares «fuente-objetivo», compuestos a partir de ocho conjuntos de datos de ultrasonido del lenguaje. En todos los experimentos, el marco propuesto superó a los enfoques base, incluido el entrenamiento supervisado convencional con datos limitados. Mejoraron tanto la superposición de la segmentación (overlap) como la precisión del contorno. Los autores concluyen que el refinamiento de las pseudoetiquetas y la aumentación sintética en el estilo del dominio objetivo son componentes clave que permiten la adaptación casi sin etiquetado.
Este enfoque abre un camino práctico: basta con entrenar el modelo una vez en un conjunto pequeño y luego adaptarlo gradualmente a nuevas condiciones —un nuevo sensor, otra posición del sensor o una población de pacientes diferente— sin una tediosa anotación manual.
Preguntas frecuentes
Material similar
Todos los materiales
OpenCollab: coordinación programable de agentes, entorno de ejecución controlado y métrica de cumplimiento de las normas
El framework integra la definición de la estructura de interacción entre agentes, un entorno común para los experimentos y un seguimiento detallado de los eventos, mientras que la métrica Adherence, introducida en este trabajo, refleja hasta qué punto la ejecución real se ajusta al esquema declarado. En los benchmarks, la configuración Duo alcanza un nuevo nivel de SOTA, mientras que la variante de un solo agente destaca por consumir la menor cantidad de tokens.
11 noviembre 2026
Toollery: selección de herramientas para agentes LLM entre decenas de miles de opciones sin necesidad de ajuste fino
Toollery construye un índice de búsqueda a partir de las descripciones de habilidades y herramientas y, al recibir una consulta, solo envía al modelo un conjunto limitado de candidatos. En experimentos con bibliotecas de hasta decenas de miles de funciones, el enfoque permite mantener la calidad de selección con un top-K fijo, aunque el efecto final depende del perfil de carga y del almacenamiento en caché del proveedor.
11 noviembre 2026
Diagnóstico por etapas de agentes GUI al analizar dashboards: el benchmark DashAct
Se presenta DashAct, un benchmark de 348 trayectorias verificadas por humanos que desglosa el trabajo de los agentes GUI con paneles interactivos en tres etapas y cuatro condiciones visuales. Los resultados revelan problemas persistentes para predecir acciones y vincularlas con objetivos visuales, así como la dependencia de las respuestas de los agentes del apoyo contextual y espacial.
11 noviembre 2026