
División de tokens en transformadores multimodales: cuándo la atención conserva la contribución de la representación
El estudio determina bajo qué condiciones dividir una representación de entrada en un mayor número de elementos no cambia su contribución, manteniendo el contenido, la posición, el contexto visible y la masa total. Para núcleos de atención positivos con un multiplicador local de masa no decreciente, la invariancia solo se alcanza cuando este es lineal; en Qwen2.5-Omni-7B y en benchmarks de vídeo, la ponderación por masa reduce la deriva y mejora la precisión durante la compresión.
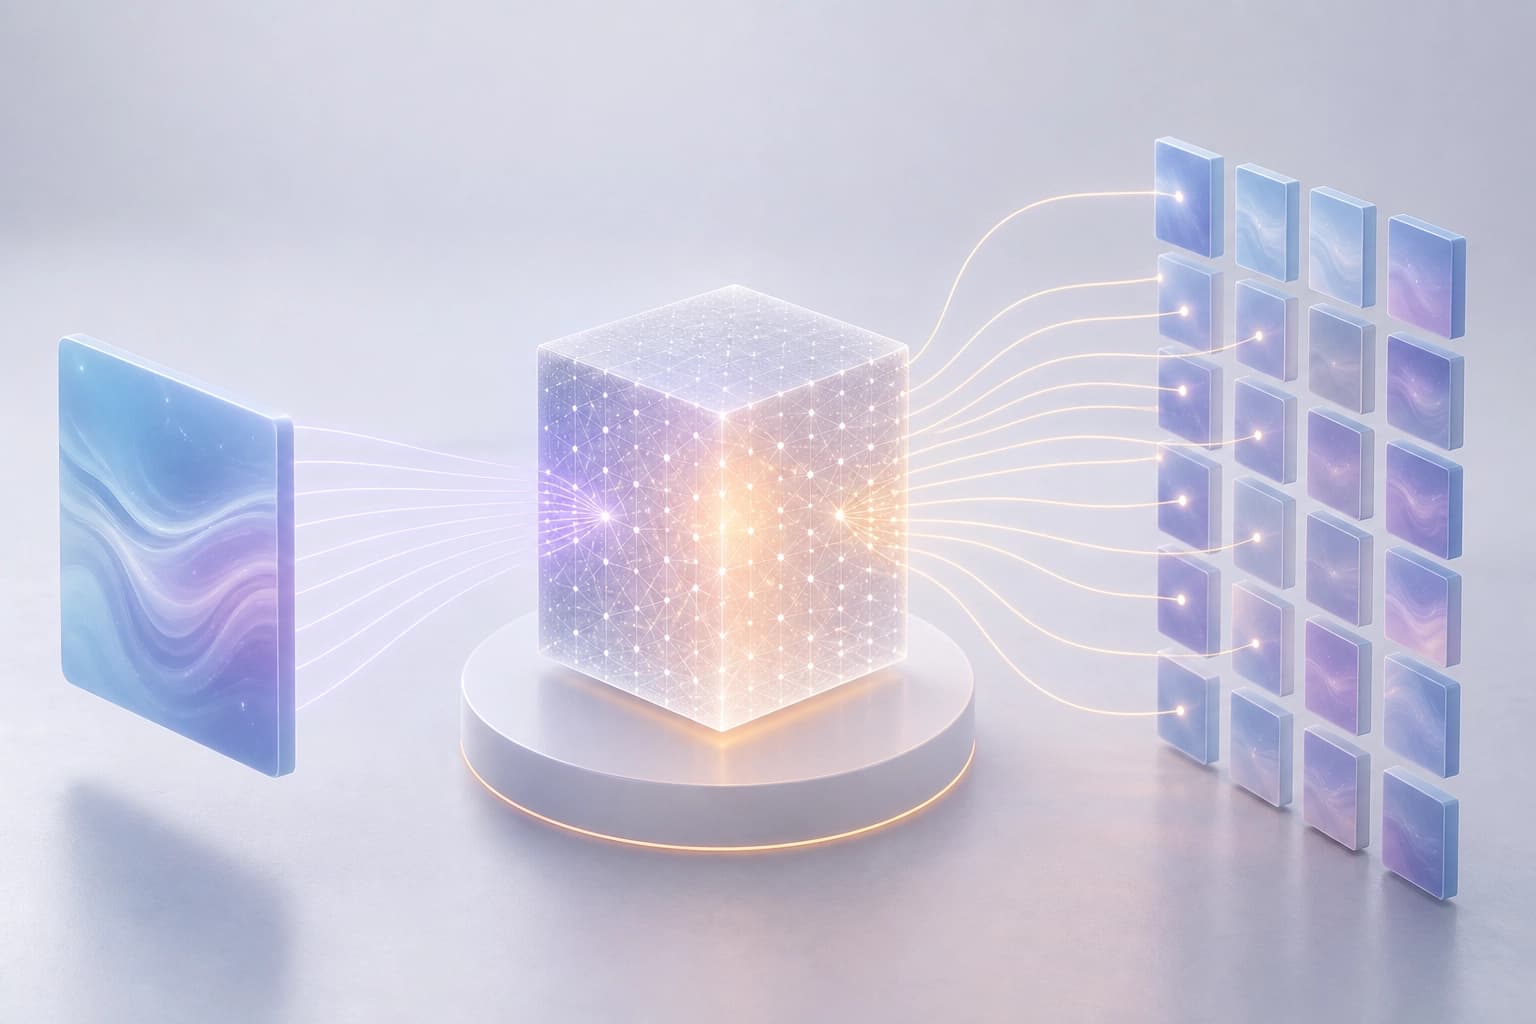
Simetría de refinamiento: qué verifica el principio
El número de pesos de atención depende del número de tokens. Cambiar la representación de la señal modifica ese número. Por tanto, dividir la entrada afecta a la mecánica de la atención.
El artículo «Refinement Symmetry in Multimodal Transformers» (Yuhao Du, Shunian Chen) se presentó el 26 de septiembre de 2026. Introduce la simetría de refinamiento como condición para conservar la contribución.
La división de la representación conserva la contribución si se mantienen cuatro propiedades:
- contenido;
- posición;
- contexto visible;
- masa total.
Criterio práctico: antes de cambiar la segmentación en tokens, compruebe estas cuatro propiedades. Si se pierde siquiera una, la contribución deja de estar garantizada.
Linealidad del factor local de masa
Los autores se basan en la atención proporcional y la atención por cuadratura. Su conclusión: la invariancia frente a la división requiere un factor local de masa lineal. La condición se aplica a cualquier núcleo de atención positivo fijo. Además, el factor no disminuye.
De este requisito se derivan tres comprobaciones:
- un factor no lineal cambia la contribución al dividir;
- la linealidad conserva la contribución;
- la monotonía restringe el conjunto de esquemas admisibles.
Criterio práctico: compruebe que el esquema de ponderación sea lineal antes de dividir. La no linealidad predice un cambio en el resultado.
Acoplamiento físico y límites del error de atención
Para las representaciones modificadas se aplica el acoplamiento físico. Este limita el error de atención. El límite separa dos fuentes:
- cambio de características;
- redistribución de los pesos.
Criterio práctico: analice ambas fuentes por separado. Así podrá ver qué debe corregir: las características o los pesos.
Prueba con Qwen2.5-Omni-7B: respuestas de MVBench
En Qwen2.5-Omni-7B, triplicar la mitad de los tokens visuales cambia 255 respuestas de 3 586 en MVBench. Este es el resultado de la atención estándar. La ponderación por medida conserva todas las respuestas. La visibilidad sigue siendo comparable.
| Esquema | Respuestas modificadas | Visibilidad |
|---|---|---|
| Atención estándar | 255 de 3 586 | — |
| Ponderación por medida | ninguna | comparable |
Conclusión: la discrepancia no la crea la división en sí, sino la forma de contabilizar la masa.
Criterio práctico: al dividir los tokens visuales, pase a la ponderación por medida. Esta mantiene las respuestas con el mismo contexto visible.
Remuestreo de fotogramas y deriva de la distribución
Al remuestrear fotogramas de forma natural, la ponderación por medida reduce la deriva de la distribución. El efecto va más allá de conservar respuestas individuales.
Criterio práctico: al cambiar la frecuencia de fotogramas, vigile la deriva de la distribución, no solo la precisión. La ponderación por medida la reduce.
Compresión de vídeo: ganancia medida
La evaluación se realizó con una fusión por dos de la codificación de vídeo congelada. Se utilizaron cinco semillas aleatorias. La mejora de precisión fue positiva en todas las particiones.
| Esquema de referencia | Mejora de precisión |
|---|---|
| Ponderación global por número de tokens (masa media del grupo) | 1,04 puntos porcentuales |
| Atención estándar | 0,93 puntos porcentuales |
La ventaja frente a la ponderación global por número de tokens también se observa en WorldSense. Depende del presupuesto de compresión.
Criterio práctico: al comprimir mucho el vídeo, consulte el presupuesto. La ganancia de la ponderación por medida no es constante.
Qué aporta el principio de representación
Los autores presentan el resultado como un principio de representación con una ganancia medida en robustez frente a las particiones. No se trata de ajustes puntuales, sino de una regla para trabajar con la división.
Criterio práctico: primero fije la representación y su masa; después ajuste los pesos. Así, la división dejará de cambiar las respuestas.
Preguntas frecuentes
Material similar
Todos los materiales
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026
Modelo del mundo para agentes basados en LLM cerrados: corrección en puntos de riesgo
Se propone PAWM, un predictor externo que no duplica la observación paso a paso, sino que se activa cuando es probable que ocurra un fallo y desvía al agente de una acción equivocada. Tras el ajuste fino supervisado (SFT) con escenarios sintéticos y el coentrenamiento con GRPO, el método logró una mejora del 24,3 % en ScienceWorld y del 7,7 % en WebArena-Lite para Claude Sonnet 4.5.
4 noviembre 2026
Capa de clasificación sobre SpeechLLM: dónde supera a la generación de etiquetas en el reconocimiento de emociones
En IEMOCAP y MELD se compara la predicción generativa de etiquetas emocionales con un clasificador lineal aplicado a las representaciones ocultas de una SpeechLLM compacta. La mejora en la calidad que aporta el clasificador no es universal: depende del corpus y de si se utilizan transcripciones de referencia o resultados de ASR.
4 noviembre 2026