
Capa de clasificación sobre SpeechLLM: dónde supera a la generación de etiquetas en el reconocimiento de emociones
En IEMOCAP y MELD se compara la predicción generativa de etiquetas emocionales con un clasificador lineal aplicado a las representaciones ocultas de una SpeechLLM compacta. La mejora en la calidad que aporta el clasificador no es universal: depende del corpus y de si se utilizan transcripciones de referencia o resultados de ASR.
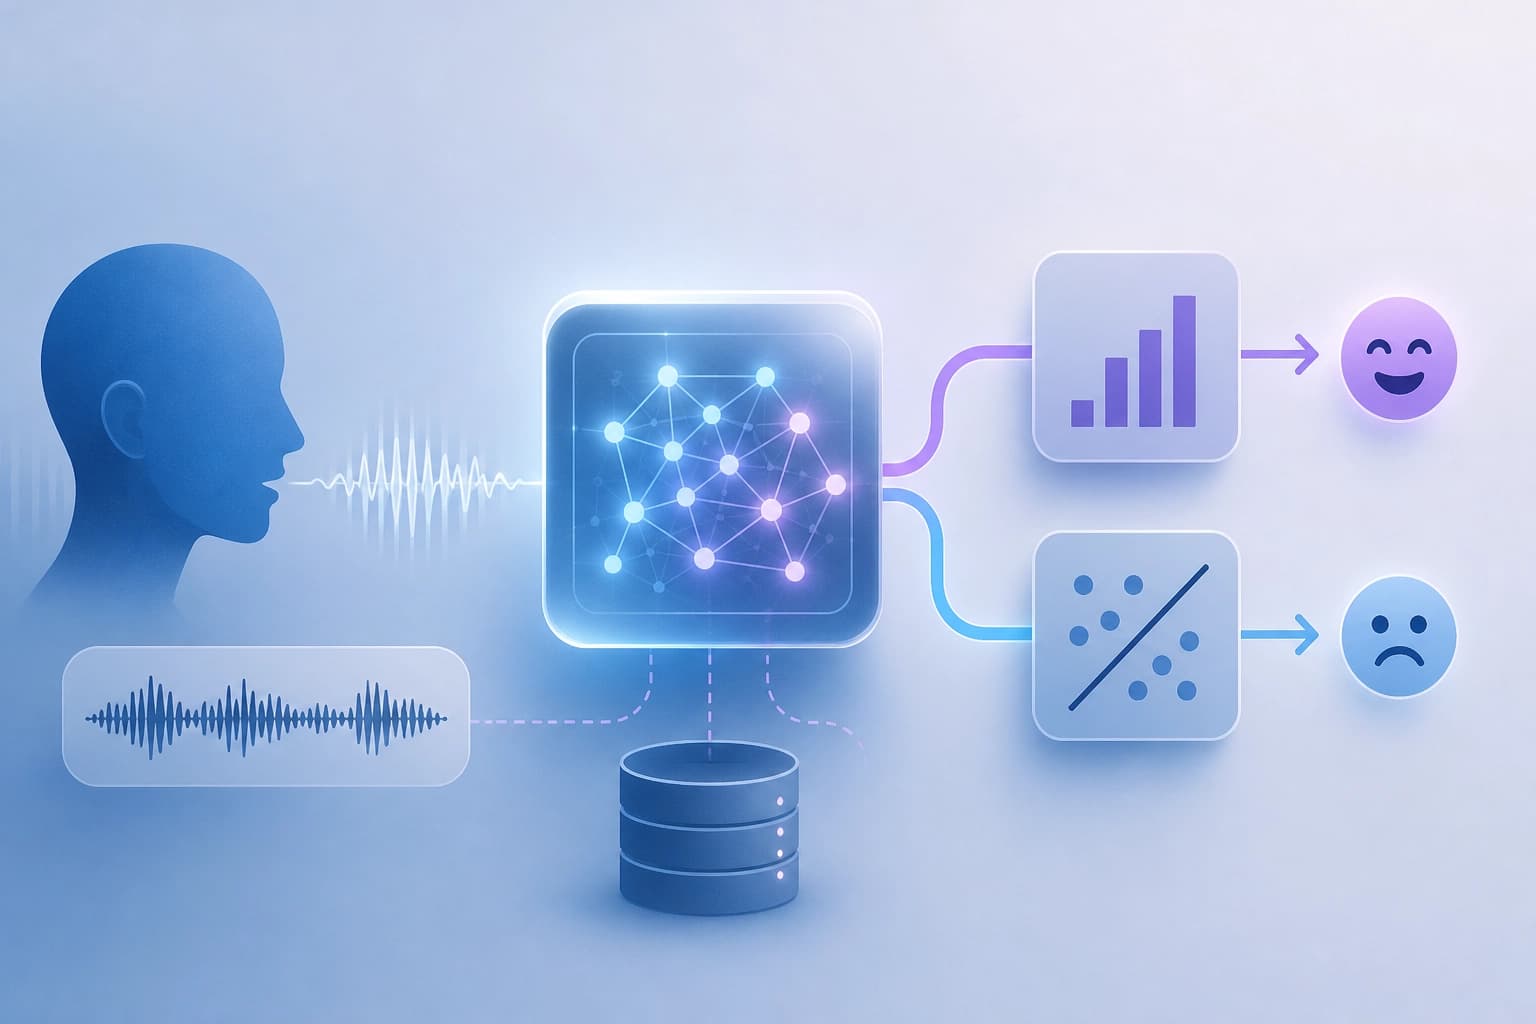
Dos enfoques para el reconocimiento de emociones
El artículo compara la generación de un token de etiqueta por parte de un LLM con la clasificación discriminativa mediante una cabeza lineal sobre los estados ocultos del LLM. El enfoque generativo se basa en las representaciones de salida que el LLM ya produce. El enfoque discriminativo añade a la modelo una cabeza de clasificación independiente.
| Criterio | Generación de un token de etiqueta | Clasificación discriminativa |
|---|---|---|
| Función del LLM | Proporciona representaciones de salida para la etiqueta | Proporciona estados ocultos para la cabeza |
| Mecanismo de decisión | El LLM genera un token de etiqueta | Una cabeza lineal clasifica el estado oculto |
| Qué se utiliza | La salida ya generada por el modelo | Los estados ocultos del LLM |
La diferencia práctica es que la generación utiliza la salida ya generada por el modelo, mientras que la cabeza lee los estados ocultos.
Condiciones de la comparación
Las comparaciones se realizaron en IEMOCAP y MELD. Se utilizó una SpeechLLM compacta: un encoder Whisper-medium congelado y un LLM de 3B. Para cada comparación se usaron transcripciones de referencia y transcripciones de ASR. La comparación abarca dos fuentes de texto, por lo que el efecto de la cabeza se evaluó por separado para cada una. Criterio de evaluación: comparar los resultados solo dentro del mismo conjunto de datos y la misma fuente de transcripción.
Dónde la cabeza de clasificación supera a la generación de etiquetas
La cabeza de clasificación mejoró el Macro F1 en 10 de las 14 configuraciones. En IEMOCAP mejoró todas las configuraciones con transcripciones de ASR y alcanzó un Macro F1 del 76.97%. En ese mismo conjunto, el modo solo de voz también mostró una mejora significativa. En MELD, la cabeza ayudó al usar solo voz, pero no con transcripciones de ASR. Conclusión: la ventaja depende del conjunto de datos y de la fuente de transcripción. No existe una superioridad universal frente a la generación de etiquetas.
Por qué no se deben extrapolar las conclusiones de las transcripciones de referencia
En MELD, las transcripciones de ASR tienen un WER del 32.38%. En 4 de las 6 configuraciones con texto, el efecto de la cabeza cambia de signo entre las transcripciones de referencia y las de ASR. Por lo tanto, las conclusiones obtenidas con transcripciones de referencia no necesariamente se mantienen con ASR. Criterio práctico: evaluar la cabeza con la fuente de texto que se utilizará.
Qué muestran los tokens más cercanos del vocabulario
En IEMOCAP y MELD, los tokens del vocabulario del LLM más cercanos a los vectores de clase aprendidos eran, en su mayoría, palabras relacionadas con las emociones. No eran nombres explícitos de emociones. Esto demuestra que el nombre explícito de una emoción no necesariamente coincide con el token más cercano del vocabulario. Criterio de comprobación: observar qué tokens están cerca del vector de clase, no solo el nombre de la etiqueta.
Criterio de elección
La elección del enfoque se basa en dos factores: el conjunto de datos y la fuente de transcripción.
- Para las transcripciones de ASR, evaluar la cabeza con ASR, no con el texto de referencia.
- Para el modo solo de voz, tener en cuenta la mejora en IEMOCAP y MELD.
- En el caso de las transcripciones de referencia, no extrapolar las conclusiones a ASR.
- Para interpretar las clases, observar los tokens más cercanos del vocabulario del LLM.
Criterio final: la cabeza supera a la generación de etiquetas allí donde la evaluación en el conjunto de datos y la fuente de transcripción de destino muestra una mejora.
Preguntas frecuentes
Material similar
Todos los materiales
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026
Modelo del mundo para agentes basados en LLM cerrados: corrección en puntos de riesgo
Se propone PAWM, un predictor externo que no duplica la observación paso a paso, sino que se activa cuando es probable que ocurra un fallo y desvía al agente de una acción equivocada. Tras el ajuste fino supervisado (SFT) con escenarios sintéticos y el coentrenamiento con GRPO, el método logró una mejora del 24,3 % en ScienceWorld y del 7,7 % en WebArena-Lite para Claude Sonnet 4.5.
4 noviembre 2026
De las puntuaciones individuales a los conjuntos admisibles: decodificación global bajo restricciones DDI
El artículo compara la selección global exacta de un conjunto compatible de medicamentos, implementada mediante programación lineal entera mixta, con varios esquemas locales para resolver conflictos de DDI con puntuaciones FLAME fijas en MIMIC-III. En el conjunto de prueba, la opción global ofrece una mejora pequeña pero constante en Jaccard, que aumenta al endurecer las restricciones y alcanza +0.0064 frente al método local de referencia más sólido.
4 noviembre 2026