
Arquitectura de soporte para millones de diálogos: separación de búsqueda, acciones y generación
A partir del ejemplo de un servicio de reservas de alojamiento, los autores analizan el paso de un modelo único a un orquestador limitado de operaciones tipadas y a un generador basado en contexto verificado; los efectos de la arquitectura se evalúan por separado de los cambios asociados. En los diálogos reproducidos, aumentó la precisión al seleccionar reservas, desaparecieron los errores en las acciones estructuradas y se redujeron las escalaciones; la optimización también redujo la latencia y los costes de mantenimiento del modelo, mientras que el volumen de conversaciones transferidas a operadores en producción no cambió de forma significativa.
Escala y límites de la evaluación
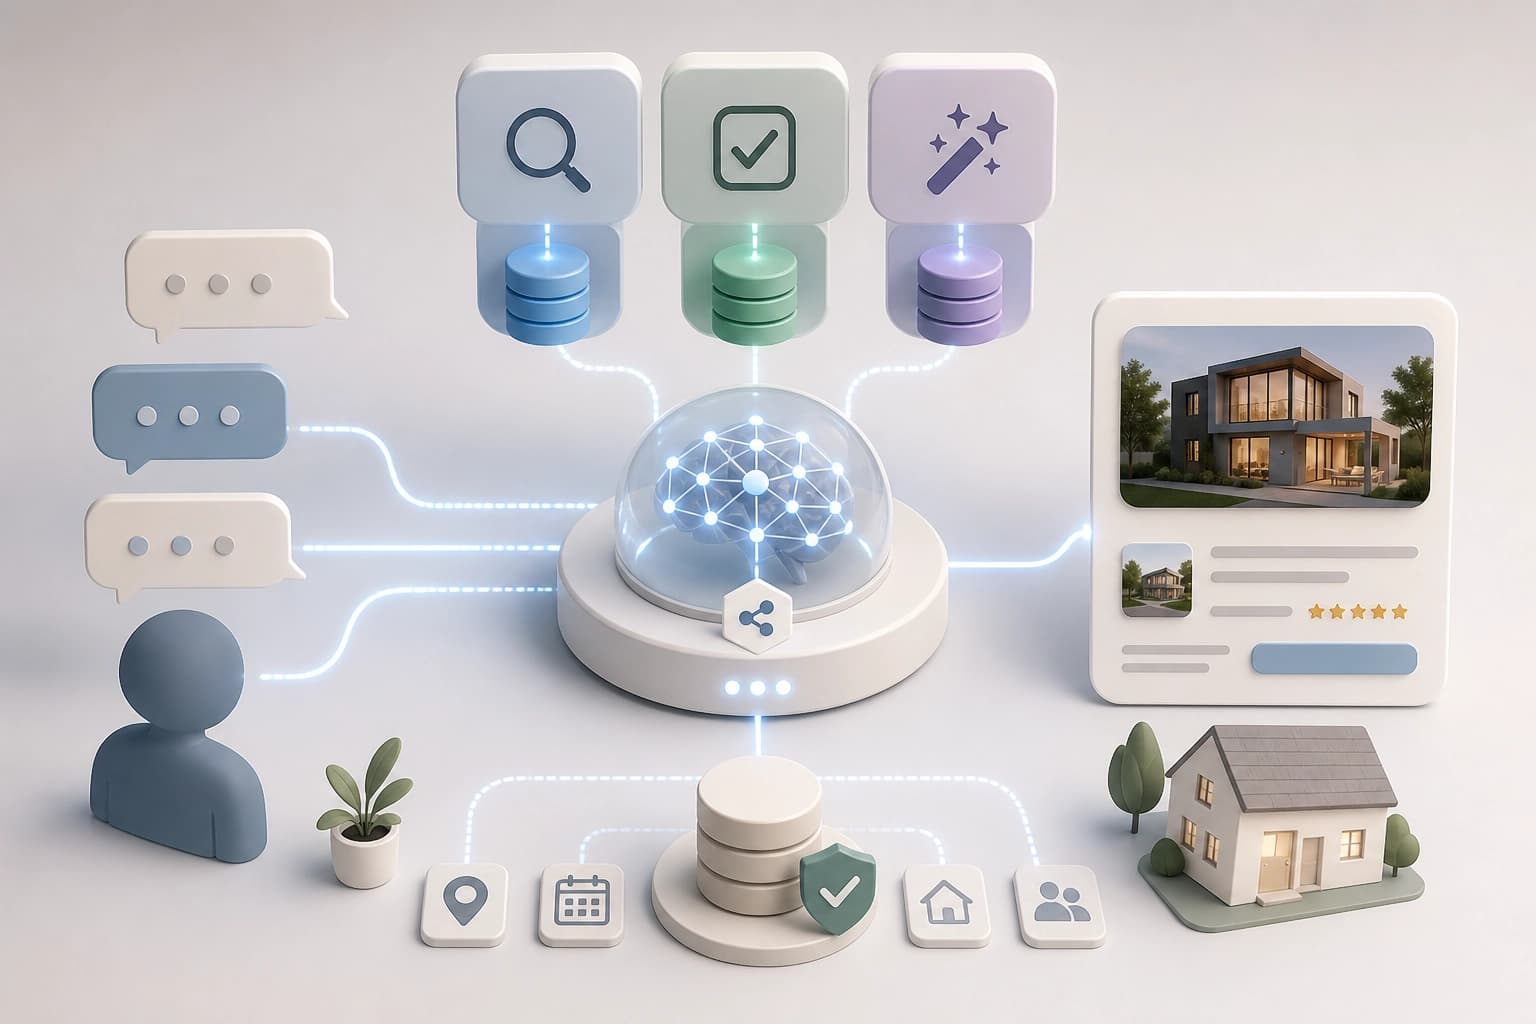
El sistema de soporte de un gran marketplace de vivienda procesa millones de conversaciones al mes. Funciona en 11 idiomas y el P90 indicado es de 10 segundos. Estas cifras describen la escala del sistema, pero no muestran el efecto de una decisión arquitectónica concreta.
| Parámetro | Valor |
|---|---|
| Volumen | Millones de conversaciones al mes |
| Idiomas | 11 |
| P90 | 10 segundos |
Durante la migración también cambiaron los prompts, el alignment y el serving. Por eso, los autores atribuyen a la arquitectura únicamente los efectos medidos en conversaciones reproducidas de forma idéntica.
Criterio de evaluación: comparar arquitecturas con conversaciones de entrada idénticas, en lugar de atribuirles todos los cambios posteriores a la migración.
Cómo se separan la búsqueda, las acciones y la generación
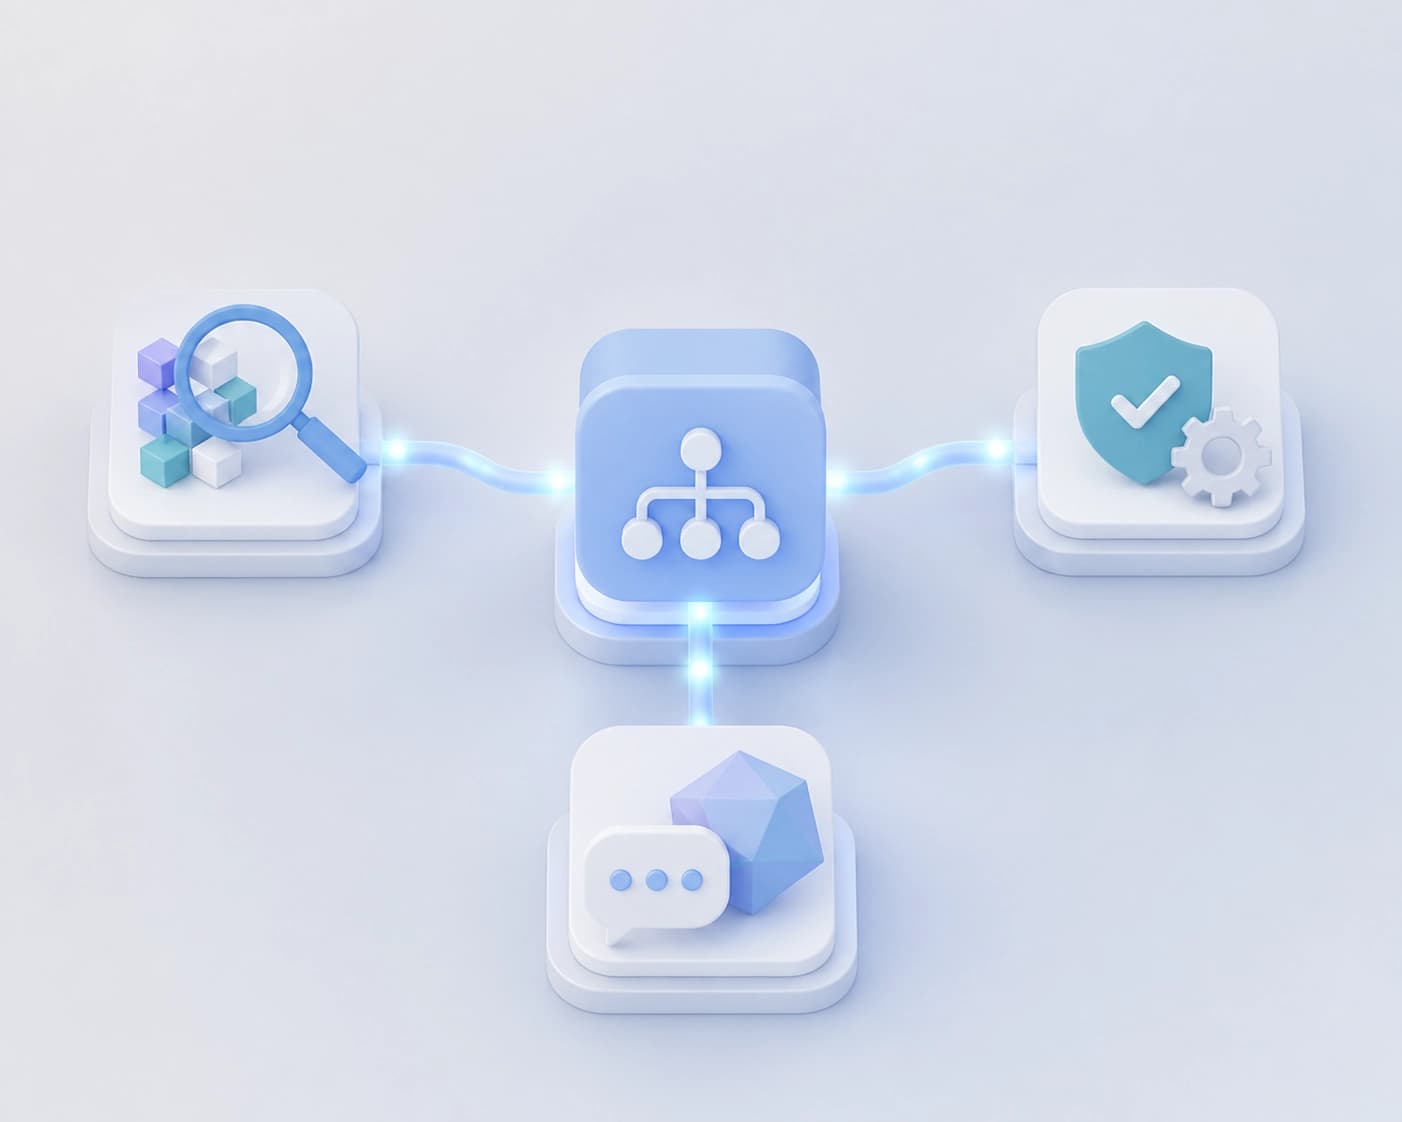
Dynamic Response (DR) sustituye el respondedor mixto Qwen3-235B-A22B por un orquestador ReAct limitado, con herramientas tipadas y un generador más pequeño. El generador construye la respuesta a partir de un contrato de contexto validado por el sistema backend.
| Parte del sistema | Función |
|---|---|
| Búsqueda | Selección tipada de entidades, incluida la selección de reservas |
| Acciones | Identificadores de acciones tipados y verificación de pertenencia |
| Generación | Respuesta basada en un contrato de contexto validado por el sistema backend |
| Orquestación | Orquestador ReAct limitado sobre herramientas tipadas |
Esta separación distingue la selección de entidades y acciones de la formulación de la respuesta. Criterio de selección: esta arquitectura es adecuada cuando el sistema necesita operaciones verificables, no solo un generador de respuestas único.
Qué cambió en la selección de entidades y acciones
La selección tipada de entidades orientó el selector de reservas hacia la precisión. La precisión aumentó y la exhaustividad disminuyó. La verificación de pertenencia mediante ID tipados eliminó los errores observados en las acciones estructuradas.
| Métrica | Antes | Después |
|---|---|---|
| Precisión en la selección de reservas | 8,3% | 89,1% |
| Exhaustividad en la selección de reservas | 75,2% | 67,3% |
| Alucinaciones observadas en acciones estructuradas | 2,14% | 0,0% |
Los resultados muestran una disyuntiva entre la precisión y la exhaustividad de la selección. Criterio de selección: este modo es adecuado cuando es más importante evitar una selección errónea que mantener el nivel de exhaustividad anterior.
Cómo evaluar las escalaciones y el autoservicio
Una prueba A/B de bajo nivel reprodujo en replay la reducción de las escalaciones. Sin embargo, el volumen de transferencias a agentes en producción se mantuvo aproximadamente estable.
| Indicador | Antes | Después |
|---|---|---|
| Respuestas con escalación obligatoria | 5,60% | 3,08% |
| Respuestas con escalación opcional | 9,56% | 2,49% |
| Self-solve | — | Tendencia observada: +5,1 pp; IC del 95%: de −2 a +12 |
La reducción de las escalaciones no estuvo acompañada de una reducción comparable en el volumen de transferencias a agentes. Los autores describen el self-solve como una tendencia observada, no como un aumento concluyente.
Criterio de evaluación: hacer un seguimiento por separado de las respuestas con escalación, las transferencias reales a agentes y el self-solve.
Qué aportó la optimización del serving
Las optimizaciones del serving redujeron el P90 de latencia del orquestador de 3,87 a 2,24 segundos. Al mismo tiempo, la huella de GPU disminuyó aproximadamente en un tercio.
| Indicador | Cambio |
|---|---|
| P90 de latencia del orquestador | 3,87 → 2,24 segundos |
| Huella de GPU | Reducción de aproximadamente un tercio |
| Coste anual estimado del serving de modelos con self-hosting | Reducción de más de un orden de magnitud |
Estas cifras se refieren al serving, no a la calidad de la selección de entidades o acciones. Criterio de evaluación: considerar la latencia, la huella de cómputo y el coste del serving por separado de las métricas de respuesta.
Preguntas frecuentes
Material similar
Todos los materiales
Verificación de alucinaciones de LLM mediante una vista SQL de las fuentes, sin reentrenamiento
El estudio evalúa si un LLM puede aprovechar una habilidad simbólica básica —crear una base de datos SQL a partir de documentos fuente— para fundamentar sus respuestas en las fuentes sin supervisión al detectar alucinaciones. En RAGTruth y DiaHalu, este flujo de trabajo neuro-simbólico resulta más preciso que la predicción directa y comparable a los métodos más avanzados, sin requerir un ajuste fino al dominio.
9 noviembre 2026
MathAdv: qué oculta la precisión final de las demostraciones de máquinas
Un conjunto diagnóstico de tareas de 13 áreas de matemáticas de nivel universitario y de posgrado evalúa los sistemas de demostración automática en Lean 4 no solo por el resultado final, sino también por su dominio de la materia, la calidad de sus razonamientos informales y su robustez ante reformulaciones de los enunciados. El análisis por componentes muestra que traducir un problema a un formato formal sigue siendo el principal obstáculo, y que el éxito depende en gran medida del área matemática y de cómo se plantee el problema.
9 noviembre 2026
AffordanceWAM: las affordances como intermediarias entre la predicción de la escena y el control del manipulador
El trabajo describe un modelo generativo que predice simultáneamente futuras observaciones RGB, campos escalares, mapas de calor de affordances y comandos continuos para el robot, utilizando videos de personas para ampliar la diversidad de interacciones sin anotaciones de acciones ni retargeting. En RoboCasa, CALVIN ABC→D y tareas reales, el enfoque ofrece mejoras consistentes frente a las líneas de base que utilizan solo RGB o solo datos robóticos.
9 noviembre 2026