Las redes neuronales de spikes suelen discutirse en el contexto de la eficiencia energética: en lugar de multiplicaciones densas, eventos dispersos; en lugar de un compás constante, actividad dispersa. Pero esta clase de modelos tiene un segundo recurso que casi siempre queda sin aprovechar: el potencial de membrana, que cambia continuamente en el tiempo. Un trabajo reciente propone verlo no como una variable intermedia, sino como un estado de creencia pleno, y construir sobre él las decisiones sobre qué examinar a continuación.
Problema: la nube de puntos se escanea con la misma ruta
Cuando se aplica una red de spikes a datos 3D, los fragmentos de la escena suelen recorrerse en un orden predefinido, idéntico para todas las entradas. El orden de recorrido no depende de lo que hay en la nube de puntos. Se produce una asimetría extraña: el rasgo más característico de la computación con spikes, la evolución temporal del potencial de membrana, no influye en absoluto en qué datos verá la red ni cuándo se detendrá. La decisión se toma "desde fuera" de la dinámica, no dentro de ella.
Active Spiking Perception: la membrana se encarga de la selección
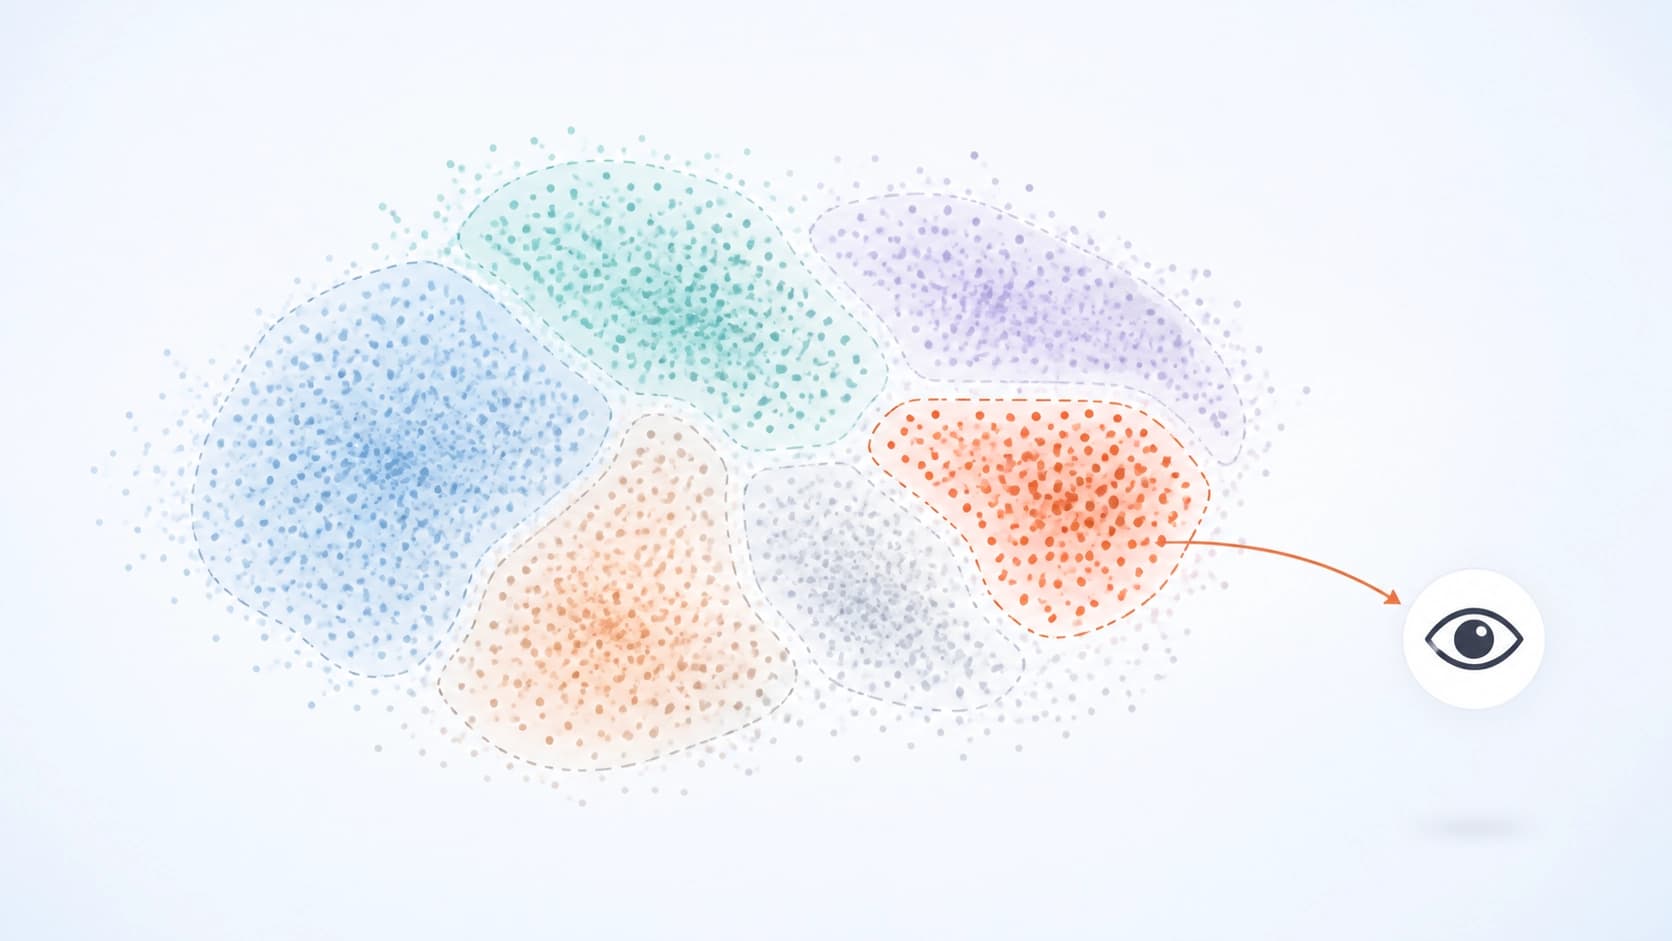
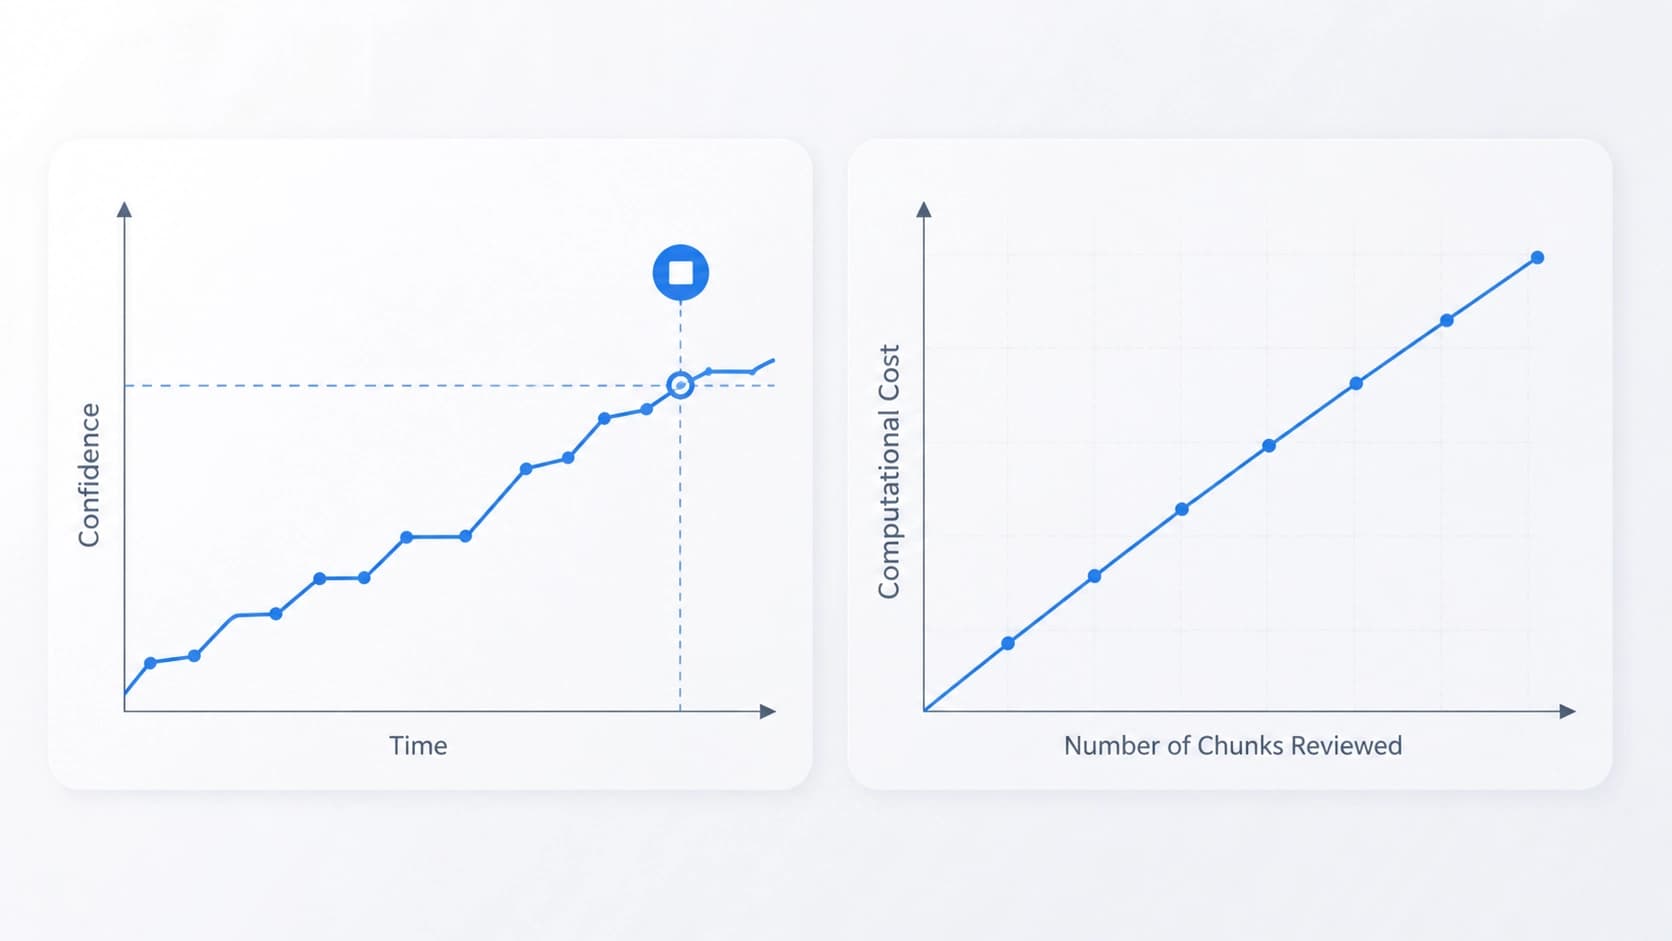
El método Active Spiking Perception (ASP) despliega el reconocimiento en un ciclo iterativo. La red observa un fragmento, actualiza el estado de las neuronas LIF (leaky integrate-and-fire) y lee su potencial de membrana como la hipótesis actual sobre la clase — running belief. Es precisamente esta hipótesis la que determina qué fragmento entrará en el campo de visión a continuación, y una ventaja notable del líder según el margin sirve como señal para la detención anticipada.
La idea es simple, pero cambia el papel del potencial: deja de ser una magnitud auxiliar entre capas y se convierte en una interfaz a través de la cual la red "explica" para sí misma qué le falta para responder.
Cómo está diseñada la política de selección
De la selección se encarga un módulo ligero, Slice-Selection Policy. Los candidatos para la siguiente observación se toman de farthest-point sampling, y se evalúan según dos cosas: el estado actual de la membrana y descriptores geométricos precalculados. El entrenamiento es end-to-end mediante straight-through Gumbel-Softmax, y en inferencia el esquema se reduce a un argmax ordinario. El costo adicional es modesto: alrededor del 2% del número de parámetros del backbone.
Por qué esto no es una simple heurística
Los autores aportan una base teórica para la construcción. Primero: la mecánica de leaky integration puede considerarse como una actualización recursiva del logaritmo de la probabilidad a posteriori en un filtro bayesiano, es decir, la acumulación del potencial equivale a la acumulación de evidencia. Segundo: la regla de detención garantiza un riesgo selectivo distribuido-libre, además sin penalización por comparaciones múltiples en el momento en que la red decide dejar de observar. Tercero: la transferencia del estado de flujo entre pasos equivale a un recálculo desde cero sobre el prefijo de observaciones, bajo la condición de una deriva limitada de la precisión finita.
Qué mostraron los experimentos
En ModelNet40 el método alcanza 90.62%, en ModelNet10, 93.28%. Esto es 1.7 puntos porcentuales por debajo del baseline de spikes más fuerte, y además el baseline utiliza un backbone más grande. Así que la precisión máxima no es el argumento principal del trabajo. El argumento es otro: ASP añade una interfaz anytime certificada, que ninguno de los enfoques comparados ofrece.
El mecanismo también escala a predicciones densas: 83.21 instance mIoU en ShapeNetPart y 48.50 mIoU en S3DIS Area 5. Este último resultado los autores lo califican como el primero con spikes en este conjunto.
Un apartado aparte es la transferibilidad. Si se reemplaza la selección aprendible de fragmentos por una fija, la misma lógica sigue funcionando en un transformer no-spiking foveado. Por lo tanto, la política no es una propiedad de una arquitectura de spikes concreta, sino una técnica autónoma.
El umbral como palanca para los cómputos
El costo de inferencia crece estrictamente de forma lineal con el número de observaciones: esto es consecuencia de que la red procesa los fragmentos uno por uno. El umbral de confianza se convierte en un regulador medible: subiéndolo, se puede hacer que el modelo observe durante más tiempo y con mayor precisión; bajándolo, obtener una respuesta más rápido. Los autores estiman la ganancia en un rango de 2.8x a 1.35x menos consumo energético respecto a variantes comparables. El sentido práctico es evidente: la misma solución sirve tanto para un escenario de servidor, donde importa la precisión, como para uno embarcado, donde importa más el presupuesto.
Limitaciones y hacia dónde avanzar
Se declara honestamente al menos un cuello de botella: una de las clases en S3DIS no logra reconocerse con el tamaño de crop utilizado. Los autores no lo ocultan, sino que aportan la predicción que eliminaría el problema; en esencia, una pista para la siguiente iteración del trabajo.
Conclusión
El principal valor del trabajo no está en las cifras de los benchmarks, sino en el cambio de marco. El potencial de membrana aquí no es un producto secundario de la integración, sino un estado de creencia del que se derivan tanto la elección de la acción como el criterio de detención. De esto surgen tres consecuencias: aparece un modo anytime con garantías certificadas, el costo se vuelve lineal y controlable con un solo parámetro, y la propia política de selección resulta transferible a otras arquitecturas, incluidas las no-spiking.
En otras palabras, los modelos de spikes revelaron tener no solo un recurso energético, sino también uno "decisional". Y se puede aprovechar sin reescribir el backbone desde cero.
Los detalles técnicos se exponen en el preprint arXiv:2608.19232 (cs.NE, cs.AI, cs.LG; ACM I.2.10, I.5.1, I.2.6), versión v1 del 4 de agosto de 2026, v2 del 22 de agosto. Extensión: 28 páginas, 9 figuras, 17 tablas y apéndices A–J.