La memoria de trabajo donde importa la magnitud, no el dígito
Mantener en la mente una variable continua —el ángulo de giro, la velocidad, la posición del cursor, la fuerza de una pulsación— y ajustarla con suavidad: esta es, quizá, la prueba más honesta de la memoria de trabajo. Recordar un «siete» no es difícil, pero conservar una magnitud sin fronteras naturales, capaz de desplazarse en una fracción arbitrariamente pequeña, es una tarea de una clase completamente distinta.
Con ella, las redes artificiales han tenido históricamente una relación tensa. Los modelos con atractores continuos —es decir, con estados estables que no forman un puñado de puntos aislados, sino una superficie suave— se sostienen sobre una promesa frágil: basta con desplazar un poco los parámetros para que el comportamiento se desmorone.
Por qué las arquitecturas recurrentes habituales «cuantizan» el estado
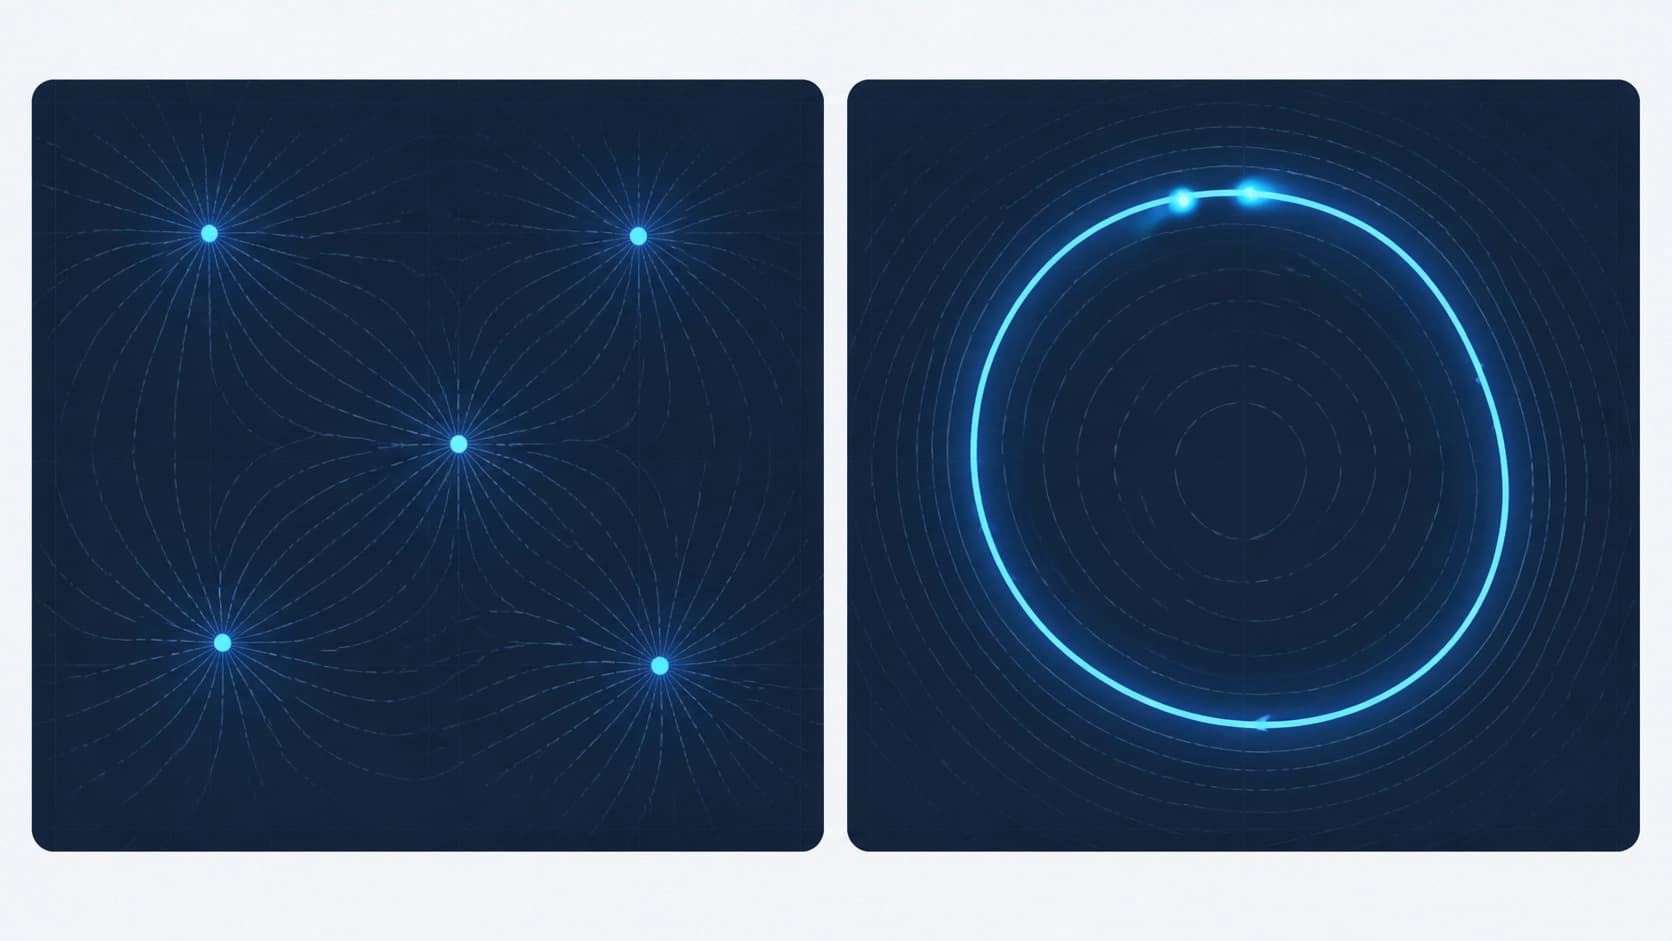
Las soluciones recurrentes estándar, incluidas GRU y LSTM, por lo general no llegan a aprender variedades continuas. En lugar de un continuo, fragmentan el espacio de estados en atractores puntuales discretos: la red, por así decirlo, redondea la entrada al «estante» más cercano. Para la clasificación esto resulta cómodo; para la estimación cuantitativa, es una sentencia.
Un equipo de investigadores (Zhaotian Gu, Jie Su, Weiwei Wang, Chang Liu, Tianyi Qian, Dahui Wang) propuso tratar esto no complicando la arquitectura, sino con un recurso computacional concreto. El trabajo se publicó en Transactions on Machine Learning Research (agosto de 2026); el preprint está disponible como arXiv:2608.01947 en las secciones q-bio.NC, cs.AI y cs.NE.
Dividir en lugar de restar: el modelo mínimo
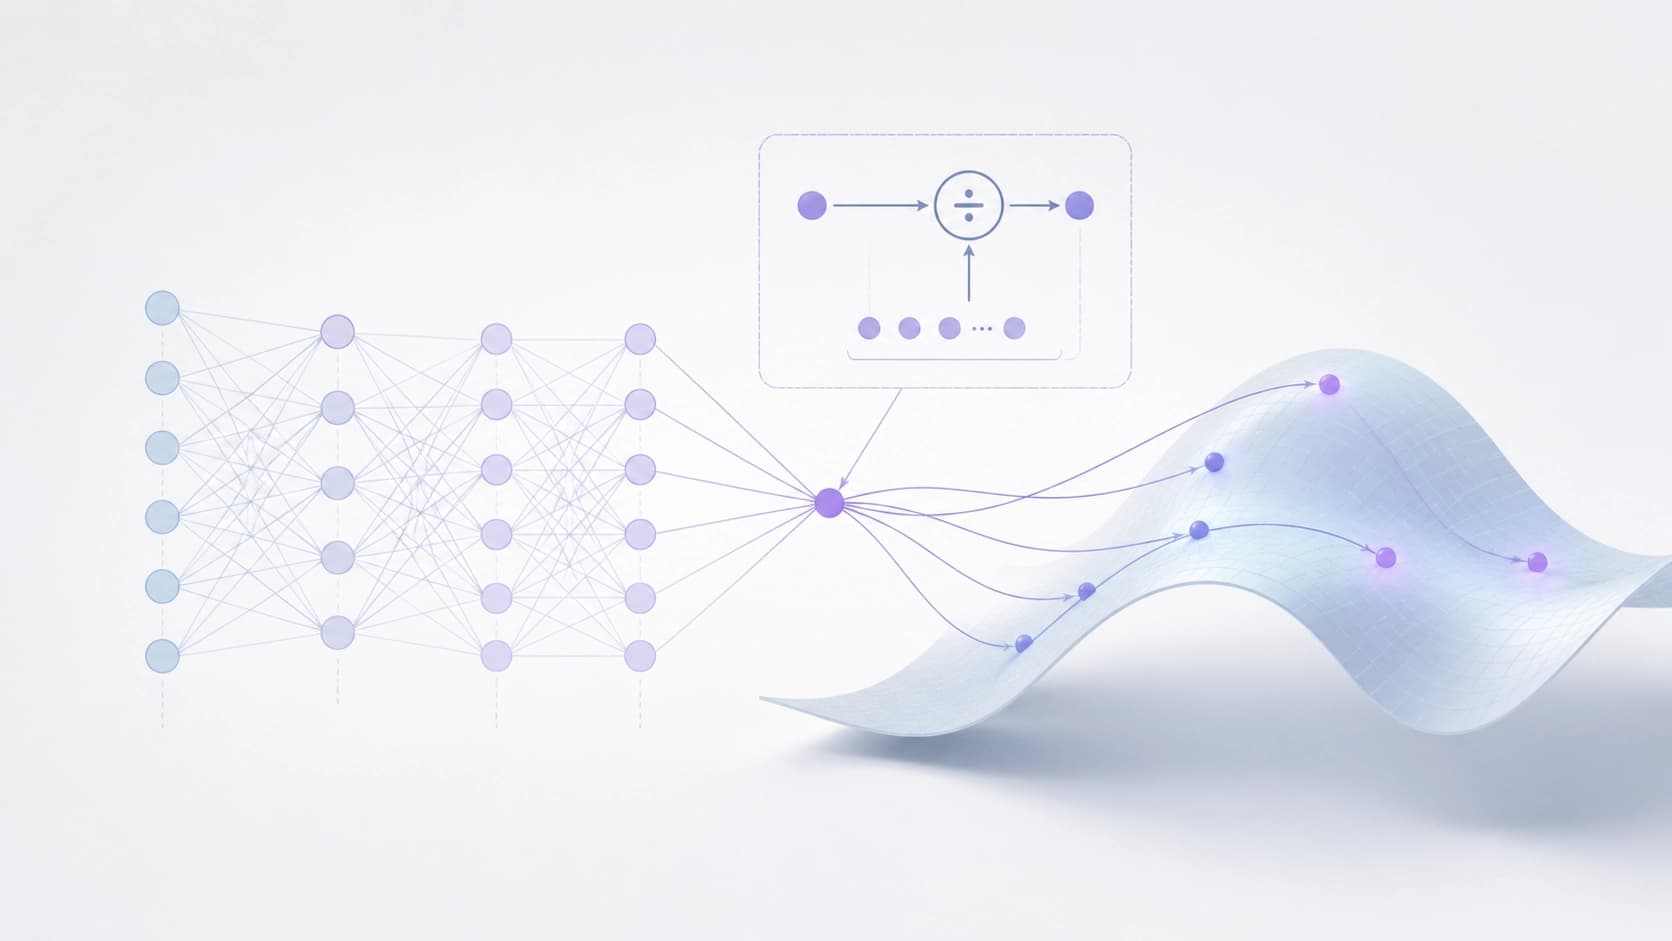
La idea provino de la neurobiología. La división (normalización divisiva) es una operación canónica que se observa de forma generalizada en los circuitos corticales, y los autores construyeron en torno a ella una red recurrente mínima y algebraicamente aislada: Recurrent Divisive Normalization Network, abreviada RDNN. Dentro no hay nada superfluo: solo la dinámica de la división y lo que la acompaña.
A partir de ahí, el paso habitual en neurociencia computacional: el análisis de sistemas dinámicos en tareas clásicas de memoria de trabajo. Y aquí la restricción biofísica se convierte inesperadamente en una ventaja. La red converge hacia variedades lentas estables, y además con alta precisión: las trayectorias no se dispersan, sino que se asientan sobre una superficie estrecha y se desplazan por ella con tranquilidad.
Qué ocurre con el gradiente
Un capítulo aparte del trabajo es el análisis del aprendizaje mediante retropropagación en el tiempo (BPTT). La división introduce un escalado local del gradiente que depende de la actividad actual: cuanto más excitado está el bloque, más modesto es la actualización de parámetros que le corresponde. El resultado es un freno incorporado que se activa justo donde se necesita.
El efecto es observable: el rango efectivo de la red se autocontrae notablemente, y la dinámica recurrente queda encerrada en un subespacio estrecho de baja dimensión. Los autores subrayan además la diferencia con una factorización explícita de bajo rango: allí, una restricción semejante suele provocar patologías de optimización, mientras que aquí surge por sí sola, como efecto secundario de la actividad.
Ablaciones: sin la división, la variedad se desmorona
La parte más elocuente es la comparación con la inhibición sustractiva. Esa sustitución sí sabe retener recuerdos estáticos: conservar un punto fijo no supone problema. Pero basta con que las señales de entrada empiecen a cambiar en el tiempo para que la variedad se «fracture» (manifold shattering): la continuidad desaparece justo donde más se necesita.
De ahí una conclusión que conviene tener presente: la división no es una curiosidad biológica heredada de la corteza, sino un mecanismo computacional que funciona. Se necesita para que la red aprenda representaciones continuas de alta precisión, y no solo una discretización cuidadosa.
Qué hacer con esto en la práctica
El sentido práctico no está en reescribir de urgencia todos los modelos recurrentes. Es más bien un recordatorio: la normalización no solo tiene que ver con la estabilidad del entrenamiento ni solo con la regularización. Es una forma de definir la geometría del espacio interno de estados, y la división tiene aquí una ventaja clara frente a la sustracción.
Si la tarea exige mantener una magnitud continua y actualizarla con suavidad —en control, en seguimiento, en cualquier sistema donde importe el «cuánto» en lugar del «cuál de ellos»—, vale la pena prestar atención a los esquemas con normalización multiplicativa. El costo es mínimo y, a cambio, la red deja de redondear lo que no debería redondearse.