
SpecEvo: coordinación de LLM ligeros y avanzados para reducir el coste de la búsqueda evolutiva
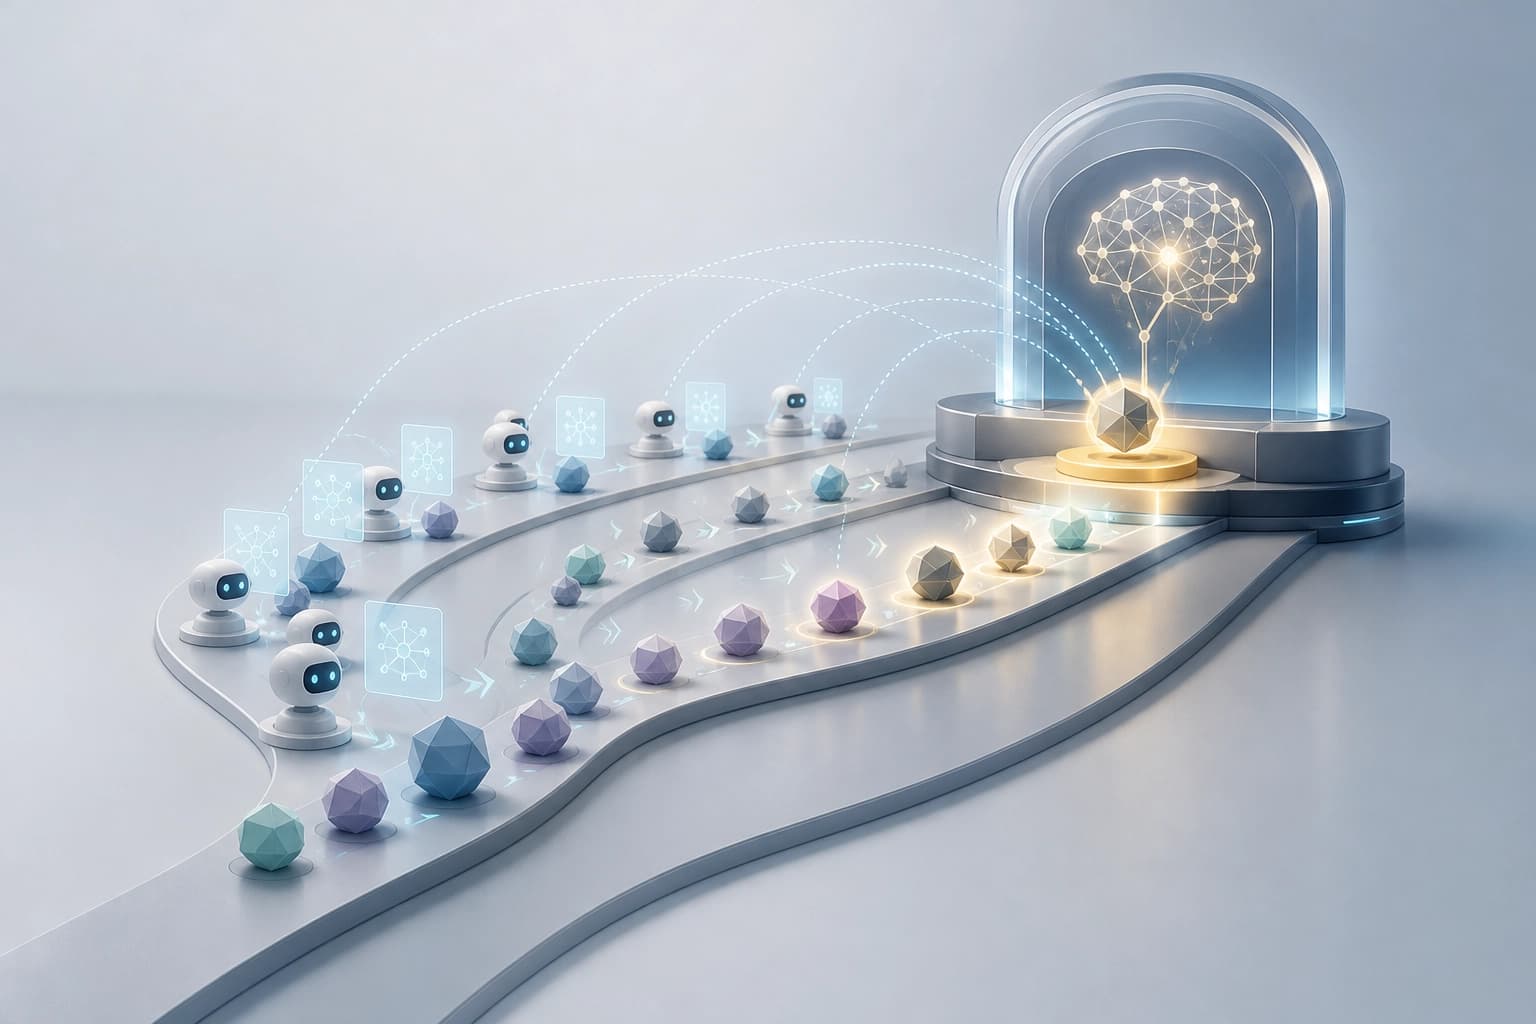
El framework SpecEvo redistribuye la búsqueda evolutiva: los candidatos ordinarios perfeccionan modelos de bajo coste, mientras que los más potentes solo se incorporan en puntos de control estratégicos, basándose en el historial de éxitos y callejones sin salida. En experimentos con 176 tareas, este enfoque igualó o superó a alternativas más costosas y redujo un 80 % los costes de API.
Propósito y función
SpecEvo (Speculative Evolution) es un marco de trabajo multi-LLM para los descubrimientos científicos. Coordina modelos ligeros y avanzados para reducir el coste de búsqueda de programas candidatos. El artículo arXiv:2610.28706 se presentó el 20 de octubre de 2026. Sus autores son Ha Minh Hieu, Tongyao Zhu, Do Xuan Long y Min-Yen Kan.
Características clave:
- tipo: marco de trabajo multi-LLM;
- propósito: descubrimientos científicos y búsqueda algorítmica;
- principio: coordinación de modelos ligeros y avanzados;
- artículo: arXiv:2610.28706, presentado el 20 de octubre de 2026;
- autores: Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, Min-Yen Kan.
Criterio práctico: considerar el marco de trabajo para tareas en las que el coste de la API sea importante y se necesite buscar programas candidatos con etapas de control poco frecuentes.
Arquitectura: funciones de los modelos ligeros y avanzados
SpecEvo distribuye el trabajo entre modelos ligeros y avanzados. Los modelos ligeros desempeñan en paralelo las funciones de Speculators y Advisor. El modelo avanzado actúa como Navigator en etapas de control poco frecuentes.
| Componente | Tipo de modelo | Función | Modo de operación | | Speculators | ligeros | generan y perfeccionan programas candidatos | en paralelo | | Advisor | ligero | sintetiza los éxitos, los fracasos y las direcciones saturadas; los convierte en recomendaciones permanentes | síntesis de la información acumulada | | Navigator | avanzado | estudia la población en evolución; interviene mediante síntesis, perfeccionamiento puntual o cambio del marco de búsqueda | de forma poco frecuente, en etapas de control |
Criterio práctico: encomendar la búsqueda habitual y la síntesis de evidencias a los modelos ligeros, y recurrir a modelos avanzados para intervenciones estratégicas.
Flujo de trabajo «primero conjeturar, luego consolidar»
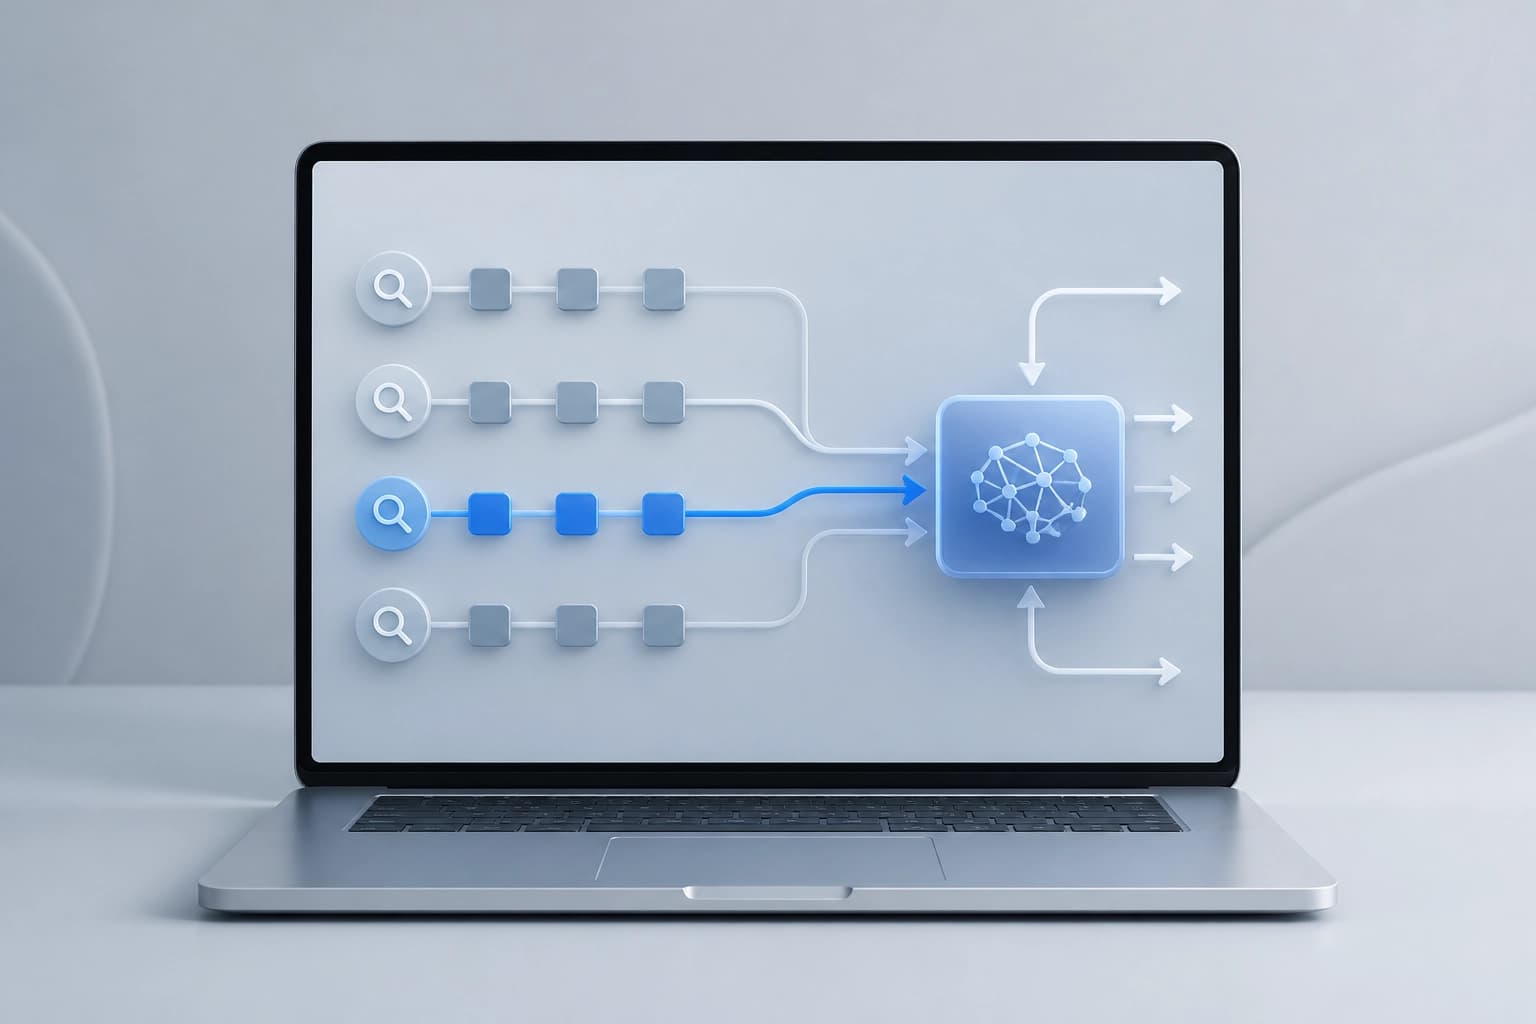
En SpecEvo, el proceso se basa en delegar la búsqueda habitual y la síntesis de evidencias a modelos de bajo coste. Los modelos avanzados se incorporan para realizar intervenciones estratégicas. Su utilidad se extiende a muchas evaluaciones posteriores de bajo coste.
Etapas:
- Los modelos ligeros llevan a cabo la búsqueda habitual de programas candidatos.
- Advisor sintetiza la información acumulada sobre éxitos, fracasos y direcciones saturadas.
- Navigator estudia la población en una etapa de control poco frecuente y elige una intervención.
- La intervención depende del estancamiento de la búsqueda y puede consistir en una síntesis, un perfeccionamiento puntual o un cambio del marco.
- Los modelos de bajo coste continúan las evaluaciones teniendo en cuenta las recomendaciones permanentes.
Criterio práctico: el esquema es adecuado si la búsqueda admite puntos de control poco frecuentes y la acumulación de recomendaciones entre ellos.
Resultados y comparación con los métodos de referencia
Los autores probaron SpecEvo en 176 tareas de cuatro ámbitos de descubrimientos científicos y algorítmicos. El marco de trabajo obtuvo resultados equiparables o superiores a los métodos de referencia basados en modelos avanzados. Al mismo tiempo, redujo los costes de API hasta en un 80%. En la búsqueda de ecuaciones, el marco de trabajo alcanzó una eficiencia de evaluación hasta 1,5× superior a la de los métodos de referencia rentables. El marco de trabajo superó en un 3,8% al método de referencia más sólido, CO-Bench.
| Indicador | Resultado | | Comparación con métodos de referencia basados en modelos avanzados | igualó o superó | | Reducción de los costes de API | hasta un 80% | | Eficiencia de evaluación en la búsqueda de ecuaciones | hasta 1,5× superior a la de los métodos de referencia rentables | | Ventaja sobre CO-Bench | 3,8% |
Criterio práctico de selección: comparar la calidad de la búsqueda y los costes de API con los métodos de referencia en las propias tareas. Los autores concluyen que coordinar modelos teniendo en cuenta la trayectoria de búsqueda es un enfoque eficaz para lograr descubrimientos científicos rentables.
Preguntas frecuentes
Material similar
Todos los materiales
Fig: intervenciones de juego controladas para evaluar el comportamiento social de agentes de IA
Fig recibe una descripción verbal del comportamiento buscado, la divide en variantes y modifica deliberadamente las condiciones del juego para inducir las acciones deseadas en los modelos. En escenarios válidos para seis patrones sociales, las intervenciones aumentaron en un 10,9 % la proporción media de intentos de realizar el comportamiento objetivo en comparación con los controles, y los autores proponen considerar los entornos multiagente como un banco de pruebas configurable para una evaluación reproducible.
21 noviembre 2026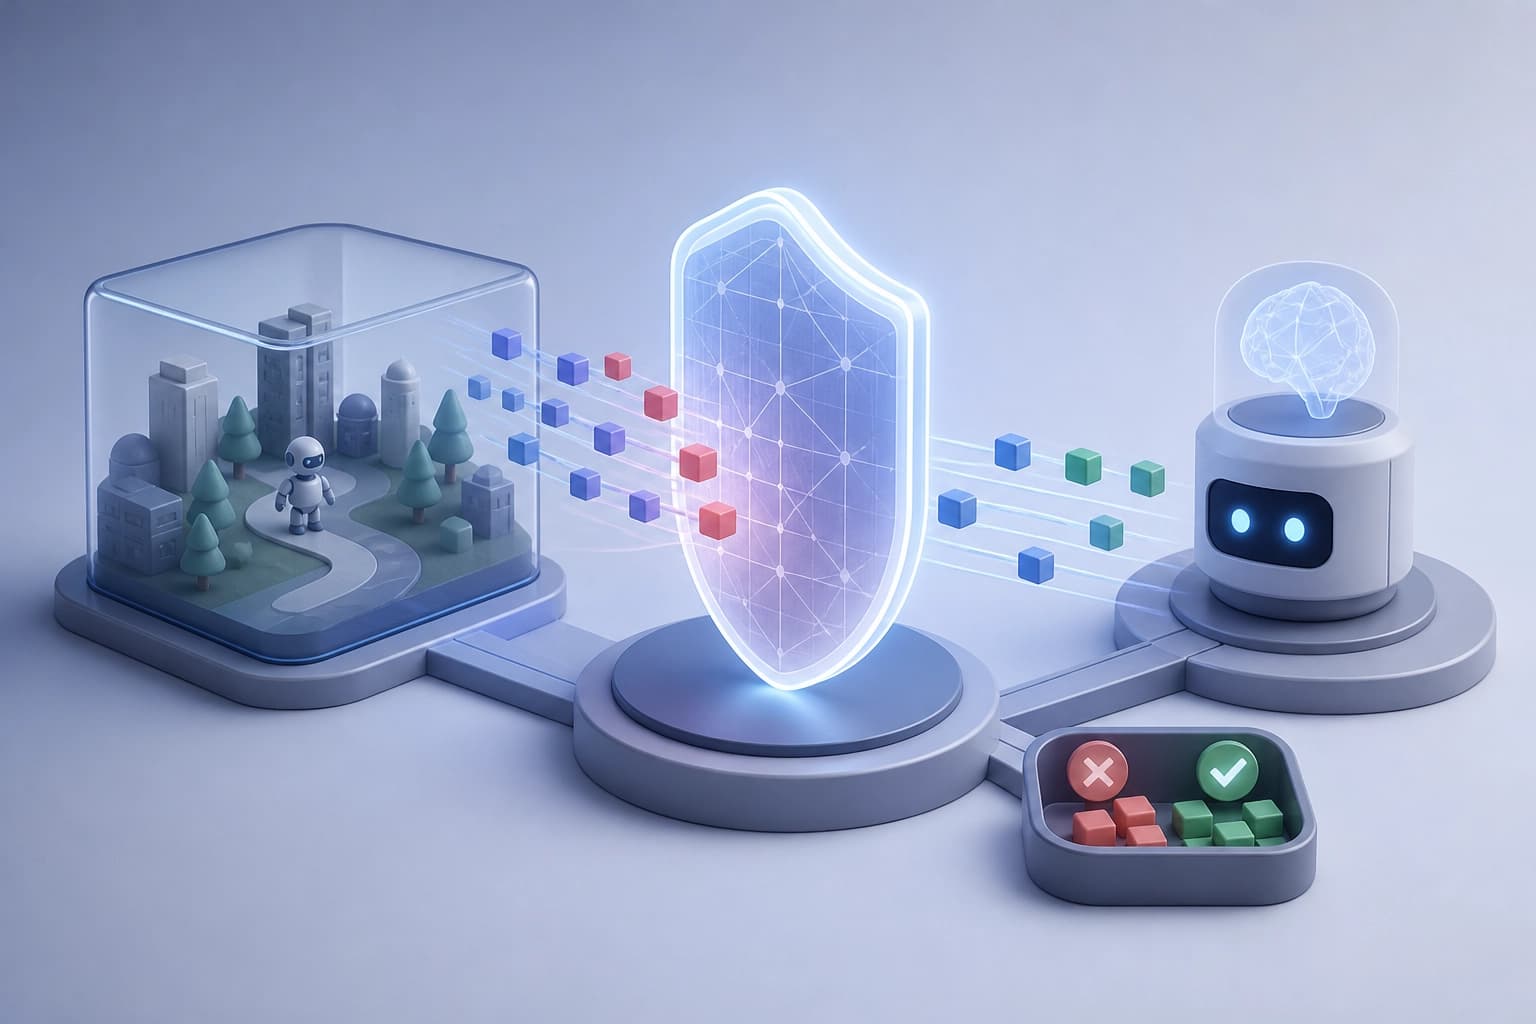
Verificación de políticas de agentes sin depender del prompt: entornos de ejecución, conjuntos de pruebas y filtro entrenable
El trabajo propone un marco que convierte entornos ejecutables en conjuntos de escenarios para probar políticas de agentes y permite mejorar iterativamente el componente de protección. El filtro entrenado reduce la tasa de infracciones exitosas en un 40–44 % frente a depender únicamente de las instrucciones del prompt y rechaza erróneamente con menos frecuencia las solicitudes seguras.
20 noviembre 2026
PerMIT: integridad de la memoria a largo plazo de los agentes LLM y confianza colectiva con verificación por máquina
Los autores proponen la arquitectura PerMIT, que limita la entrada de datos no confiables del entorno en las acciones sensibles del agente mediante una interfaz de memoria finita; dos teoremas verificados en Lean 4 y la acumulación de veredictos de la comunidad reducen el riesgo de envenenamiento sin aumentar la carga para cada usuario. En experimentos con Trojan Hippo y τ²-bench, el esquema no registró inyecciones exitosas con verificadores ligeros y mejoró los resultados de los agentes nuevos en tareas de evaluación diferida.
20 noviembre 2026