
PerMIT: integridad de la memoria a largo plazo de los agentes LLM y confianza colectiva con verificación por máquina
Los autores proponen la arquitectura PerMIT, que limita la entrada de datos no confiables del entorno en las acciones sensibles del agente mediante una interfaz de memoria finita; dos teoremas verificados en Lean 4 y la acumulación de veredictos de la comunidad reducen el riesgo de envenenamiento sin aumentar la carga para cada usuario. En experimentos con Trojan Hippo y τ²-bench, el esquema no registró inyecciones exitosas con verificadores ligeros y mejoró los resultados de los agentes nuevos en tareas de evaluación diferida.
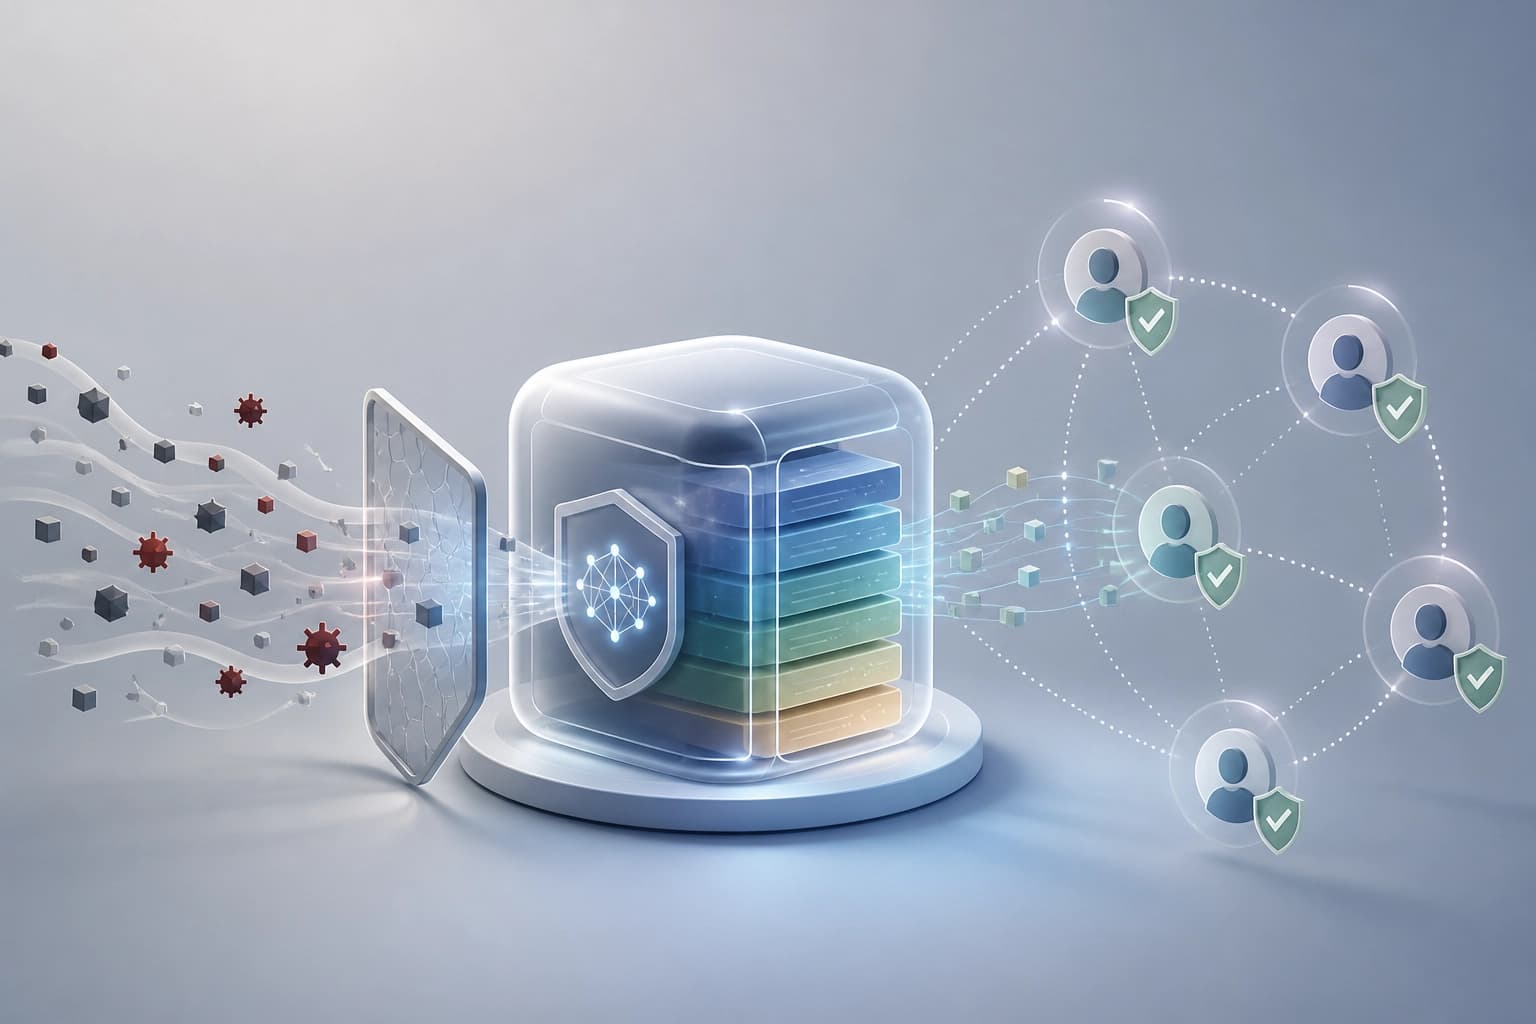
PerMIT — arquitectura de memoria para agentes LLM. Artículo de Tanqiu Jiang, Min Bai, Sadat Shahriar, Wanyu Du y Sandesh Swamy, presentado el 20 de octubre de 2026; arXiv:2610.28987.
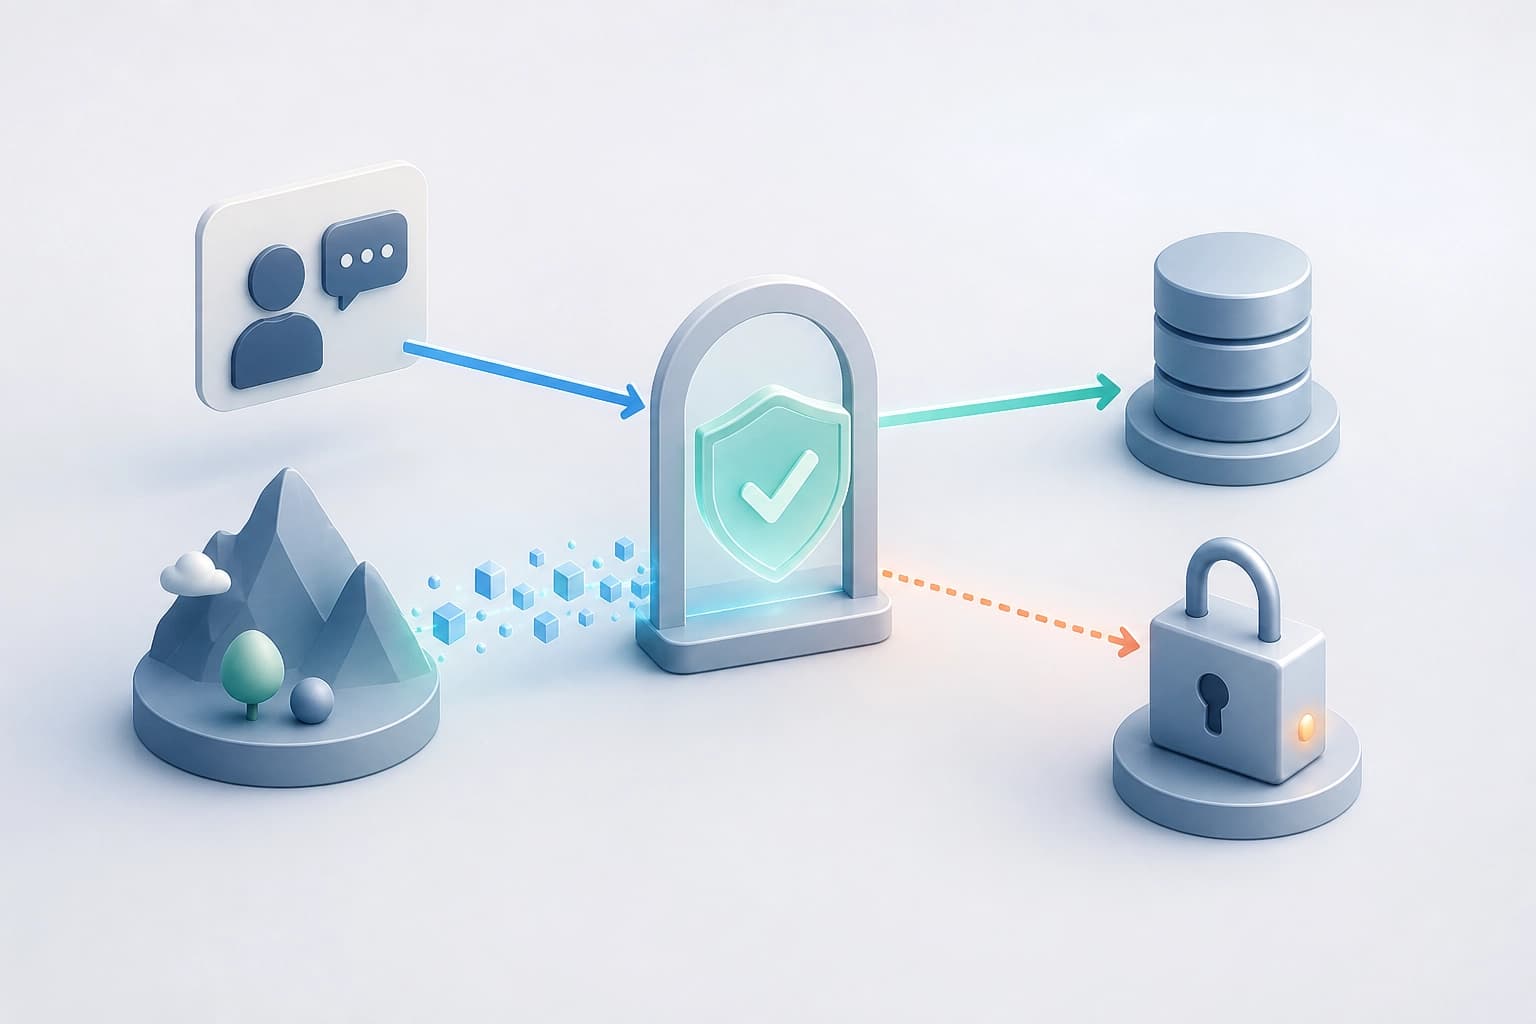
Modelo de confianza
PerMIT establece una suposición explícita sobre la confianza. Solo se consideran confiables los datos introducidos por el usuario y los valores confirmados en la compuerta de control. Todos los valores procedentes del entorno siguen siendo no confiables. La arquitectura regula su transmisión y uso mediante una interfaz de memoria finita. Se mantienen la planificación del agente en varios pasos y la selección de herramientas.
Criterio práctico: el escenario es adecuado si los datos introducidos por el usuario se consideran confiables y los datos del entorno, no.
Compuerta de control y decisiones verificables
La interfaz de memoria finita se basa en una compuerta de control. Los autores demuestran dos teoremas de integridad para la interfaz. Los teoremas se verifican mediante Lean 4. En conjunto, garantizan dos propiedades. La memoria procedente del entorno solo llega a una acción sensible tras confirmarse en la compuerta de control. El comportamiento del agente solo cambia a través de lo que muestra la compuerta de control.
Dentro del modelo de amenazas, cada ataque se reduce a una decisión verificable. En la práctica, la decisión la toma una persona, un verificador LLM o ambos.
Criterio práctico: la protección es aplicable dentro de un modelo de amenazas en el que cada ataque se reduce a una decisión verificable.
Confirmaciones y confianza colectiva
Cada confirmación es un veredicto registrado sobre un contenido exacto. Las confirmaciones se acumulan entre usuarios. Los elementos con suficiente respaldo quedan confirmados por la comunidad sin necesidad de más verificaciones.
Bajo supuestos explícitos, los autores demuestran una propiedad de escalado conjunto. También la confirman mediante una simulación. A medida que crece la comunidad, disminuyen los riesgos de promover datos envenenados y de eliminar por error conocimientos benignos. El esfuerzo de verificación de cada usuario no aumenta.
| Qué cambia a medida que crece la comunidad | Tendencia |
|---|---|
| Riesgo de promover datos envenenados | Disminuye |
| Riesgo de eliminar por error conocimientos benignos | Disminuye |
| Esfuerzo de verificación de cada usuario | No aumenta |
Criterio práctico: la capa colectiva es adecuada cuando los veredictos están vinculados a un contenido exacto y se acumulan entre usuarios.
Pruebas
En Trojan Hippo, PerMIT registró cero ataques exitosos observados. El resultado se obtuvo mediante autoverificación y el uso de verificadores ligeros.
En τ²-bench, comunidades de hasta 90 agentes autónomos crean bases de conocimiento compartidas con PerMIT. No se promovió ninguna inyección directa en la memoria. Los conocimientos obtenidos mejoran significativamente los resultados de los nuevos agentes en tareas no vistas durante el entrenamiento.
Criterio práctico: dos resultados: no se promueven las inyecciones directas y mejoran los resultados de los nuevos agentes en tareas no vistas durante el entrenamiento.
Preguntas frecuentes
Material similar
Todos los materiales
Sistema de IA multiagente compuesto con un circuito de evidencia para la planificación de protones en tumores de cabeza y cuello
El trabajo describe la combinación de una política PPO entrenada, que genera varias opciones de plan, y agentes LLM que mantienen un diálogo de уточнение guiado por la verificación de métricas clínicas y restricciones; en una muestra de 21 pacientes, Qwen3-14B, ajustado con entrenamiento adicional, siguió mejor las instrucciones y ayudó a orientar el equilibrio hacia los objetivos prioritarios. La conclusión práctica es que la planificación DRL automatizada puede complementarse con un diálogo guiado, manteniendo el control sobre las restricciones en conflicto.
20 noviembre 2026
Selección computacional en lugar de prueba y error empírica: nuevos enfoques para los materiales de baterías
El artículo muestra cómo las bases de datos computacionales, el aprendizaje automático y los modelos generativos reducen el conjunto de composiciones prometedoras, mientras que los laboratorios automatizados aceleran su validación; aun así, el resultado depende de la síntesis y las pruebas, donde las predicciones pueden diferir de la conductividad real.
20 noviembre 2026
Evolución de los benchmarks de agentes al escalar el conjunto de tareas: el papel de la selección de evidencias y las carreras secuenciales
El trabajo explica por qué aumentar el número de tareas puede perjudicar la evolución de los entornos de agentes: la causa es una selección inadecuada de evidencias, no el volumen de datos en sí. El método propuesto, Successive Scale Racing, selecciona sucesivamente combinaciones diversas de tareas y compara candidatos a bajo coste; en tres benchmarks, aumentó la proporción de ejecuciones exitosas al ampliar el conjunto de 40 a 200 tareas, mientras que los métodos de referencia empeoraron y el número de ejecuciones de validación se redujo en aproximadamente un 60 %.
19 noviembre 2026