
SPARSEUP de Linkup: codificador disperso de 149 millones de parámetros
El artículo analiza la arquitectura de SPARSEUP y sus resultados: 56,4 nDCG@10 en BEIR-13, así como una exhaustividad superior al 97 % al combinarla con el índice Seismic, con un tiempo de aproximadamente 380 microsegundos por consulta. El análisis abarca técnicas que conservan la dispersión de los vectores, una comparación con otros modelos y las condiciones de distribución bajo Apache 2.0.
Qué es el modelo y cómo acceder a él
SPARSEUP es un codificador disperso abierto de Linkup Research con 149 millones de parámetros. Su backbone es ModernBERT y su licencia es Apache 2.0.
Los pesos están disponibles en Hugging Face. El modelo se puede cargar con Transformers o Sentence Transformers, indicando trust_remote_code=True.
Linkup considera que el modelo es el codificador disperso basado en vocabulario más potente que conoce la empresa entre los modelos con menos de 150 millones de parámetros.
Cómo funciona la representación dispersa
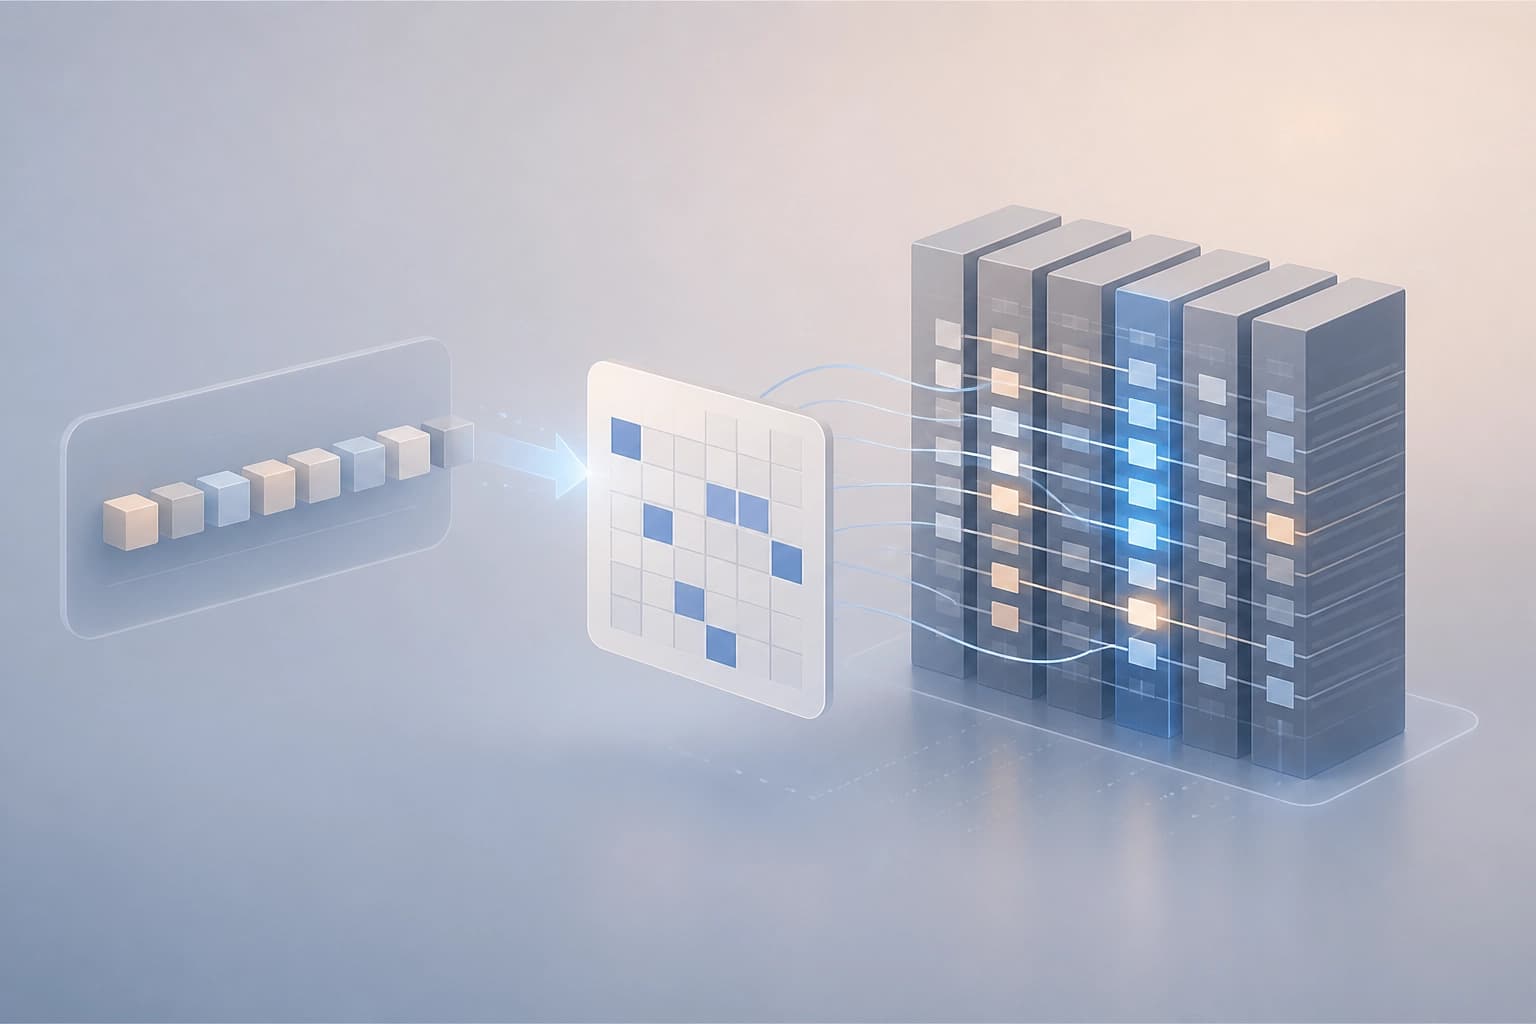
En SPARSEUP, cada dimensión del vector corresponde a un token del vocabulario. Estos vectores son adecuados para índices invertidos y permiten emparejar mejor las palabras poco frecuentes.
El modelo calcula las activaciones mediante la fórmula log(1 + ReLU(x - 15)). Luego conserva las 12 dimensiones más fuertes de cada token de entrada antes del max pooling.
Esto limita el número de dimensiones activas por token, no el tamaño total del vector. El plegado de mayúsculas y minúsculas combina las variantes de Byte-level BPE, por ejemplo heat, Heat, Ġheat y ĠHeat, conservando el peso más alto.
Tras la combinación, el número de dimensiones de salida se reduce de unas 50 mil a unas 34 mil. Las consultas y los documentos reciben los prefijos [Q] y [D]; la puntuación se calcula mediante el producto escalar.
La longitud máxima durante la evaluación es de 128 tokens para una consulta y 512 para un documento. Estos límites son importantes al configurar el procesamiento de las entradas.
Cómo se entrenó el modelo
El entrenamiento de SPARSEUP comenzó a partir del checkpoint LateOn-unsupervised. El equipo recuperó la cabeza MLM original de ModernBERT.
Para el ajuste fino, se utilizó una mezcla de datos de LightOn y solo se aplicó aprendizaje contrastivo. Para cada consulta, se seleccionaron siete negativos difíciles de un conjunto de 50 y también se usaron negativos dentro del lote.
El equipo no aplicó destilación de cross-encoder. El entrenamiento se completó en una sola H100.
Qué muestran las comparaciones
El resultado promedio de SPARSEUP en BEIR-13 sin MS MARCO es de 56,4 nDCG@10. La model card presenta los siguientes resultados de los codificadores dispersos:
| Modelo | BEIR-13, nDCG@10 |
|---|---|
| SPARSEUP | 56,4 |
| opensearch-neural-sparse-encoding-doc-v3-gte | 54,6 |
| opensearch-neural-sparse-encoding-v1 | 52,44 |
| ModernBERT-VT | 52,4 |
| splade-v3 | 51,7 |
| granite-embedding-30m-sparse | 50,6 |
LACONIC-1B obtuvo 58,7, pero pertenece a otro grupo de tamaño: el modelo tiene 1.000 millones de parámetros.
En una comparación controlada con el mismo backbone y los mismos datos, LateOn obtuvo 58,9, DenseOn 57,9 y SPARSEUP 56,4. Los resultados del artículo indican una diferencia de 1,52 puntos con respecto a DenseOn y de 2,5 con respecto a LateOn.
SPARSEUP superó a DenseOn en ArguAna y HotpotQA, y también obtuvo mejores resultados en Touché. El modelo queda por detrás en conjuntos de datos con consultas más semánticas; la diferencia es especialmente notable en FiQA. DBPedia también se señala como un punto débil.
En BEIR sin contaminación, la diferencia con DenseOn se reduce a 0,17 puntos. Para NQ y MS MARCO sin contaminación se utilizaron solo 21 y 46 consultas, respectivamente, por lo que Linkup advierte que los resultados son ruidosos.
Dispersión y criterios de selección
En MS MARCO, SPARSEUP utiliza en promedio 47 términos no nulos por consulta y 190 por documento. Para SPLADE-v3, se indican 25 términos por consulta y 170 por documento.
Con el índice invertido Seismic, el modelo alcanza más del 97 % de recall respecto a la búsqueda exacta en aproximadamente 380 microsegundos por consulta en un único hilo.
SPARSEUP merece la pena si son importantes la representación dispersa y la búsqueda mediante un índice invertido. Al evaluarlo, también conviene tener en cuenta los resultados en los conjuntos de datos pertinentes: el modelo es más débil con consultas semánticas, FiQA y DBPedia.
Linkup considera que aumentar el tamaño del vector podría aportar entre 1 y 2 puntos en BEIR. El equipo decidió conservar la dispersión del modelo.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026