
SimTrace: trayectorias de clics sintéticas basadas en sesiones reales anonimizadas y en un modelo del entorno web
Los autores describen un marco que anonimiza interacciones reales, construye una réplica simulada del entorno web y, a partir de ella, genera trayectorias de clics multimodales con el contexto del usuario y observaciones del entorno. En un escenario de comercio electrónico, la solución superó a los métodos de referencia en 7 de 8 métricas de fidelidad, y los modelos entrenados con datos sintéticos mostraron una precisión comparable a la de los modelos entrenados con datos reales; además, añadir datos sintéticos aportó un +11,0 % en la predicción de la siguiente acción. El código está abierto a los investigadores.
Qué es SimTrace
SimTrace es un framework para generar trayectorias sintéticas multimodales de clics. Se basa en trayectorias reales de usuarios y en un entorno web definido. El artículo «SimTrace: Grounded Multimodal User Trajectories Generation for Online User Modeling» se presentó el 29 de septiembre de 2026. Autores: Yunan Lu, Shuang Xie, Meghna Allamudi, Mingyu Zhao, Han Li, Lingyun Wang y Zhou Yu. El trabajo está disponible en arXiv:2609.38397.
Elementos clave:
- generación de trayectorias sintéticas multimodales de clics;
- uso de trayectorias reales de usuarios;
- uso de un entorno web definido;
- anonimización de interacciones reales;
- copia simulada del entorno web;
- acompañamiento de cada acción con observaciones del entorno web y contexto del usuario.
Criterio práctico: el framework es adecuado para modelar el comportamiento de los usuarios en internet cuando se necesitan trayectorias sintéticas de clics.
Cómo funciona la generación de trayectorias sintéticas
SimTrace realiza la generación en varias etapas. Primero, el sistema anonimiza las interacciones reales. Después, crea una copia simulada del entorno web. A partir de estos datos, el framework genera trayectorias sintéticas. Cada acción de la trayectoria va acompañada de observaciones del entorno web y del contexto del usuario.
Etapas:
- Anonimización de interacciones reales.
- Creación de una copia simulada del entorno web.
- Generación de trayectorias sintéticas a partir de datos anonimizados y de la copia del entorno.
- Acompañamiento de cada acción con observaciones del entorno web y contexto del usuario.
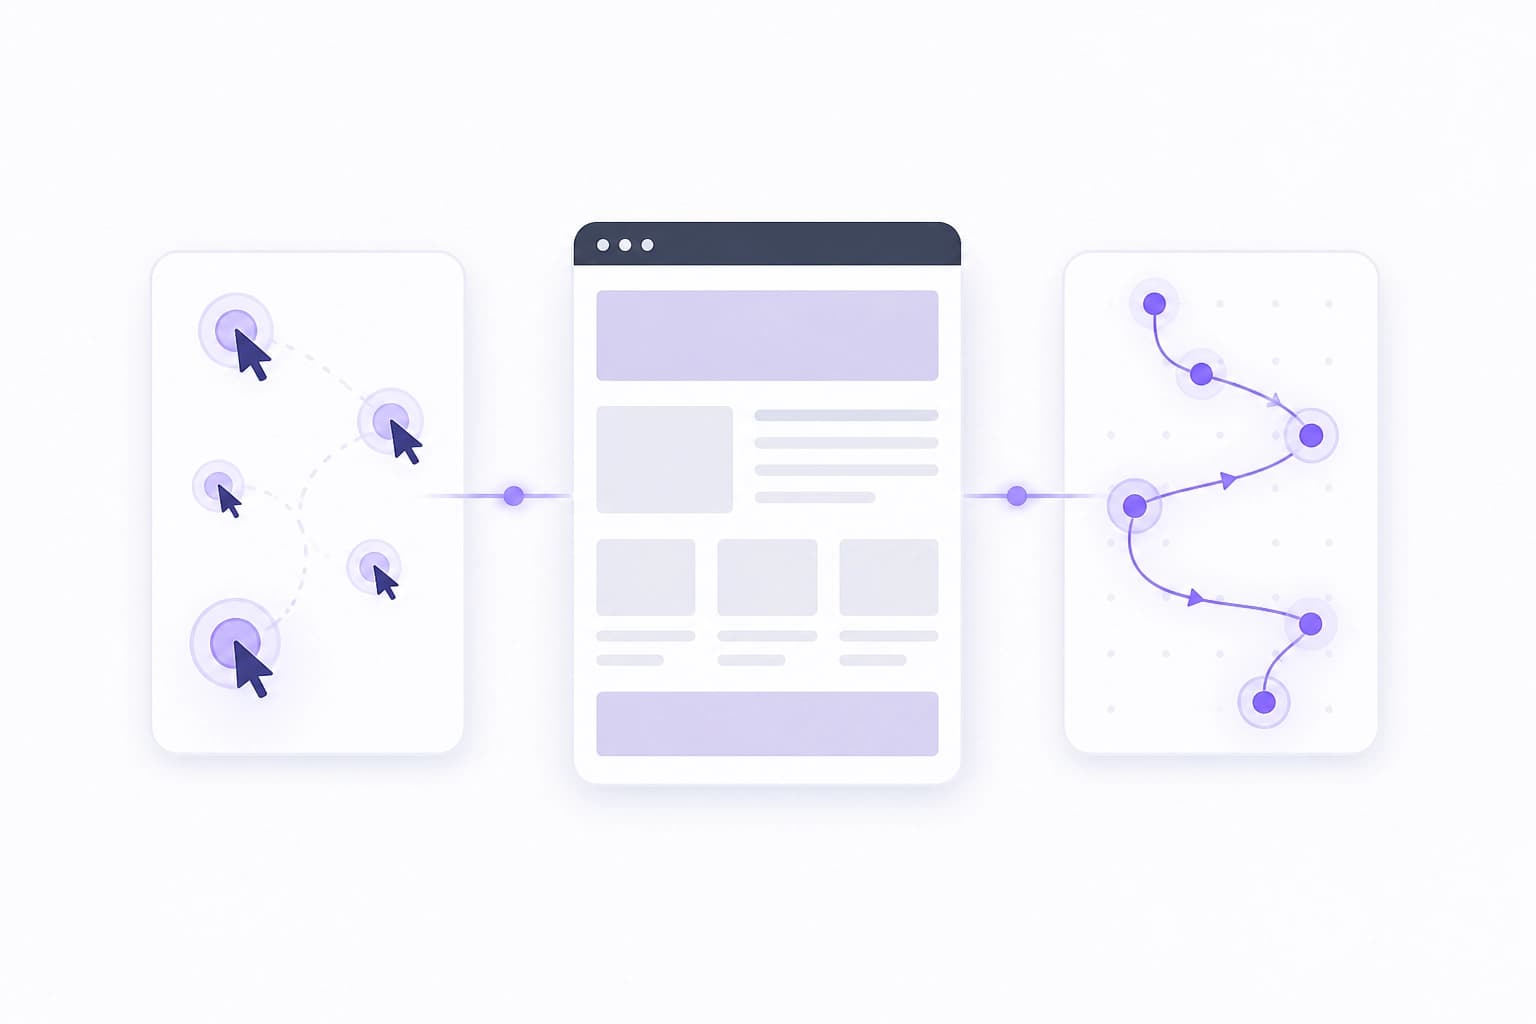
Criterio práctico: para iniciar la generación se necesitan sesiones reales anonimizadas y una descripción del entorno web.
Evaluación en el comercio electrónico
SimTrace se aplicó en un escenario de comercio electrónico. Los investigadores evaluaron la precisión de reproducción de los datos y la utilidad práctica. En 7 de las 8 métricas de precisión de reproducción, el sistema superó a los métodos de referencia competidores.
Conclusión: en el escenario de comercio electrónico, el framework muestra una ventaja en la mayoría de las métricas de precisión de reproducción.
Qué aportan los datos sintéticos a los modelos
En los experimentos de SimTrace, los modelos entrenados con datos sintéticos obtuvieron resultados comparables a los de los modelos entrenados con datos reales. Esto se aplica a las tareas de predicción de compra y recomendación. En la tarea de predicción de la siguiente acción, añadir datos sintéticos a los datos reales aumentó la precisión un 11.0% frente al entrenamiento solo con datos reales.
| Tarea | Resultado | | predicción de compra | los modelos con datos sintéticos son comparables a los modelos entrenados con datos reales | | recomendación | los modelos con datos sintéticos son comparables a los modelos entrenados con datos reales | | predicción de la siguiente acción | añadir datos sintéticos a los datos reales aumentó la precisión un 11.0% frente al uso exclusivo de datos reales |
Criterio práctico: las trayectorias sintéticas pueden usarse en lugar de las reales para la predicción de compra y la recomendación. Para la predicción de la siguiente acción, conviene añadirlas a los datos reales.
Código abierto y criterios de aplicación
SimTrace se publicó como un paquete de código abierto para investigar el modelado del comportamiento de los usuarios en internet. El paquete está disponible para tareas de investigación.
Criterio práctico: conviene utilizar el framework cuando la tarea esté relacionada con el modelado del comportamiento de los usuarios en internet. Para ello, se necesitan sesiones reales anonimizadas y un entorno web definido.
Conclusión: el código abierto permite acceder a la implementación del framework para investigación.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026